Сентябрь 2026 года ознаменовался резкой эскалацией ценовой войны среди ведущих разработчиков языковых моделей. Буквально в течение одних суток компания Anthropic представила флагманскую модель Claude Opus 5.5, а OpenAI ответила синхронным запуском семейства GPT-6 Sol и GPT-6 Luna. Для продуктовых команд и архитекторов мультиагентных систем эти релизы означают фундаментальный пересмотр себестоимости вычислений: рубеж цен на массовую обработку длинных контекстов рухнул в разы.
Наиболее агрессивный ценовой демпинг продемонстрировала OpenAI. Модель GPT-6 Luna стала вдвое дешевле предшественницы GPT-5.6 Luna и заняла позицию одной из самых доступных моделей за всю историю линейки. Входные токены тарифицируются по ставке $0,10 за миллион, чтение кэшированного контекста обходится всего в $0,01 за миллион, а выходные токены стоят $0,50 за миллион при контекстном окне объемом 1,05 миллиона токенов.
В среднем ценовом сегменте модель GPT-6 Sol ($2 за миллион входных токенов, $0,20 за кэш и $10 за выход) сравнялась по стоимости ввода с недавним релизом Grok 4.7 от xAI ($2 за вход и $6 за выход), сделав неактуальным использование промежуточных решений прошлого поколения.
Сдвиг в экономике агентных систем
Снижение тарифов на базовую генерацию важно, но главным экономическим драйвером стал обвал цен на чтение кэшированного контекста (cached input tokens). В Anthropic снизили базовые расценки Opus 5.5 на 20% — до $4 за вход и $20 за выход, однако стоимость кэша упала сразу на 60% — с $0,50 до $0,20 за миллион токенов.
В реальных агентных конвейерах, где модель на каждом шаге перечитывает длинную историю диалога, системные инструкции, документацию и результаты предыдущих вызовов инструментов, более 90% входного потока обрабатывается именно по тарифам кэша. Возможность удерживать в активной памяти тяжелый контекст при ставке $0,20 за миллион токенов для флагманского интеллекта уровня Opus 5.5 или $0,01 для GPT-6 Luna переводит непрерывную агентную автоматизацию из разряда дорогих корпоративных экспериментов в повседневный стандарт разработки.
Парадокс чрезмерных рассуждений в Opus 5.5
Однако рост интеллектуальной мощности моделей reasoning-класса породил неожиданный архитектурный сбой. Независимый исследователь Саймон Уиллисон при тестировании Claude Opus 5.5 обнаружил критическую уязвимость логики на максимальном уровне рассуждений («max effort»).
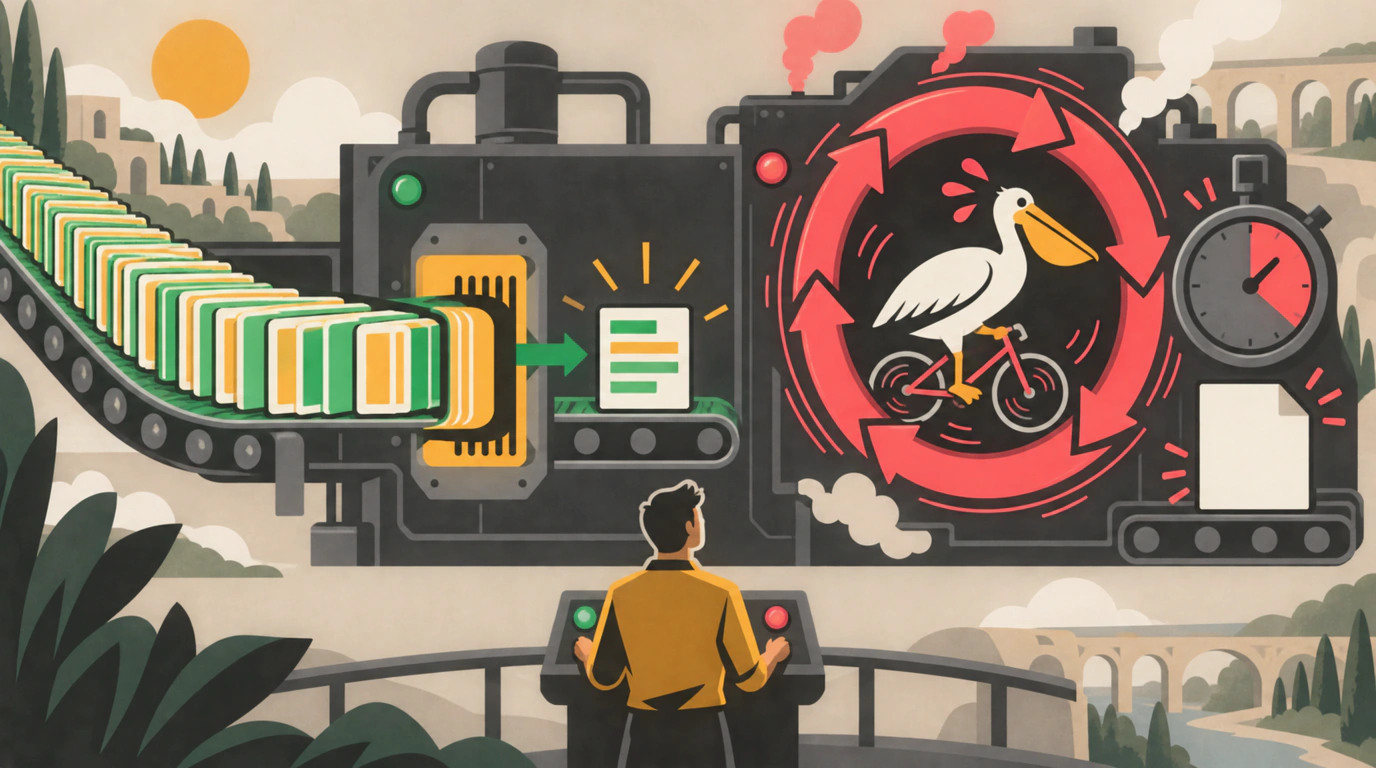
На классическом синтетическом задании по генерации векторной иллюстрации пеликана на велосипеде в формате SVG модель на максимальной глубине мышления впала в бесконечный внутренний монолог. Opus 5.5 начал гипердетально планировать анатомию птицы, вычислять координаты каждого пера, угол наклона педалей и спиц колес, перепроверять соотношение пропорций и выверять синтаксис разметки. В результате модель исчерпала системный лимит генерации в 128 000 выходных токенов исключительно на внутренние рассуждения и завершила сессию аварийной ошибкой по тайм-ауту, не вернув ни единой строчки итогового SVG-кода.
Повторный запуск привел к точно такому же результату. Каждый из двух неудачных запросов занял около 20 минут времени инференса и обошелся в $2,56 сожженных токенов при нулевом полезном результате. При этом более тяжелая флагманская модель Claude Fable 5.1 успешно справилась с аналогичным заданием на максимальной глубине без ухода в бесконечный цикл.
Практические выводы для разработчиков
Выявленный сбой зацикливания рассуждений диктует новые правила проектирования агентных систем:
- Максимальный уровень рассуждений («max effort») в современных флагманах опасен для продакшена без жестких программных предохранителей: его нельзя использовать по умолчанию на слабо формализованных творческих или графических задачах;
- Любой вызов reasoning-моделей должен сопровождаться серверными лимитами бюджета токенов генерации (
max_tokens) и строгими таймаутами на стороне клиента; - Оптимальной стратегией становится гибридный роутинг: первичная классификация запросов, рутинные трансформации данных и подготовка контекста поручаются сверхдешевой GPT-6 Luna, тогда как Opus 5.5 или Fable 5.1 привлекаются на среднем уровне рассуждений (
medium effort) исключительно для финального аналитического синтеза.