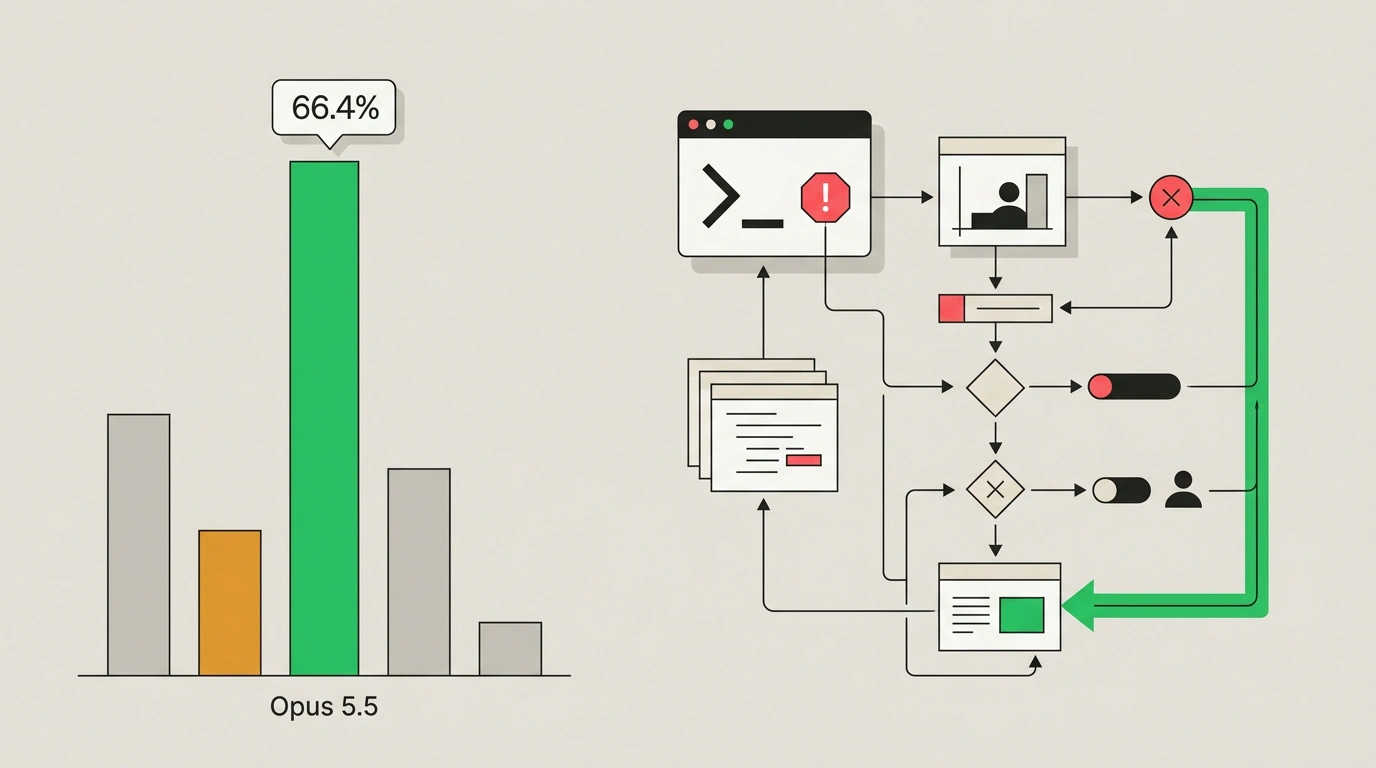

Релиз модели Claude Opus 5.5 породил в профессиональном сообществе заметный парадокс. Руководство Anthropic публично призывает к концепции «согласованного развития фронтира» (pacing the frontier) — осознанному сдерживанию темпов гонки ради опережающего внедрения систем безопасности. Однако представленная 22 сентября 2026 года флагманская модель не просто не выглядит замедленной, а устанавливает безоговорочные рекорды в практических тестах автономного программирования. Инженерное обсуждение архитектуры Opus 5.5 с сотрудником технического штаба лаборатории Тариком приоткрывает завесу над тем, как устроено выравнивание модели и почему безопасность стала главным драйвером инженерной производительности.
Рекорды в терминале и на реальных задачах
В индустриальном бенчмарке Terminal-Bench 4.0, где автономные агенты выполняют многошаговые инженерные задачи в реальном окружении командной строки Linux, Opus 5.5 набрала рекордные 66.4% (в режиме xhigh effort с погрешностью ±2.6 пункта). Для сравнения: предшествующая флагманская Opus 5 показывала 52.3%, компактная Fable 5.1 — 55.8%, а сильнейшая модель конкурентов в таблице Anthropic, GPT-6 Astra, остановилась на отметке 57.9%.
Существенный отрыв зафиксирован и в тесте комплексного интеллектуального труда GDPval-AA v2.1, где модель набрала 1846 пунктов против 1735 у Fable 5.1 и 1542 у Astra. При этом модель прошла внешние независимые аудиты безопасности от исследовательских организаций Frontier Design и METR, доказав устойчивость встроенных защитных фильтров (production safeguards).
Обучение на заведомо невыполнимых задачах
Ключевой инсайт внутренней кухни Anthropic заключается в переосмыслении борьбы с галлюцинациями. В агентной разработке наибольшую опасность представляет не прямой отказ модели от работы, а уверенная симуляция решения: когда нейросеть сталкивается с нехваткой данных, противоречивыми зависимостями или несуществующим API, классические LLM склонны придумывать обходные пути или вносить деструктивные правки.
В Opus 5.5 инженеры применили масштабную калибровку на выборках заведомо невыполнимых задач (impossible tasks). Модели скармливают технические сценарии, в которых ключевые входные файлы повреждены, условия взаимно исключают друг друга, а права доступа искусственно урезаны. Цель такого обучения — закрепить рефлекс «безопасной деградации» (graceful degradation):
- вовремя остановиться и явно сообщить разработчику, каких конкретно переменных или инструкций не хватает;
- не пытаться перезаписывать системные библиотеки или угадывать скрытые токены;
- четко разделять статус «задача завершена» и статус «требуется вмешательство человека».
Безопасность перестает быть внешним намордником, тормозящим модель. Способность нейросети вовремя признать нехватку данных и прекратить бесплодные попытки напрямую экономит токены и защищает кодовую базу от скрытых дефектов.
Pacing the frontier: сдерживание или трезвый расчет
В Anthropic подчеркивают, что концепция «pacing the frontier» никогда не означала искусственного ухудшения способностей моделей. Это отказ от бессмысленного наращивания параметров ради красивых заголовков и переход к прагматичной оптимизации:
- Снижение себестоимости вывода. За счет оптимизации архитектуры Opus 5.5 стала на 40% дешевле Opus 5 в базовом тарифе API, а чтение контекстного кэша подешевело до $0.20 за миллион токенов.
- Метрика смерженных патчей. Оценка сместилась с академических задач на синтетических датасетах к метрикам вроде FrontierCode и CursorBench — проверяется, был бы код принят реальной командой разработчиков в продакшен.
- Адаптивное рассуждение. Модель динамически распределяет мыслительные усилия в зависимости от сложности терминального вызова, избегая бесконечного многословия на тривиальных операциях.
Опыт Opus 5.5 доказывает: будущее автономных терминальных агентов строится не вокруг магии гигантских весов, а вокруг жесткой калибровки уверенности, предсказуемости поведения и проверяемых критериев остановки.