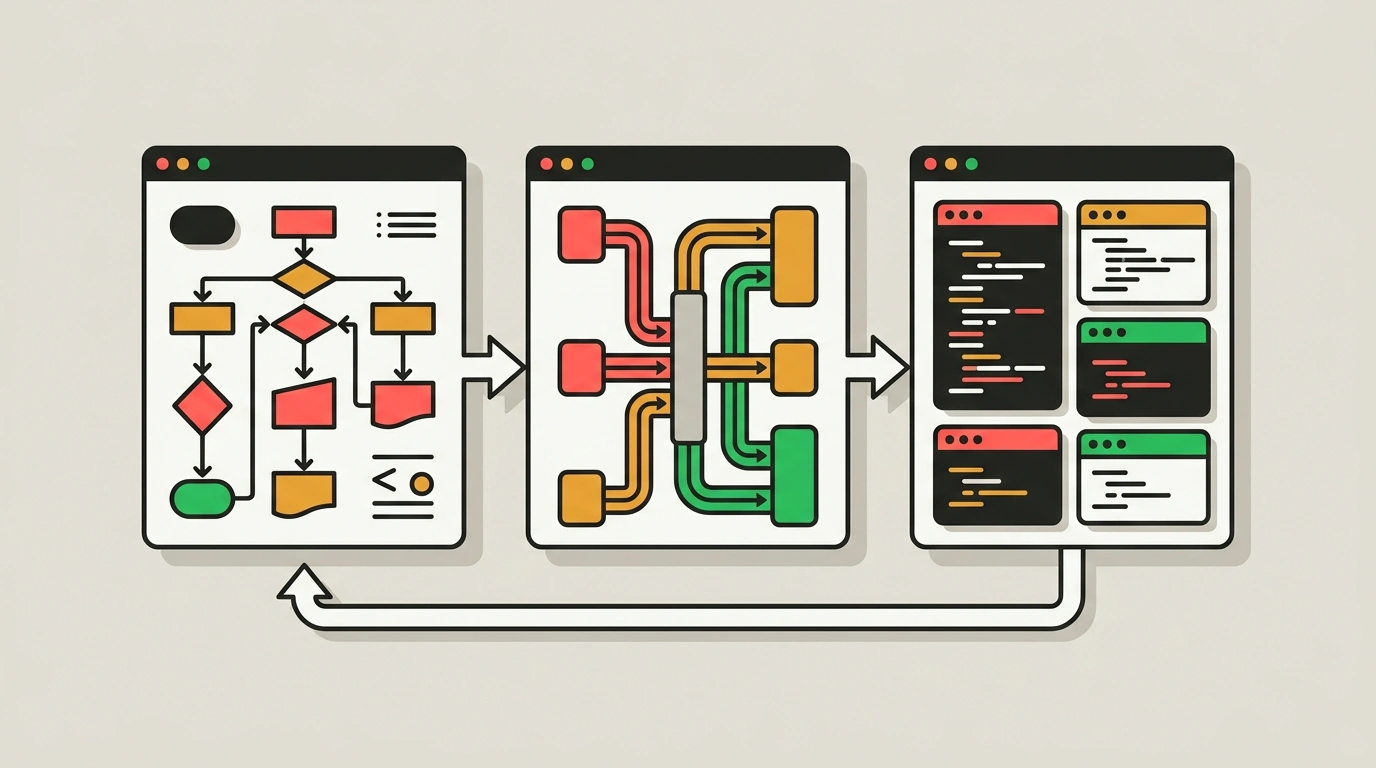

Непрерывная разработка с использованием автономных кодинг-агентов быстро выявила слабое место коммерческих подписок: пятичасовые и недельные квоты запросов. При интенсивной работе над кодовой базой лимиты исчерпываются за несколько часов, блокируя процесс до следующего расчетного окна.
Разработчик Коул Медин столкнулся с этой проблемой при трехдневном спринте и предложил архитектурный паттерн разделения труда: «Большая модель планирует, маленькая модель строит» (Big Model Plans, Small Model Builds).
Суть подхода заключается в отказе от мономодельной схемы. Использовать флагманскую модель стоимостью 50 долларов за миллион токенов для написания однотипных геттеров, интерфейсов или стилей экономически расточительно. Вместо этого в конвейер внедряются две модели с разной специализацией:
- Архитектор и рецензент: GPT-6 Astra берет на себя верхнеуровневый анализ архитектуры, декомпозицию задачи на мелкие шаги и финальный аудит сформированного кода.
- Построчный кодер: открытая легковесная модель GLM 5.3 Flash отвечает за рутинное написание кода, генерацию тестов и устранение синтаксических ошибок.
Маршрутизация через единый шлюз Neon AI Gateway
Для взаимодействия с открытой моделью без развертывания тяжелой серверной инфраструктуры используется сервис Neon AI Gateway. Он предоставляет совместимый с OpenAI API интерфейс доступа к открытым нейросетям с посекундной тарификацией по фактической себестоимости инференса.
import os
from openai import OpenAI

# Клиент для высокоинтеллектуального планирования через OpenAI
planner = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))

# Клиент для скоростной кодогенерации через Neon AI Gateway
coder = OpenAI(
    base_url="https://gateway.neon.tech/v1",
    api_key=os.getenv("NEON_GATEWAY_KEY")
)

def create_architecture_plan(task_prompt: str) -> str:
    """GPT-6 Astra создает пошаговую спецификацию реализации."""
    response = planner.chat.completions.create(
        model="gpt-6-astra",
        messages=[
            {"role": "system", "content": "Ты системный архитектор. Разбей задачу на атомарные функции."},
            {"role": "user", "content": task_prompt}
        ]
    )
    return response.choices[0].message.content

def implement_function_code(function_spec: str) -> str:
    """GLM 5.3 Flash быстро пишет чистый код по переданной спецификации."""
    response = coder.chat.completions.create(
        model="glm-5.3-flash",
        messages=[
            {"role": "system", "content": "Ты исполнитель кода. Пиши только чистый код без вступительных слов."},
            {"role": "user", "content": function_spec}
        ]
    )
    return response.choices[0].message.content
Такое разделение позволяет сохранить токены дорогой подписки Astra только для сложных интеллектуальных рассуждений.
Оркестрация гибридного цикла разработки
После генерации кода легковесной моделью результат передается обратно во флагманскую систему для проверки граничных условий и запуска автоматических тестов.
def run_hybrid_coding_pipeline(feature_description: str) -> dict:
    # Шаг 1. Глубокое архитектурное проектирование флагманом
    plan = create_architecture_plan(feature_description)

    # Шаг 2. Быстрое написание функционального блока открытой моделью
    generated_code = implement_function_code(plan)

    # Шаг 3. Финальный аудит безопасности и соответствия типам через Astra
    audit_response = planner.chat.completions.create(
        model="gpt-6-astra",
        messages=[
            {"role": "system", "content": "Проверь код на утечки ресурсов и краевые условия."},
            {"role": "user", "content": f"Спецификация:\n{plan}\n\nКод:\n{generated_code}"}
        ]
    )

    return {
        "plan": plan,
        "code": generated_code,
        "review": audit_response.choices[0].message.content
    }
Применение связки снижает суммарную стоимость кодогенерации примерно в четыре раза по сравнению с монопольным использованием Astra, полностью снимая риск блокировки рабочего процесса из-за исчерпания часовых квот.
Гибридный подход превращает ИИ-кодинг из непредсказуемой подписки в надежный инженерный инструмент с фиксированной себестоимостью.