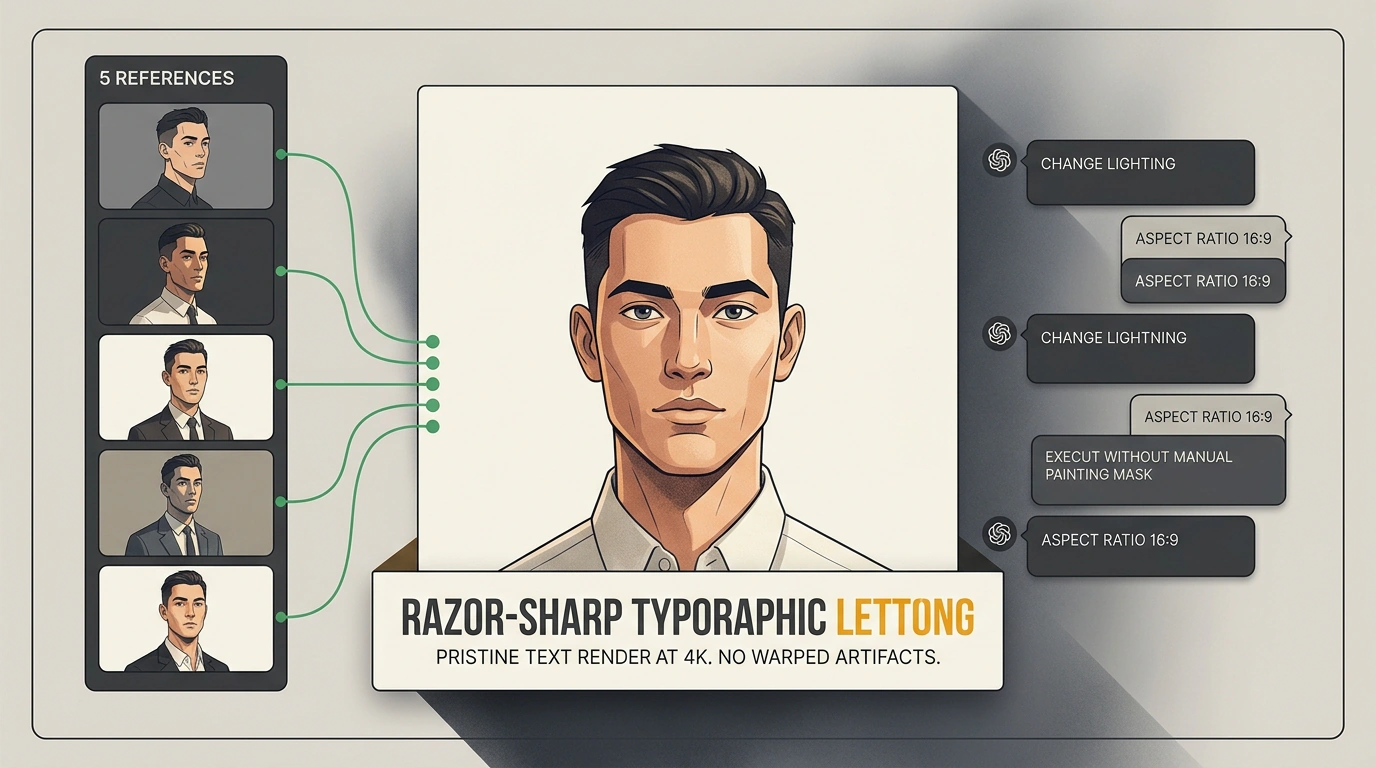

Создание графического контента для коммерческих проектов долгое время упиралось в две фундаментальные проблемы генеративных диффузионных сетей: потерю визуальной идентичности персонажей и неспособность аккуратно выводить текст на плакатах и баннерах. Стоило изменить позу героя или перевести изображение из формата 16:9 в вертикальный 9:16, как черты лица безвозвратно менялись, а надписи превращались в бессмысленный набор смазанных глифов. Превью модели Hunyuan Image 3.5 от корпорации Tencent предлагает решение обеих проблем, объединяя мультиреференсное кондиционирование и диалоговый инпеинтинг.
Механику работы обновленной модели можно сравнить с работой профессионального ретушера в фотостудии: вместо того чтобы рисовать кадр с нуля при каждом уточнении клиента, алгоритм держит перед собой серию эталонных снимков модели и вносит точечные коррективы в уже существующий макет.
Проблема блуждающих лиц: почему генераторам сложно удерживать стиль
Классические визуальные нейросети воспринимают каждый промпт изолированно. Даже если разработчик добавляет имя персонажа или пытается зафиксировать сид генерации, любое дополнительное слово в запросе смещает траекторию диффузии в латентном пространстве. В результате коммерческий бренд не мог создать серию рекламных креативов с одним и тем же амбассадором без привлечения сложных сторонних надстроек вроде LoRA или ControlNet.
В Tencent Hunyuan Image 3.5 эта задача решена на уровне архитектуры модели. По результатам внутренних слепых тестов Tencent с участием сотен профессиональных дизайнеров, качество генерации выросло на тридцать процентов по сравнению с версией 3.0. Модель научилась не просто улавливать общую цветовую гамму, но и детально переносить пропорции лица, текстуру кожи и узнаваемые элементы брендинга из эталонных образцов.
Пять опорных точек: как мультиреференсный каркас фиксирует персонажа
Ключевым новшеством стала поддержка мультиреференсного кондиционирования (Multi-reference Conditioning). В графическом интерфейсе пользователь может одновременно загрузить до пяти изображений-референсов (а в расширенном корпоративном API — до двадцати источников), формирующих жесткий стилевой якорь.
Такой подход позволяет передавать модели комплексный контекст:
- Первый референс фиксирует анатомические черты лица и прическу персонажа.
- Второй определяет геометрию фирменного продукта или упаковки.
- Третий и последующие задают цветовую палитру освещения и общую композиционную стилистику фотосессии.
В процессе генерации внимание модели распределяется между текстовым описанием сцены и визуальными эмбеддингами референсов. Персонаж сохраняет безупречную узнаваемость независимо от выбранного ракурса, дистанции съемки или динамики движения.
Диалоговое преображение: точечные правки без масок в Photoshop
Второе значимое преимущество версии 3.5 — полноценная поддержка многошагового диалогового редактирования (Conversational Multi-turn Editing). Традиционный процесс доработки сгенерированной иллюстрации требовал экспорта в Photoshop, ручного рисования черно-белых масок инпеинтинга и мучительного подбора текстовых формулировок.
В Hunyuan Image 3.5 общение с моделью строится в виде последовательного чата. Пользователь может отправить команду: «Замени цвет пиджака на темно-синий и поверни камеру чуть правее», после чего нейросеть сохраняет все остальные элементы кадра неизменными. Более того, модель легко меняет соотношение сторон: горизонтальная заставка для десктопного сайта мгновенно достраивается в вертикальный формат для мобильных экранов с естественным продолжением фона.
Четкие надписи и коммерческий рендеринг: преодоление графического шума
Отдельный прорыв достигнут в рендеринге типографики. Hunyuan Image 3.5 точно воспроизводит текстовые блоки на китайском и английском языках, прорисовывая четкие засечки букв, тени и правильную перспективу на вывесках, обложках журналов и товарных этикетках.
Изображения генерируются в разрешениях 2K и 4K (вплоть до 4096x4096 пикселей) без необходимости применения сторонних апскейлеров. Доступ к модели открыт через облачный API Tencent Cloud под идентификатором hy-image-v3.5-preview. Обработка запросов происходит в синхронном режиме по цене около $0.024 за изображение, что позволяет легко интегрировать модель в автоматизированные конвейеры e-commerce и маркетинговых агентств без ожидания в асинхронных очередях.