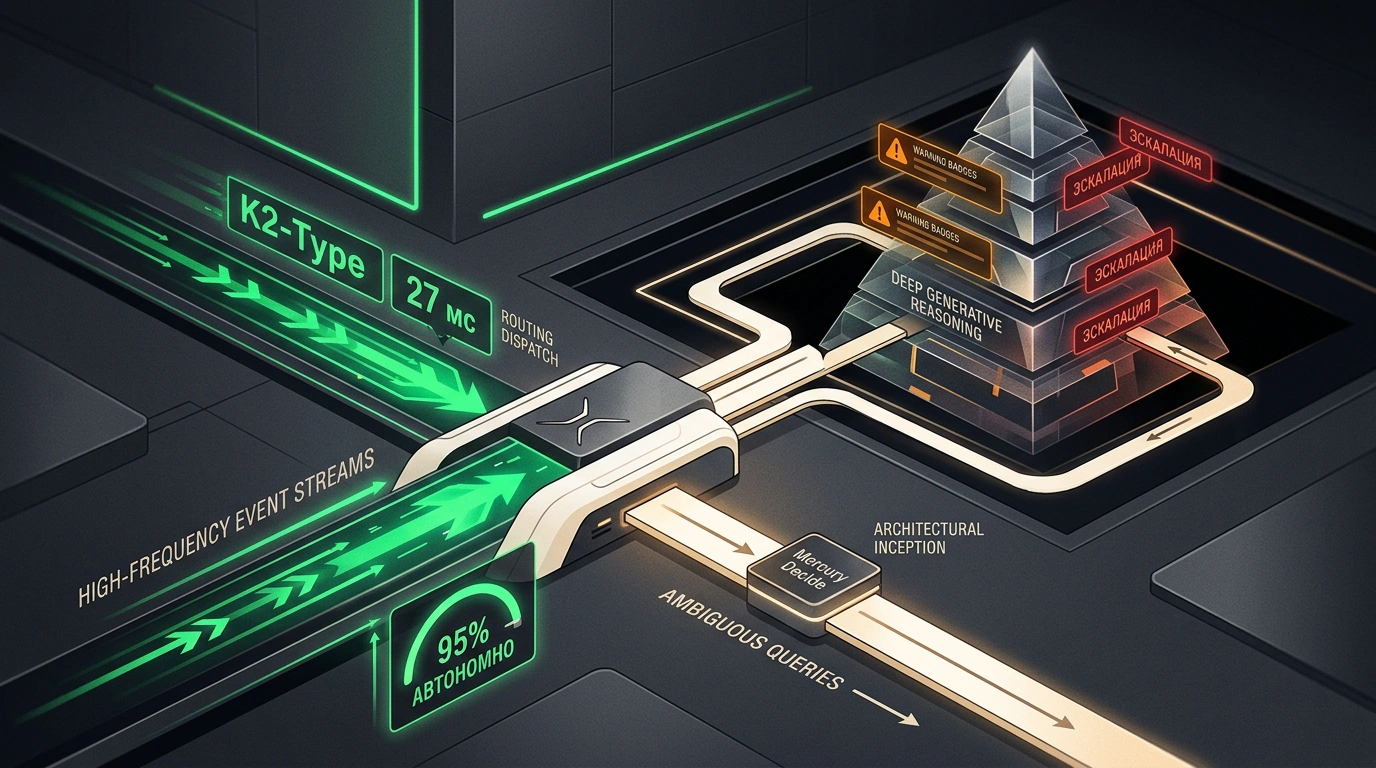
Когда разработчики проектируют автономных цифровых помощников, они часто попадают в ловушку избыточной мощности. Представьте, что для включения настольной лампы или сортировки писем в почтовом ящике к вам каждый раз приезжает бригада академиков, которые перед нажатием выключателя пишут подробное эссе с обоснованием физических законов преломления света. Именно так выглядит классический агент на базе универсальных больших языковых моделей: чтобы принять простейшее бинарное решение — выбрать инструмент или отфильтровать входящий запрос, — тяжеловесная нейросеть тратит секунды драгоценного времени и миллионы токенов на рассуждения.
В индустрии искусственного интеллекта оформился фундаментальный архитектурный сдвиг: разделение когнитивных функций на быструю интуитивную реакцию (System 1) и глубокие размышления (System 2). Рутинную диспетчеризацию шагов, триаж событий и валидацию данных все чаще передают компактным «моделям решений» (decision models). Они отказываются от посимвольной генерации текста в пользу прямого вычисления вероятностей классов, снижая задержку отклика до десятков миллисекунд.
K2-Type-0.9B
Первым ярким представителем нового класса специализированных классификаторов стала модель K2-Type-0.9B, разработанная Институтом фундаментальных моделей (Institute of Foundation Models, IFM) и опубликованная под свободной лицензией Apache 2.0 на Hugging Face. Ее архитектура спроектирована исключительно для типизированных решений (typed decisions).
В отличие от стандартных авторегрессионных генераторов, K2-Type не запускает тяжелый цикл последовательного декодирования токенов. Модель выполняет единственный прямой проход (single forward pass) по входному тексту и сразу возвращает вектор логитов по заранее заданным категориям действий. На современных графических ускорителях время инференса составляет рекордные 27 миллисекунд. Это позволяет встраивать модель в циклы высокочастотной обработки потоковых событий — например, для мгновенной фильтрации сотен входящих пользовательских обращений без образования серверных очередей.
Для интеграции K2-Type-0.9B в контур локальной обработки используется стандартная библиотека Transformers, позволяющая извлекать вероятности за доли секунды:
import torch
from transformers import AutoModelForSequenceClassification, AutoTokenizer

# Загрузка легковесной модели решений K2-Type-0.9B с Hugging Face
model_id = "IFM/K2-Type-0.9B"
tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoModelForSequenceClassification.from_pretrained(model_id)

# Входное событие: запрос клиента на отмену услуги
incoming_event = "Пользователь запрашивает немедленный возврат средств по чеку #8492 в связи с отказом."
inputs = tokenizer(incoming_event, return_tensors="pt")

# Быстрый прямой проход без декодирования авторегрессионного текста
with torch.no_grad():
    logits = model(**inputs).logits
    probabilities = torch.softmax(logits, dim=-1)

# Определение категории маршрутизации и калиброванной уверенности
predicted_class = torch.argmax(probabilities).item()
confidence = probabilities[0][predicted_class].item()

print(f"Класс действия: {predicted_class}, Достоверность: {confidence:.4f}")
Mercury Decide
Если K2-Type решает задачи первичного триажа на уровне микросервисов, то модель Mercury Decide от компании Inception берет на себя роль интеллектуального диспетчера в сложных агентных контурах. Модель оптимизирована под скорость до 14 решений в секунду при поддержке контекстного окна до 33 000 токенов, что позволяет передавать ей подробную историю предыдущих шагов диалога.
Главное преимущество Mercury Decide — встроенная математическая калибровка уверенности (calibrated confidence score). Большинство обычных нейросетей склонны к сверхуверенности: они могут выдавать ошибочный ответ с формальной вероятностью 99%. Mercury Decide обучена объективно оценивать границы собственной компетентности. Это открывает дорогу к надежной трехуровневой архитектуре безопасности:
- При показателе уверенности свыше 95% агент исполняет действие полностью автономно.
- В диапазоне от 70% до 95% система передает контекст тяжелой генеративной модели для перепроверки.
- Если уверенность падает ниже 70%, выполнение блокируется, а задача эскалируется живому оператору.
Интеграция с Mercury Decide через эндпоинт OpenRouter обеспечивает получение строгого детерминированного JSON-решения:
import os
import requests

api_url = "https://openrouter.ai/api/v1/chat/completions"
headers = {
    "Authorization": f"Bearer {os.environ.get('OPENROUTER_API_KEY', 'demo-key')}",
    "Content-Type": "application/json"
}

# Формирование строгого классификационного промпта без лишней генерации
payload = {
    "model": "inception/mercury-decide",
    "messages": [
        {
            "role": "system",
            "content": "Определите статус операции: [EXECUTE, ESCALATE, REJECT] и верните confidence."
        },
        {
            "role": "user",
            "content": "Обнаружена попытка удаления базы данных без подтверждения root-доступа."
        }
    ],
    "response_format": {"type": "json_object"}
}

response = requests.post(api_url, json=payload, headers=headers).json()
decision_payload = response["choices"][0]["message"]["content"]
print("Решение агентного диспетчера:", decision_payload)
Разделение труда между быстрыми классификаторами и медленными генеративными мыслителями знаменует переход ИИ-разработки на инженерные рельсы. Использование K2-Type-0.9B и Mercury Decide снижает расходы на вызовы API в тридцать-пятьдесят раз, устраняет фатальные галлюцинации при выборе инструментов и превращает неуклюжих чат-ботов в предсказуемые, отзывчивые автоматизированные системы.