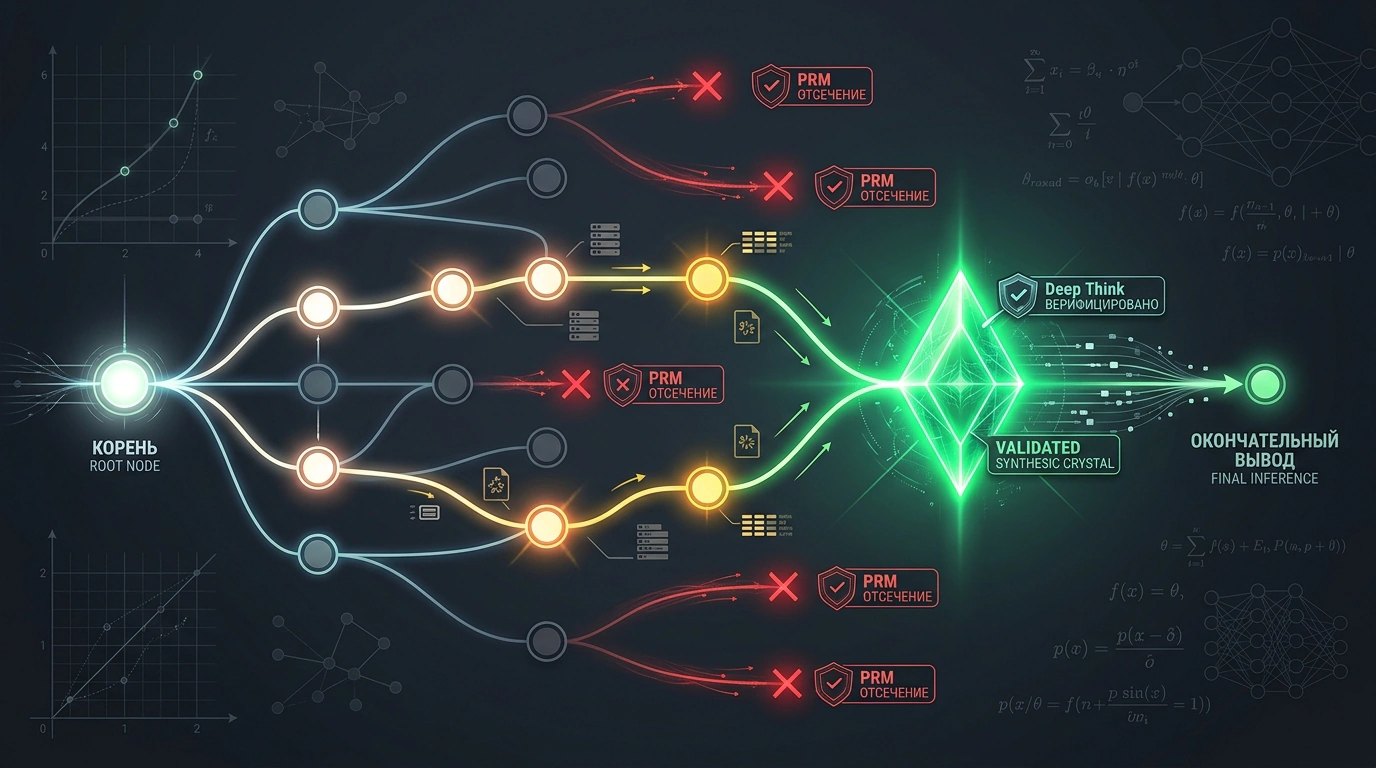

Классический подход к рассуждениям в больших языковых моделях напоминает движение по канату с закрытыми глазами: если нейросеть оступилась на втором шаге длинной логической цепочки, все последующие выводы неизбежно летят в пропасть. Стандартный метод Chain-of-Thought (цепочка мыслей) генерирует рассуждения строго последовательно, токен за токеном. Модель выбирает наиболее вероятное следующее слово, не имея возможности вернуться назад, оценить тупиковый маршрут или сопоставить альтернативные гипотезы.
Чтобы преодолеть это ограничение, Google DeepMind представила режим Gemini Deep Think (Thinking Mode), ставший доступным для подписчиков Google AI Pro и корпоративных пользователей платформы Vertex AI. В основе технологии лежит масштабирование вычислений на этапе инференса (test-time compute scaling) через параллельное ветвление логических траекторий.
Архитектура ветвления: от прямой линии к дереву решений
Вместо жадного пошагового декодирования Deep Think разворачивает полноценное дерево поиска возможных решений. Столкнувшись со сложной аналитической задачей, система параллельно генерирует несколько независимых веток доказательств.
Ключевым механизмом фильтрации служат модели оценки процесса (Process Reward Models, PRM). В отличие от стандартных функций вознаграждения, которые оценивают только финальный ответ («правильно/неправильно»), PRM верифицируют каждый отдельный промежуточный шаг рассуждения. Если в одной из веток нарушается математический инвариант или логическое правило, эта ветвь немедленно отсекается. Модель отбирает наиболее согласованную траекторию или синтезирует итоговое решение на стыке нескольких успешно проверенных гипотез.
Такой подход качественным образом меняет точность в олимпиадных дисциплинах. На задачах уровня Международной математической олимпиады (IMO), геометрических доказательствах и формальной верификации криптографических протоколов Deep Think демонстрирует резкое снижение процента галлюцинаций.
Практическое применение в разработке и архитектуре
Для программных инженеров параллельное рассуждение открывает новые горизонты в решении нетривиальных задач:
- Поиск состояний гонки (Race Conditions). Параллельные ветки модели независимо исследуют сценарии асинхронного доступа к общим ресурсам в многопоточном коде, моделируя нетипичные задержки ввода-вывода.
- Аудит безопасности и смарт-контрактов. Модель целенаправленно ищет контрпримеры к объявленным инвариантам системы, пытаясь воспроизвести сценарии повторного входа (reentrancy) или переполнения стека.
- Оптимизация сложных аналитических запросов. При проектировании распределенных баз данных Deep Think сопоставляет различные планы выполнения SQL-запросов и схем шардирования.
Компромиссы: время ожидания и бюджет вычислений
Параллельные вычисления требуют значительных ресурсов ускорителей TPU. Это накладывает два практических ограничения.
Во-первых, увеличивается задержка отклика: в зависимости от установленного бюджета рассуждений (thinking budget) формирование ответа занимает от пяти до сорока пяти секунд. Во-вторых, Google жестко лимитирует квоты обращений в сутки даже для премиальных аккаунтов.
Deep Think — это специализированный инструмент для аналитического штурма. Использовать его для создания писем или поиска простых фактов бессмысленно, но в задачах, где цена логической ошибки высока, параллельный перебор гипотез обеспечивает непревзойденную надежность.