Организация семантического поиска по корпоративным документам, личным фотографиям и голосовым заметкам до сих пор упиралась в дилемму конфиденциальности. Передавать финансовые отчеты и конфиденциальные архивы во внешние облачные API рискованно, а поднимать тяжелые локальные нейросети требует мощных серверов с десятками гигабайт видеопамяти.
Google DeepMind предложила элегантное решение, опубликовав открытую модель EmbeddingGemma 2 под свободной коммерческой лицензией Apache 2.0. При суммарном весе всего в 740 млн параметров модель умеет проецировать разнородные типы данных — текст, фрагменты программного кода, фотографии и аудиодорожки — в единое смысловое векторное пространство прямо на пользовательском ноутбуке или мобильном устройстве.
Приватный поиск без отправки файлов на чужие серверы
Архитектура EmbeddingGemma 2 скомпонована из трех специализированных энкодеров: текстового (270M параметров), визуального (170M) и звукового (300M). Все они калибруются так, чтобы вектор текстового запроса «квитанция за аренду с синей печатью» оказывался рядом с вектором соответствующей фотографии или аудиосообщения.
Благодаря расширению контекстного окна до 8 192 токенов (вчетверо больше, чем в первой версии линейки), в один запрос можно упаковывать целые разделы технической документации, до 29 изображений или аудиозапись длительностью до пяти с половиной минут. При этом квантованная текстовая версия занимает в оперативной памяти скромные 191 МБ, а полный мультимодальный пакет требует всего около 567 МБ RAM.
Матрешечные векторы: как усечь размер базы в шесть раз
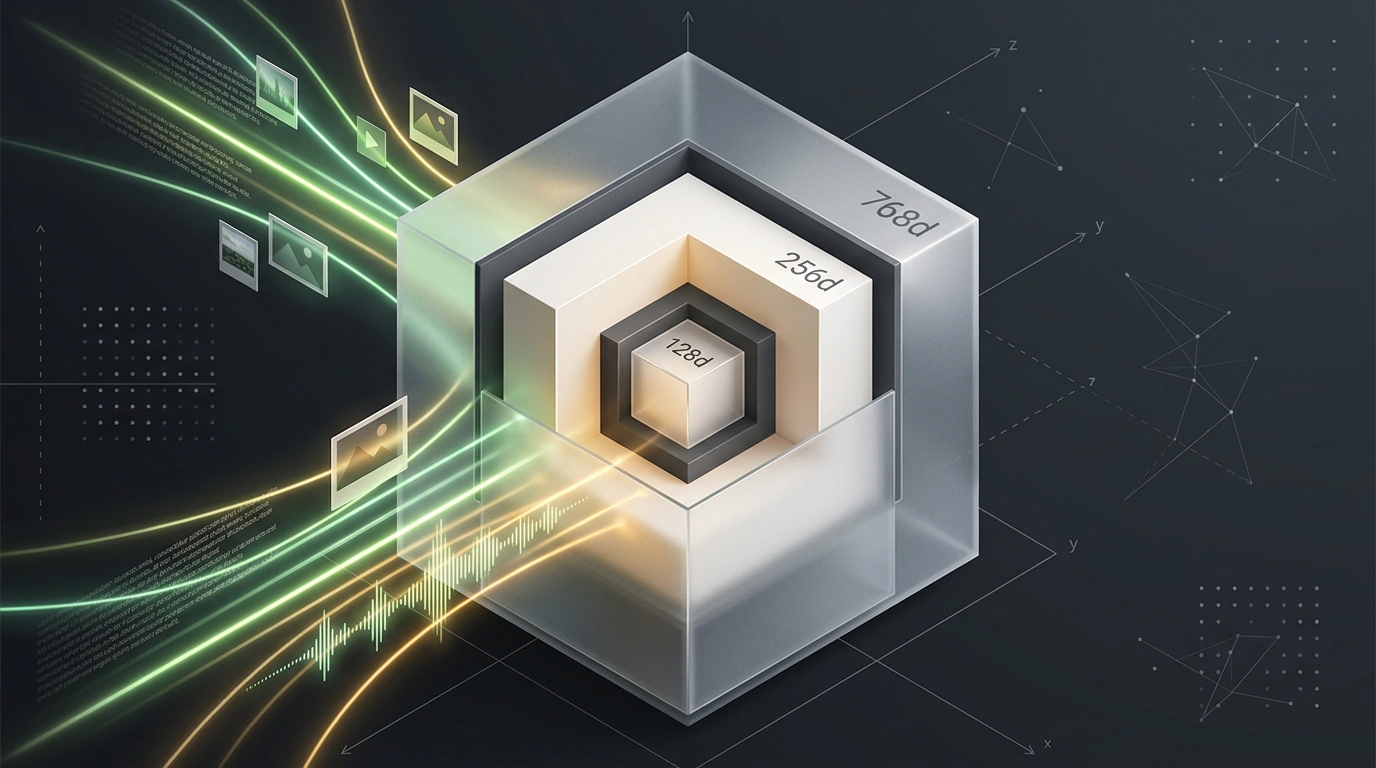
Ключевое технологическое преимущество модели — встроенная поддержка матрешечных эмбеддингов (Matryoshka Representation Learning, MRL). В стандартных поисковых системах вектор размерностью 768 чисел хранится целиком, раздувая индексы векторных баз данных (Qdrant, pgvector, Chroma) до десятков гигабайт.
Матрешечная архитектура упаковывает наиболее фундаментальные смысловые признаки в первые координаты вектора. Инженер может безболезненно отрезать «хвост» вектора, оставив вместо 768 измерений лишь 256 или 128. Размер индекса в памяти сокращается в шесть раз, а точность ранжирования документов сохраняется на уровне 94% от исходной.
Развертывание в Ollama и расчет сжатых векторов
Модель доступна для мгновенного развертывания через локальные окружения Ollama и LM Studio:
# Загрузка и локальный запуск модели через консоль Ollama
ollama pull embedding-gemma
ollama run embedding-gemma
После инициализации локального инференса построение векторов и их сжатие реализуется несколькими строками кода на Python:
from sentence_transformers import SentenceTransformer
import numpy as np

# Инициализация модели из репозитория Hugging Face
model = SentenceTransformer("google/embeddinggemma-2")

corpus = [
    "Приватный поиск по внутренней документации без отправки файлов в облако",
    "Технология Matryoshka embeddings сокращает индекс базы данных в 6 раз"
]

# Получение полных 768-мерных векторов
raw_embeddings = model.encode(corpus)

# Усечение до 128 измерений и повторная L2-нормализация
truncated_128 = raw_embeddings[:, :128]
normalized_128 = truncated_128 / np.linalg.norm(truncated_128, axis=1, keepdims=True)

print(f"Исходная длина вектора: {raw_embeddings.shape[1]}")
print(f"Сжатая длина вектора: {normalized_128.shape[1]}")
Практический вердикт для локального RAG
EmbeddingGemma 2 снимает барьеры для создания по-настоящему приватных поисковых систем (on-device RAG). Инженеры получают инструмент, не требующий ежемесячных подписок и полностью независимый от стабильности интернет-соединения.
Небольшая потеря точности при сжатии до 128 измерений заметна лишь на очень редкой профессиональной терминологии. Для большинства задач поиска по документам, скриншотам и архивам заметок 256- или 128-мерных векторов оказывается более чем достаточно, что делает модель идеальной основой для персональных баз знаний нового поколения.