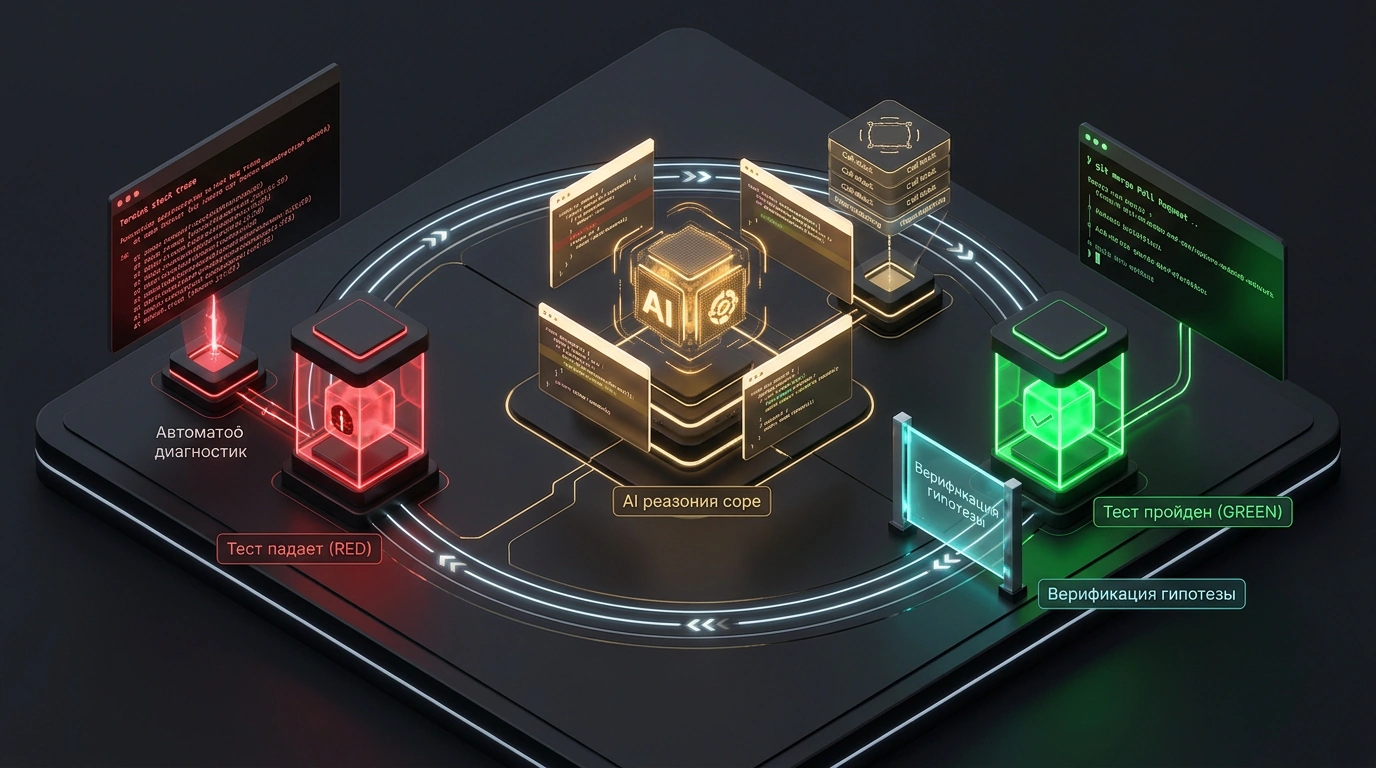

Большинство существующих ИИ-инструментов генерации кода страдают от одной и той же фундаментальной проблемы: они действуют реактивно и самоуверенно. Получив описание ошибки из баг-трекера, стандартная модель сразу бросается редактировать файлы проекта, предлагая изменения на основе поверхностного сходства симптомов. В результате разработчик получает код, который вроде бы устраняет заявленный симптом, но ломает соседние модули или создает скрытые регрессии в граничных случаях.
Появление автономного агента программирования Reason 1.0 знаменует качественный переход от слепого автодополнения кода к строгой инженерной валидации. В основу архитектуры Reason 1.0 положен классический принцип разработки через тестирование (Test-Driven Development, TDD). Модель категорически не имеет права вносить изменения в продакшен-код до тех пор, пока автономно не синтезирует воспроизводящий тест (Repro Test), доказывающий существование проблемы.
Цикл верификации гипотез: от ошибки к зеленому тесту
Архитектура Reason 1.0 моделирует поведение опытного инженера по надежности (SRE) и выстраивает работу по четырехступенчатому замкнутому контуру:
- Исследование репозитория и формулирование гипотезы: агент сканирует дерево исходных файлов, зависимости и существующие наборы тестов. На основе текста задачи модель выдвигает несколько альтернативных гипотез о первопричине сбоя (Root Cause Analysis).
- Синтез воспроизводящего теста (Repro Test): агент пишет изолированный модульный или интеграционный тест, который падает с конкретным кодом ошибки на текущей кодовой базе. Если тест проходит успешно, значит гипотеза не подтвердилась, и агент ищет причину дальше, не трогая рабочий код.
- Генерация минимального патча: только убедившись, что тест стабильно падает (Red State), Reason 1.0 генерирует точечное исправление, затрагивающее минимально необходимое число строк.
- Валидация регрессий и коммит: агент запускает не только написанный репро-тест, но и весь существующий тестовый набор репозитория. Если все тесты становятся «зелеными», формируется атомарный коммит с пояснением логики исправления.
В престижном отраслевом бенчмарке SWE-bench Verified, оценивающем способность ИИ решать реальные задачи из репозиториев GitHub, Reason 1.0 продемонстрировал впечатляющие 54.2% успешно решенных задач без вмешательства человека.
Практический сценарий: устранение бага в REST API
Посмотрим, как выглядит работа агента на практике. Предположим, в сервисе обработки платежей обнаружен баг: при передаче нулевой скидки функция расчета налога вызывает деление на ноль.
В первом блоке кода агент создает воспроизводящий тест tests/test_repro_zero_discount.py, фиксирующий падение:
# tests/test_repro_zero_discount.py
# Автоматически сгенерированный воспроизводящий тест агента Reason 1.0
import pytest
from payment_service.tax import calculate_net_total

def test_calculate_net_total_with_zero_discount_should_not_raise():
    """Проверка граничного случая: нулевая скидка не должна приводить к ZeroDivisionError."""
    cart_amount = 1000.0
    discount_ratio = 0.0  # Граничный случай, вызывающий сбой в продакшене
    tax_rate = 0.20

    # На неисправленном коде этот вызов падает с ZeroDivisionError: division by zero
    total = calculate_net_total(amount=cart_amount, discount=discount_ratio, tax=tax_rate)

    assert total == 1200.0, f"Ожидалась сумма 1200.0, получено {total}"
После запуска pytest tests/test_repro_zero_discount.py агент получает подтверждение: тест упал (FAILED). Теперь Reason 1.0 переходит к исправлению логики в модуле payment_service/tax.py:
# payment_service/tax.py
def calculate_net_total(amount: float, discount: float, tax: float) -> float:
    """Расчет итоговой суммы чека с учетом скидки и налога."""
    if amount < 0:
        raise ValueError("Сумма покупки не может быть отрицательной")

    # Исправление агента: безопасная обработка отсутствия или нулевого значения скидки
    if discount <= 0.0:
        discounted_amount = amount
    else:
        # Устранена ошибочная формула нормализации делителя
        discounted_amount = amount * (1.0 - min(discount, 1.0))

    tax_amount = discounted_amount * tax
    return round(discounted_amount + tax_amount, 2)
Агент повторно запускает тестовый люкс: воспроизводящий тест успешно проходит, а остальные 148 тестов проекта сохраняют статус PASSED. Только после этого агент рапортует о готовности мерж-реквеста.
Защита от деструктивных изменений
Поскольку Reason 1.0 исполняет код тестов в процессе валидации, критически важно изолировать среду выполнения. В продакшене агент развертывается внутри одноразовых эфемерных Docker-контейнеров с ограниченными правами доступа к сети. Это предотвращает случайное повреждение хостовой машины в случае генерации некорректных системных вызовов.
Подход, заложенный в Reason 1.0, задает новый стандарт качества для индустрии: ИИ-агент перестает быть генератором непроверенных догадок и становится дисциплинированным инженером, подтверждающим каждое слово строгими автоматическими тестами.