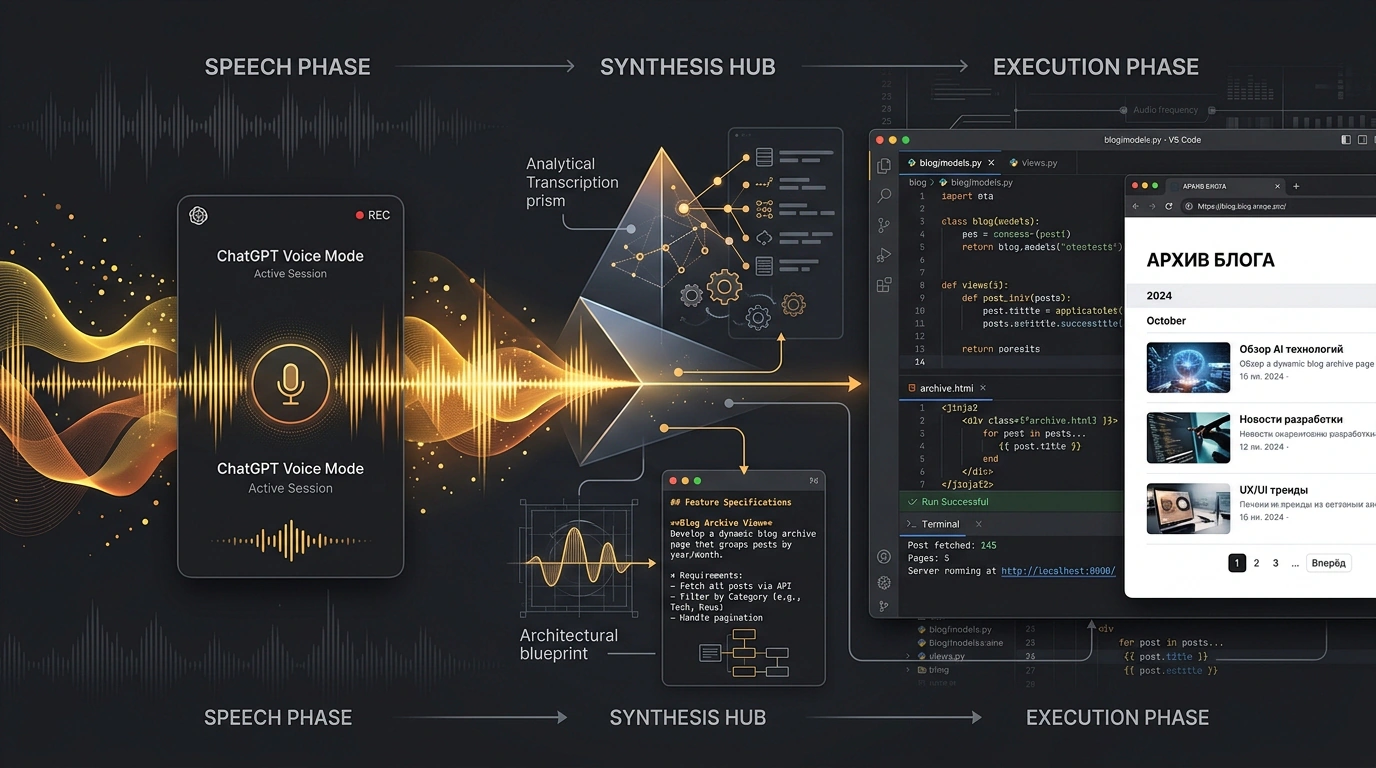
Классический процесс программирования прочно ассоциируется с клавиатурой, экраном монитора и мерцающим курсором в редакторе кода. Однако на этапе проектирования новой функциональности сидение за столом часто сковывает мышление. Архитектурные идеи гораздо свободнее рождаются во время прогулки, поездки за рулем или утренней чашки кофе, когда мозг не отвлекается на синтаксические мелочи.
Известный британский разработчик и автор открытых инструментов Саймон Уиллисон продемонстрировал впечатляющий воркфлоу, стирающий границу между голосовым обсуждением идеи и физическим кодом в репозитории. Он объединил голосовой режим ChatGPT Voice Mode, локальный репозиторий своего блога на Python и терминальный агент OpenAI Codex в единую непрерывную цепочку разработки.
Анатомия голосовой сессии: от мысли к спецификации
Вместо того чтобы садиться за клавиатуру и вручную писать парсер старого архива рассылок для своего персонального блога, Уиллисон включил голосовой режим на смартфоне во время прогулки.
Диалог строился по схеме «архитектурного интервью»:
- Постановка проблемы голосом: разработчик объяснил структуру входящих HTML-файлов старого почтового сервиса, формат желаемых URL-адресов страниц и требования к сохранению даты оригинальной публикации.
- Уточнение краевых случаев моделью: нейросеть голосом задала встречные вопросы: «Как обрабатывать вложенные изображения без внешних ссылок?», «Что делать с письмами, у которых отсутствует тема?».
- Формирование спецификации (Spec Dump): к концу 15-минутной беседы ChatGPT сформулировал структурированный манифест с описанием функций, схем моделей данных и граничных условий.
Вернувшись за рабочий компьютер, разработчик просто скопировал итоговый манифест в консольную сессию агента Codex, поручив ему физическую генерацию кода.
Шаблон страницы на Jinja и скрипт парсинга архива
Рассмотрим практический результат такой голосовой сессии. Первым компонентом стал адаптивный Jinja-шаблон для отображения архивного выпуска рассылки внутри блога:
<!-- templates/newsletter_archive_entry.html -->
{% extends "base.html" %}
{% block title %}{{ issue.subject }} — Архив рассылки{% endblock %}
{% block content %}
<article class="newsletter-post">
<header class="issue-header">
<div class="meta-tag">Выпуск №{{ issue.issue_number }}</div>
<h1 class="issue-title">{{ issue.subject }}</h1>
<time datetime="{{ issue.published_date.isoformat() }}">
Опубликовано: {{ issue.published_date.strftime("%d %B %Y") }}
</time>
</header>
<div class="issue-body">
<!-- Безопасный рендеринг санитизированного HTML из архива -->
{{ issue.sanitized_html|safe }}
</div>
<footer class="issue-footer">
<a href="/newsletters/" class="back-link">← Вернуться ко всем выпускам</a>
</footer>
</article>
{% endblock %}
Вторым элементом стал надежный Python-скрипт на базе библиотек BeautifulSoup4 и dateutil, извлекающий метаданные из сырых почтовых дампов и нормализующий ссылки:
# scripts/import_newsletter_archive.py
import os
import re
from pathlib import Path
from bs4 import BeautifulSoup
from dateutil import parser as date_parser

def parse_newsletter_file(file_path: Path) -> dict:
    """Извлечение темы, даты и очищенного контента из архивного письма."""
    raw_content = file_path.read_text(encoding="utf-8", errors="replace")
    soup = BeautifulSoup(raw_content, "html.parser")

    # Извлечение темы из мета-тегов или первого заголовка
    title_tag = soup.find("title") or soup.find("h1")
    subject = title_tag.get_text(strip=True) if title_tag else "Без темы"

    # Извлечение даты публикации из комментария или метаданных
    date_meta = soup.find("meta", {"name": "publication-date"})
    if date_meta and date_meta.get("content"):
        published_date = date_parser.parse(date_meta["content"])
    else:
        # Резервный источник: дата изменения файла
        published_date = date_parser.parse("2026-10-08T12:00:00Z")

    # Очистка нежелательных трекинг-пикселей и рекламных баннеров
    for tracking_img in soup.find_all("img", src=re.compile(r"pixel|track|open")):
        tracking_img.decompose()

    body_container = soup.find("div", class_="email-body") or soup.body
    sanitized_html = str(body_container) if body_container else raw_content

    return {
        "slug": file_path.stem.lower(),
        "subject": subject,
        "published_date": published_date,
        "sanitized_html": sanitized_html
    }

def process_entire_archive(archive_dir: str):
    """Пакетная обработка всех архивных файлов в директории."""
    source_dir = Path(archive_dir)
    html_files = sorted(source_dir.glob("*.html"))
    print(f"Найдено {len(html_files)} архивных писем для импорта...")

    for html_file in html_files:
        parsed_data = parse_newsletter_file(html_file)
        print(f"Импортирован выпуск: {parsed_data['subject']} ({parsed_data['published_date'].date()})")

if __name__ == "__main__":
    process_entire_archive("./legacy_archive")
После запуска скрипта Codex автоматически прогнал линтер, проверил отсутствие битых ссылок и создал аккуратный Pull Request в основной репозиторий.
Почему голосовое программирование меняет скорость разработки
Опыт Уиллисона наглядно доказывает: в разработке программного обеспечения самым дорогим этапом является не сам набор текста на клавиатуре, а структурирование мыслей и поиск верных абстракций.
Голосовой режим современных моделей выступает идеальным «резиновым утенком» с колоссальным инженерным кругозором. Проговаривая идею вслух и получая мгновенную обратную связь от ИИ, разработчик отсекает архитектурные тупики еще до того, как открыл ноутбук.