
Гонка параметров в мире больших языковых моделей давно уперлась в жесткую физику и экономику дата-центров. Обучить плотную монолитную сеть (dense network) на сотни миллиардов параметров невероятно дорого, но еще дороже поддерживать ее инференс в продакшене: чтобы сгенерировать одно короткое слово, серверный кластер вынужден синхронно активировать каждый транзистор и прогонять матрицы через терабайты регистров.
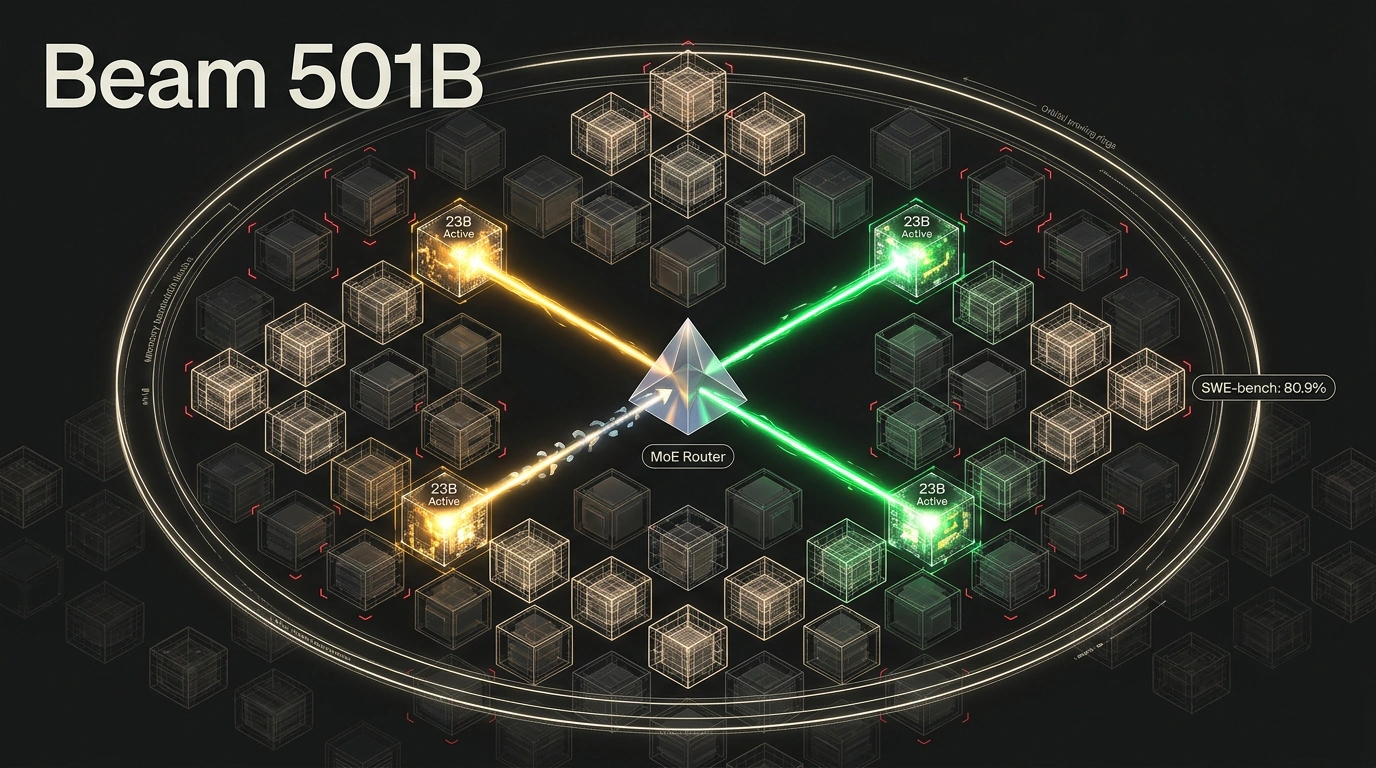
Исследовательский стартап Reflection AI из Бруклина, основанный бывшими ведущими исследователями Google DeepMind Мишей Ласкиным и Иоаннисом Антоноглу (один из ключевых архитекторов AlphaGo и RL-выравнивания Gemini), предложил радикальный ответ на этот вызов. Компания анонсировала архитектуру Beam — свою первую открытую базовую модель объемом 501 миллиард параметров (501B), построенную на принципе разреженной смеси экспертов (Sparse Mixture-of-Experts, MoE). При колоссальном запасе знаний модель активирует на каждый генерируемый токен всего 23 миллиарда параметров, кардинально меняя себестоимость вычислений.
Ловушка плотных гигантов: почему индустрия переходит на разреженные смеси экспертов
В классической плотной архитектуре сеть работает как универсальный эрудит-одиночка: независимо от того, просите ли вы написать скрипт на Bash или перевести сонет Шекспира, задействуется 100% нейронов. Это приводит к двум фундаментальным ограничениям:
- Непомерные затраты энергии и времени: генерация токенов упирается в пропускную способность шины памяти графических процессоров (memory bandwidth). Время отклика растет пропорционально общему весу модели.
- Конфликт градиентов при дообучении: пытаясь одновременно обучить плотную сеть сложной высшей математике, юриспруденции и написанию кода, инженеры сталкиваются с взаимным стиранием навыков (catastrophic forgetting).
Разреженная архитектура MoE преодолевает этот тупик, разделяя слои нейросети на десятки специализированных независимых модулей («экспертов»). Динамический маршрутизатор (router) оценивает входной токен и направляет его только двум-трем наиболее компетентным экспертам, оставляя остальную часть сети в режиме ожидания.
Архитектура Beam 501B: 4.6% вычислений без потери энциклопедической глубины
В Beam 501B этот принцип доведен до предельной инженерной точности. При суммарном весе в 501 миллиард параметров динамическая маршрутизация активирует лишь 23 миллиарда параметров на токен — то есть ровно 4.6% от всей емкости сети.
На практике это означает, что по скорости отклика и вычислительной нагрузке Beam ощущается как компактная и быстрая 23B-модель, но при этом обладает кругозором и эвристической глубиной гиганта на полтриллиона параметров. На независимых бенчмарках модель показала выдающиеся результаты:
- SWE-bench Verified: 80.9% успешно решенных реальных задач из репозиториев GitHub (для сравнения, у Inkling — 77.6%, а у Nemotron 3 Ultra — 70.7%);
- Terminal Bench 2.1E: 80.1% в сценариях автономного администрирования операционных систем через командную строку;
- AIME 2026: 97.8% в решении олимпиадных задач по математике;
- GPQA Diamond: 90.5% в ответах на междисциплинарные вопросы научного уровня.
Тренировка в 1.3 миллиарда песочниц: как учили агентную надежность
Феноменальный результат модели в написании кода и системных сценариях стал следствием уникальной методологии обучения. Предварительное обучение проводилось на корпусе из 23.8 триллиона токенов, после чего последовала масштабная фаза обучения с подкреплением (Reinforcement Learning).
Reflection AI арендовала мощности дата-центра Colossus, развернув 4-недельный марафон на кластере из 10 500 ускорителей NVIDIA GB300. Вместо того чтобы оценивать сгенерированный код через текстовые функции потерь, модель заставляли выполнять его на практике. За время RL-кампании было проведено свыше 100 миллионов итераций генерации (rollouts), для верификации которых исследователи подняли 1.3 миллиарда изолированных песочниц (sandboxes). Сеть училась на собственных ошибках компилятора, получая штрафы за зависшие процессы и утечки памяти.
Управляемый штраф за размышления: баланс скорости и олимпиадной логики
Одной из главных проблем современных рассуждающих моделей (reasoning models) стала избыточная многословность: на тривиальный вопрос «какой сегодня день?» сеть может генерировать сотни токенов внутренних монологов, сжигая время и деньги пользователя.
В Beam реализован механизм регулируемого штрафа за длину рассуждений (Controllable Length Penalty). Разработчик может передавать в API параметр reasoning_effort:
- В значении
lowмодель отключает многословные рассуждения и мгновенно возвращает краткий ответ или рабочий терминальный однострочник; - В значении
highBeam выстраивает многослойную цепочку доказательств и математических проверок для сложнейших алгоритмических задач.
Железо и развертывание: цена размещения открытых весов Apache 2.0
Reflection AI завершает программу внешнего аудита безопасности (red-teaming) и объявила о публичном выпуске весов и технической документации под максимально либеральной лицензией Apache 2.0. Это открывает дорогу свободному коммерческому внедрению в закрытых контурах без лицензионных отчислений.
Однако потенциальным пользователям важно трезво оценивать аппаратные требования:
- Разделение памяти и вычислений: хотя вычислительная сложность каждого шага равна 23B параметрам, все 501 миллиард весов должны постоянно находиться в памяти графических ускорителей (VRAM). В формате половинной точности FP16 это требует около 1 терабайта VRAM (например, узел из 8 ускорителей NVIDIA H100/H200).
- Квантование для локальных серверов: при использовании форматов FP8 или INT4 требования к памяти снижаются до 250–500 ГБ, что позволяет запускать модель на более доступных серверных конфигурациях через фреймворки vLLM, TensorRT-LLM и SGLang.
- Текстовый фокус: первая версия Beam 501B является чисто текстовой и не включает нативный энкодер изображений, что требует подключения внешних мультимодальных модулей при работе с визуальными интерфейсами.
Появление открытой MoE-модели уровня Beam 501B доказывает, что независимые исследовательские лаборатории способны создавать решения, не уступающие закрытым облачным флагманам, делая передовые агентные технологии доступными для всего инженерного сообщества.