

В околотехнологических медиа в последнее время все громче звучат голоса скептиков. Аргументы известны: качественные человеческие тексты в интернете закончились, новые поколения моделей прибавляют в бенчмарках лишь доли процента, а затраты на дата-центры улетают в стратосферу. Неужели экспоненциальный взрыв искусственного интеллекта выдохся, уткнувшись в естественный потолок?
Ответы на эти фундаментальные вопросы прозвучали из первых уст. Генеральный директор OpenAI Сэм Альтман (Sam Altman) дал обстоятельное двухчасовое интервью независимому исследователю Мэттью Берману (Matthew Berman, проект Forward Future). Разговор получился на редкость откровенным: без привычного глянцевого PR-тумана Альтман разложил по полочкам текущую смену исследовательской парадигмы, проблему рекурсивного самосовершенствования моделей, энергетический кризис и философскую загадку машинного сознания.
Смена парадигмы: от Pre-training к Test-Time Compute
Главный тезис Альтмана, меняющий представление о траектории развития ИИ: закон масштабирования классического предобучения (Pre-training) исчерпал свою взрывную силу.
До сих пор формула прогресса была простой и прямолинейной: берем больше серверов, скармливаем модели больше терабайт текстов из интернета, увеличиваем число параметров — и на выходе получаем более умную сетку. Но к концу 2026 года индустрия столкнулась с двумя непреодолимыми факторами:
- Общедоступный качественный человеческий контент в сети практически закончился;
- Экстенсивное раздувание параметров делает модель слишком медленной и дорогой для повседневного применения.
Новый фронтир прогресса переместился в область вычислений на этапе ответа (Test-Time Compute). Вместо того чтобы пытаться мгновенно выдать следующее слово по памяти, модель получает возможность «думать» — запускать цепочки внутренних рассуждений, перебирать деревья гипотез, тестировать промежуточные выводы через встроенные интерпретаторы и критиковать собственные ошибки до вывода финального текста пользователю. Именно этот принцип лежит в основе современных рассуждающих серий o1, o3 и GPT-5.6 Sol.
Рекурсивное самосовершенствование (RSI): алгоритмы строят алгоритмы
Второй взрывной темой беседы стало подтверждение того, что лаборатории перешли к фазе рекурсивного самообучения (Recursive Self-Improvement, RSI). Это концепция, о которой десятилетиями спорили теоретики сингулярности: момент, когда искусственный интеллект начинает сам улучшать свой код и архитектуру.
По словам Альтмана, инженеры OpenAI больше не пишут низкоуровневые ядра вручную. Рассуждающие модели привлекаются для решения сложнейших исследовательских задач:
- Поиск оптимальных математических оптимизаторов и функций потерь;
- Генерация верифицированных синтетических датасетов по высшей математике и формальной логике;
- Автоматический аудит безопасности и поиск логических уязвимостей в коде следующих версий моделей.
О рисках и вызовах этой архитектуры я подробно писал в исследовании Эра рекурсивного самообучения: почему ведущие лаборатории переходят к ИИ, создающему ИИ, и чем это угрожает безопасности.
Однако Альтман остудил пыл сторонников мгновенной сингулярности. Без постоянной сверки с реальным физическим миром полностью замкнутый цикл RSI неизбежно скатывается в «галлюцинаторное вырождение», когда модель начинает оптимизировать бессмысленные для человека абстрактные паттерны. Контроль со стороны реальных компиляторов и физических экспериментов остается обязательным якорем.
Энергетическое бутылочное горлышко: битва за тераватты
Пожалуй, самое прагматичное и тревожное откровение интервью касается физической инфраструктуры. На вопрос Бермана о том, что является главным тормозом масштабирования ИИ до 2030 года, Альтман ответил без колебаний: не производство кремниевых чипов, а физическая нехватка электроэнергии.
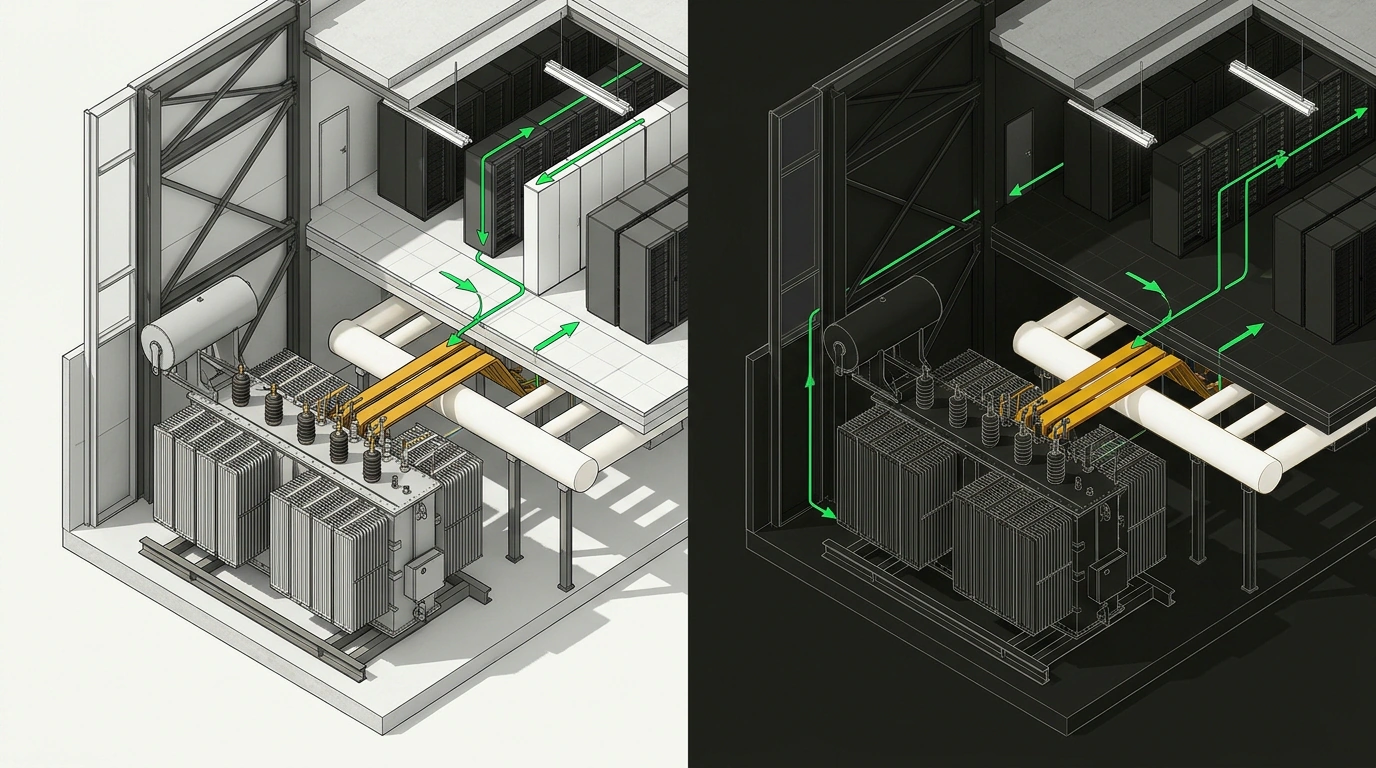
Вычислительные кластеры нового поколения (такие как стойки NVIDIA Blackwell и Rubin) требуют колоссальной мощности:
- Дата-центры масштабируются от сотен мегаватт к гигаваттным комплексам;
- Традиционные энергосети США и Европы физически не способны выдать требуемую мощность в одной локации без перегрузки региональных подстанций;
- Сроки подключения нового объекта к высоковольтным линиям растягиваются на 4–7 лет.
Именно поэтому OpenAI и другие лидеры отрасли активно инвестируют в альтернативные источники генерации: малые модульные ядерные реакторы (SMR), проекты термоядерного синтеза (Helion) и глубокую геотермальную энергетику. Будущее ИИ куется не столько в Кремниевой долине, сколько на строительных площадках новых атомных станций. О том, как технологическая трансформация меняет требования к навыкам специалистов, читай в статье Владение нейросетями становится обязательным навыком.
Вопрос о сознании: функциональность против квалиа
На неизбежный философский вопрос о том, обладают ли современные модели зачатками сознания, Альтман ответил предельно аккуратно. Он призвал разделять функциональные проявления интеллекта (способность планировать, ставить цели, учитывать контекст собеседника и адаптироваться к ошибкам) и субъективный внутренний опыт (квалиа).
С функциональной точки зрения рассуждающие агенты уже ведут себя как разумные сущности. Однако приписывание им человеческих эмоций, страданий или желаний — опасное антропоморфное заблуждение.
Не ждите появления волшебной модели, которая решит все задачи одним промптом за счет триллионов параметров. Индустрия сделала бесповоротный выбор в пользу агентных архитектур, где выигрывает тот, кто умеет грамотно организовать многошаговый пайплайн рассуждений и валидации на стороне клиента.
Использование моделей для обучения следующих поколений моделей требует жесточайшей фильтрации данных. Если синтетический обучающий корпус содержит незаметную систематическую погрешность, в процессе рекурсивных циклов эта ошибка вырастает лавинообразно, приводя к деградации логики нейросети.
Интервью Сэма Альтмана расставляет точки над «i». Мы стоим на пороге зрелого технологического этапа: легкие фокусы с масштабированием текстов закончились, уступив место фундаментальной инженерной работе с рассуждениями, системными харнесами и чистой физической энергетикой.