

Вспомни, как обычно выглядит расшифровка рабочего зум-созвона или записи телефонного разговора с клиентом через стандартный Whisper: в чистой студийной записи всё гладко, но стоит двум собеседникам перебить друг друга, как текст превращается в кашу без указания говорящих. А редкие технические термины, фамилии коллег или названия брендов нейросеть с упорством заменяет на созвучную абракадабру. До сих пор для нормальной работы приходилось городить сложные «бутерброды» из сторонних библиотек диаризации вроде pyannote.audio и постобработки в LLM.
Французская лаборатория Mistral AI решила подойти к вопросу фундаментально, представив специализированную речевую линейку Voxtral 3 (включая пакетную модель Voxtral Small Transcribe 3 и потоковую версию Realtime). Главная цель релиза — дать разработчикам готовый речевой мозг для создания голосовых агентов без внешних костылей.
Что под капотом: 50+ языков, нативная диаризация и словарь терминов
В отличие от классических систем распознавания речи (ASR), Voxtral 3 изначально обучалась как мультимодальный агентный компонент:
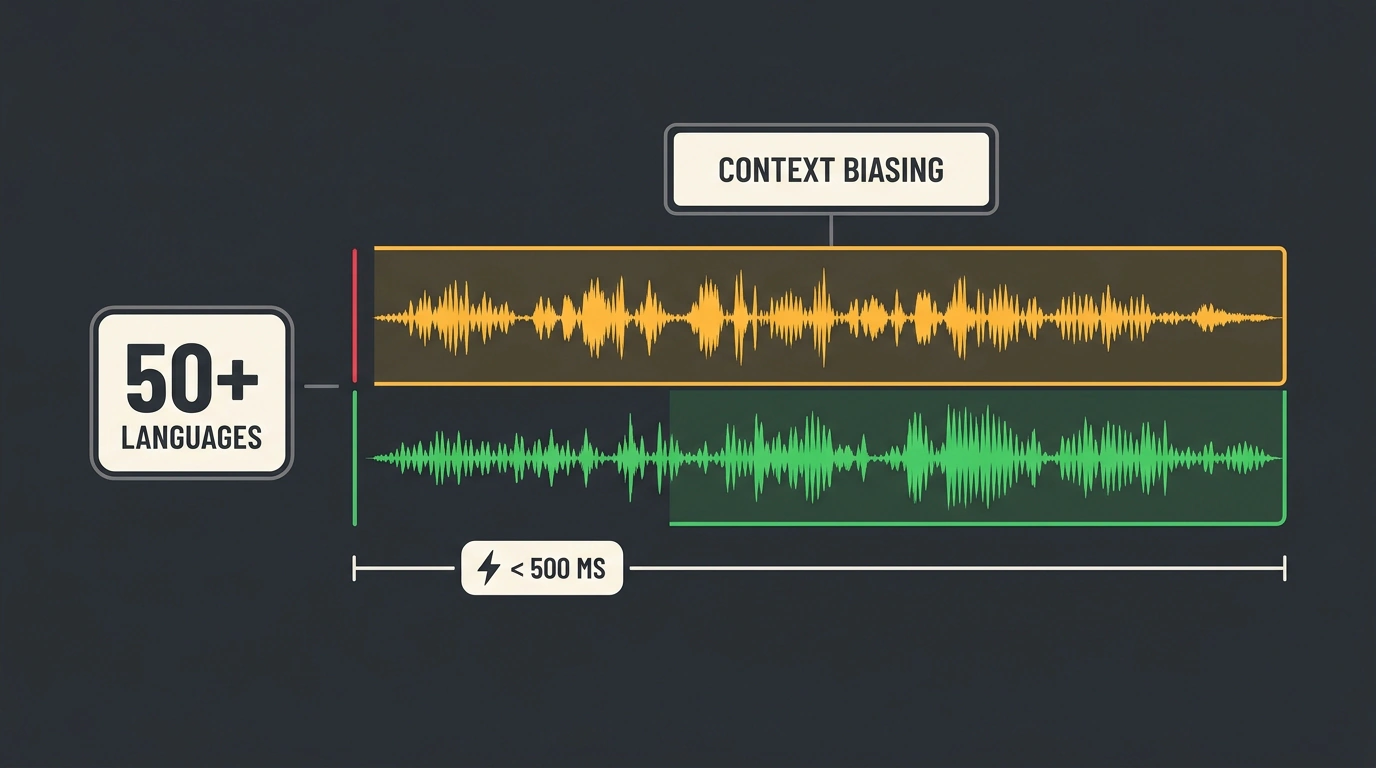
- Мультиязычность для 50+ языков: модель великолепно справляется с переключением языков на лету, что критично для международных команд, где технические термины на английском перемежаются с русской речью.
- Встроенная диаризация (Speaker Diarization): модель разделяет реплики участников прямо в процессе транскрипции, размечая таймкоды с точностью до десятых долей секунды (
Speaker 1,Speaker 2) без подключения сторонних тяжелых нейросетей. - Определение пауз (Turn Detection): алгоритм улавливает интонационное завершение фразы, позволяя голосовому ассистенту мгновенно брать слово без неестественных секундных задержек и не перебивая человека на полувздохе.
- Контекстная подсказка словаря (Context Biasing): в запрос к API можно передать массив специфических слов — названия ваших микросервисов, артикулы товаров или сленг. Модель использует этот список для смещения вероятностей токенов, исключая нелепые фонетические ошибки.
Практика: пакетная расшифровка и потоковый ассистент
Вот как выглядит вызов API Mistral на Python для расшифровки сложного технического митинга с диаризацией и списком терминов:
from mistralai import Mistral

# Инициализация клиента Mistral AI
client = Mistral(api_key="your-mistral-api-key")

with open("dev_standup.mp3", "rb") as audio_file:
    speech_res = client.audio.models.process(
        model="voxtral-small-speech-3",
        file=audio_file,
        language="ru",
        diarization=True,
        context_biasing=[
            "Kubernetes",
            "OpenTelemetry",
            "ClickHouse",
            "DeepInfer"
        ]
    )

for segment in speech_res.segments:
    print(f"[{segment.speaker}] {segment.start:.2f}s - {segment.end:.2f}s: {segment.text}")
А если ты строишь голосового робота для телефонной линии или умного консультанта на сайте, потоковый WebSocket-клиент обеспечивает задержку первого токена менее 500 миллисекунд:
import asyncio
from mistralai.realtime import VoxtralRealtimeClient

async def run_voice_agent():
    async with VoxtralRealtimeClient(model="voxtral-mini-transcribe-3-realtime") as session:
        await session.connect()
        print("Подключение к речевому движку Voxtral установлено")

        async def handle_turn(event):
            print(f"Пользователь закончил мысль: {event.text}")
            # Передача текста в LLM для мгновенной генерации ответа

        session.on("turn_detection", handle_turn)
        # Отправка аудиопотока с микрофона в реальном времени
        # await session.send_audio(stream_chunk)

asyncio.run(run_voice_agent())
Для компаний, работающих с персональными данными клиентов или чувствительными записями звонков, важно европейское происхождение Mistral: инфраструктура полностью соответствует стандартам GDPR, а веса моделей доступны для локального деплоя на собственных GPU.
Мы уже обсуждали, как быстро накаляется конкуренция голосовых ИИ-агентов, где доли секунды решают судьбу контакта с клиентом. Voxtral 3 делает создание умных голосовых интерфейсов доступным каждому разработчику, снимая головную боль ручной настройки акустических моделей.