

Если ты внимательно следишь за гонкой нейросетей, то наверняка помнишь негласное правило последних двух лет: в открытом доступе можно найти отличные легковесные модели для автодополнения кода или быстрого чата, но когда дело доходит до настоящих многочасовых инженерных рассуждений, администрирования боевых Linux-серверов или разбора запутанных архитектурных багов, альтернативы закрытым западным гигантам вроде Claude Opus просто не существовало. Мы привыкли к тому, что высшая лига закрыта проприетарными API, а локальные и открытые веса отстают на полтора-два поколения.
Так вот, этот статус-кво только что с грохотом рухнул. Пекинская лаборатория Moonshot AI выкатила Kimi K3.1 Pro — флагманскую мультимодальную систему, которая в независимом аудите не просто навязала борьбу Claude Opus 5.5 и GPT-6 Astra, а в целом ряде сложнейших терминальных и программных испытаний обошла их. И самое потрясающее во всей этой истории: Moonshot подтвердила, что уже 4 ноября 2026 года веса модели будут выложены в открытый доступ под свободной исследовательской лицензией. Давай снимем глянцевую обертку громких анонсов и вместе разберем по винтикам, как устроена эта махина под капотом, за счет чего китайские разработчики сократили разрыв и где здесь скрываются неизбежные подводные камни.
Архитектура на 2.8 триллиона параметров: как устроена разреженная маршрутизация
Когда впервые видишь в спецификации цифру в 2.8 триллиона параметров, в голове мгновенно вспыхивает тревожная мысль: для запуска этой штуки потребуется небольшая гидроэлектростанция и серверная стойка за миллионы долларов. Но не спеши отчаиваться. Вся инженерная суть архитектуры Kimi K3.1 Pro кроется в технологии разреженной активации — Mixture-of-Experts (MoE).
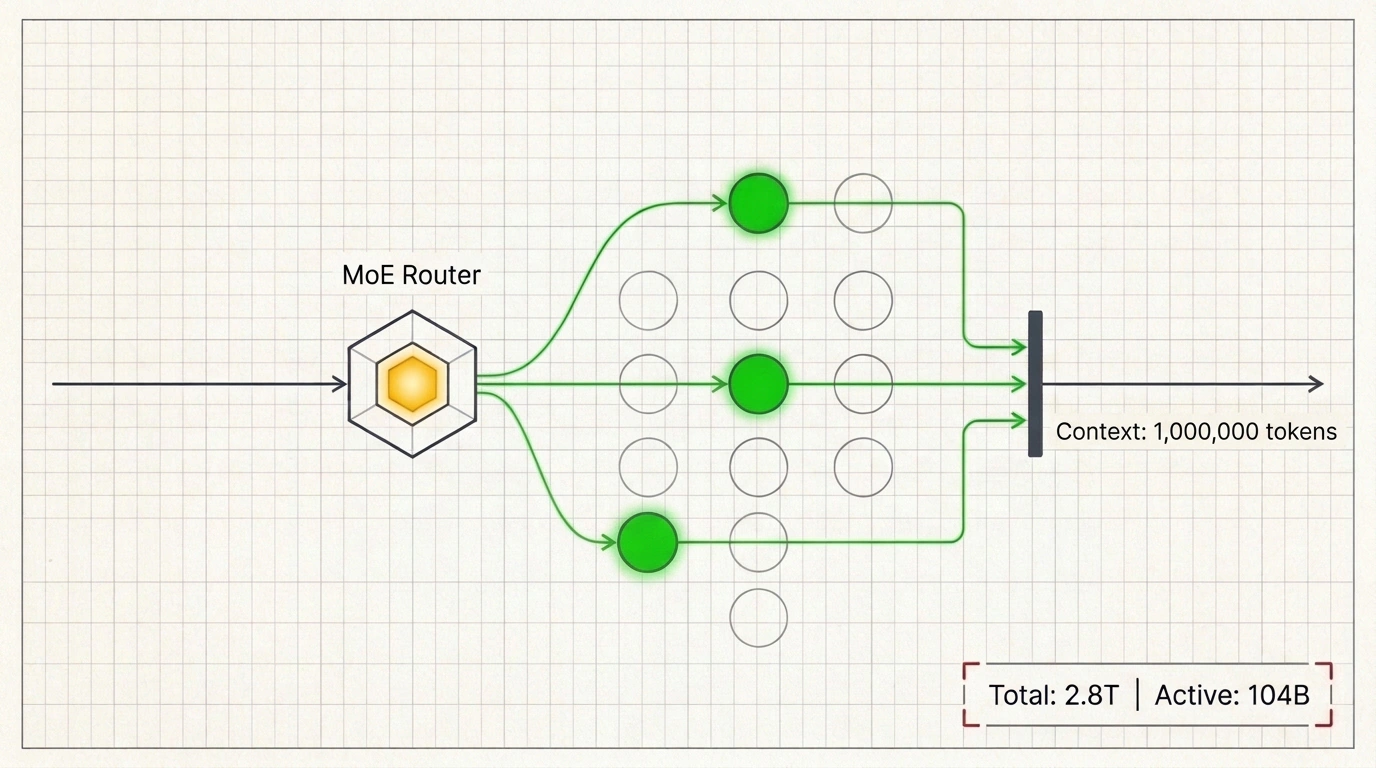
Представь себе гигантский университетский исследовательский институт, где работают тысячи профессоров самых разных дисциплин. Если к ним обращается студент с вопросом по исправлению ошибки сегментации памяти в коде на Си, институт не собирает общее собрание всех трех тысяч сотрудников. Умный диспетчер на входе мгновенно направляет задачу ровно трем специалистам по низкоуровневой памяти. В Kimi K3.1 Pro реализован ровно тот же принцип: из колоссального массива в 2.8 триллиона весов на каждый отдельный обрабатываемый токен динамически активируется всего около 104 миллиардов параметров.
Что это означает на практике? По своей вычислительной нагрузке и скорости генерации K3.1 Pro сопоставима со стандартными плотными сетями среднего размера, но сохраняет колоссальную емкость знаний и ассоциативную глубину, накопленную гигантским числом экспертов.
Второй критический параметр — размер контекстного окна в 1 000 000 токенов (это примерно 750 000 слов или добротная полка толстых технических справочников). Самое примечательное, что Moonshot AI не пришлось заново обучать базовую языковую модель с нуля. Предыдущая версия Kimi K3 вышла всего за три месяца до этого релиза, и весь качественный скачок стал результатом сверхударного пост-тренинга с подкреплением (Reinforcement Learning over thousands of specialized downstream domains). Разработчики построили гигантскую систему верификации с автоматическим начислением штрафов за синтаксические ошибки, недостоверные выводы и сбои в логических цепочках.
Кроме того, K3.1 Pro нативно мультимодальна. Это не франкенштейн из приклеенного изолентой внешнего модуля компьютерного зрения: сеть одновременно и в едином смысловом пространстве переваривает текст, растровые изображения высокого разрешения, скриншоты терминалов и непрерывный видеопоток.
Анатомия бенчмарков: независимый аудит Terminal-Bench, SWE-bench и HLE
Громкие заявления в корпоративных пресс-релизах мы с тобой видели сотни раз, поэтому меня в первую очередь интересовали независимые замеры платформы Artificial Analysis. И вот здесь начинаются цифры, от которых у конкурентов наверняка пробежал холодок по спине.
Самый показательный тест автономных агентов сегодня — это Terminal-Bench 4.0. В отличие от синтетических тестов с вопросами из школьной программы, здесь модель выбрасывают в настоящую виртуальную консоль Linux. Перед ней ставят реальные аварийные задачи: сломался демон базы данных, повреждены симлинки, слетела конфигурация Nginx или не компилируется драйвер ядра. Модель должна самостоятельно вводить команды bash, анализировать стандартный вывод, читать системные логи, находить ошибки и устранять сбой.
Результаты в Terminal-Bench 4.0:
- Kimi K3.1 Pro набрала 65.7% (а в серии расширенных прогонов с повышенным бюджетом на размышления — до 67.2%);
- Флагман Anthropic Claude Opus 5.5 показал 66.4%;
- Модель OpenAI GPT-6 Astra набрала всего 58.2%;
- При этом предыдущая версия Kimi K3 на этом же тесте выдавала скромные 12.6–13%.
Понимаешь масштаб рывка? Менее чем за квартал открытая китайская архитектура перепрыгнула пропасть между беспомощным чат-ботом и полноценным Linux-администратором, идущим ноздря в ноздрю с главным мировым фаворитом.
Переходим к SWE-marathon — сложнейшему стресс-тесту, где нейросеть подключают к реальным репозиториям GitHub и просят устранить задокументированный баг, требующий внесения изменений в десятки взаимосвязанных файлов. Здесь Kimi K3.1 Pro заняла абсолютное первое место с результатом 51.7%, оставив позади и Claude Opus 5.5 (46.3%), и GPT-6 Astra (42.5%).
На междисциплинарном академическом экзамене Humanity's Last Exam (HLE) из 2500 экспертных задач результат Kimi с инструментами достиг 70.0% против 67.7% у Opus 5.5. В тесте Agent's Last Exam (122 комплексных исследовательских сценария, где запрещено прямое копирование ответов из поиска) Kimi показала 43.2% против 42.6% у флагмана Anthropic. А в задаче веб-исследования BrowserComp она выбила 92.1%, разделив лидерство с GPT-6 Astra (91.5%).
Пространственный синтез и агент на рабочем столе: 3D, видео и компьютерное зрение
Цифры в бенчмарках хороши для отчетов, но как эта мощь выглядит в руках живого исследователя? Известный популяризатор ИИ Мэтью Берман провел показательный натурный эксперимент, предложив Kimi K3.1 Pro и Claude Opus 5.5 одинаковую сложную прикладную задачу: сгенерировать с нуля интерактивную трехмерную сцену старта космической ракеты с процедурными мешами, физикой частиц для выхлопного пламени и шейдерами дыма на WebGL.
Результат оказался ошеломляющим не только по качеству, но и по экономике процесса:
- Kimi K3.1 Pro полностью написала код сцены за 6 минут, потратив на токены размышлений и генерации $1.95;
- Claude Opus 5.5 потратила на аналогичное задание 24 минуты, а счет за использованные токены API составил $10.35.
Более чем пятикратная экономия бюджета при четырехкратном превосходстве по времени! При этом визуальная сцена Kimi с первого запуска заработала без синтаксических ошибок в шейдерах.
Второй впечатляющий компонент — режим десктопного агента (Desktop Agent), встроенный в официальный клиент Kimi. Модель способна наблюдать за происходящим на экране твоего компьютера в реальном времени с частотой в несколько кадров в секунду. Она распознает не просто текст, а точные координаты кнопок интерфейса, выпадающие списки, формы ввода и контекстные меню, после чего генерирует синтетические события клавиатуры и мыши. Это открывает дорогу к автоматизации тяжелых локальных программ (от графических редакторов до CAD-систем), у которых в принципе нет программного API для интеграции.
Экономика инференса, кибербезопасность и открытые веса: правила новой игры
Давай начистоту поговорим о деньгах, потому что именно тарифы определяют, останется ли крутая технология игрушкой для пары лабораторий или перевернет всю индустрию.
Официальная стоимость вызовов Moonshot API для Kimi K3.1 Pro установлена на уровне $2 за 1 миллион входных токенов и $10 за 1 миллион выходных токенов. Сравним это с прямыми конкурентами:
- Claude Opus 5.5 обходится в $4 за вход и $20 за выход (ровно в два раза дороже);
- GPT-6 Astra требует $10 за вход и $50 за выход (в пять раз дороже Kimi).
Такой ценовой демпинг в сочетании с качеством уровня Opus делает K3.1 Pro ультимативным бэкендом для любых агентных конвейеров, где расход токенов на непрерывные размышления и перепроверку гипотез исчисляется десятками миллионов в день.
При подготовке датасета разработчики Moonshot AI пошли на беспрецедентный шаг в области кибербезопасности: они намеренно вычистили из обучающей выборки K3.1 Pro базы данных эксплойтов нулевого дня (0-day), генераторы полиморфного вредоносного софта и специализированные сценарии наступательных кибератак. Компания осознанно отказалась от создания кибероружия перед выкладыванием весов в открытый доступ, сфокусировав автономные способности модели исключительно на созидательной системной инженерии, администрировании, аудите и рефакторинге.
Однако, чтобы у тебя не возникло иллюзии розового единорога, я обязан честно перечислить слабые стороны Kimi K3.1 Pro, которые выявили стресс-тесты:
- Чувствительность к формулировке системных инструкций на английском языке. Если ты скармливаешь Kimi пятистраничный системный промпт с десятками вложенных правил форматирования, она может иногда упускать мелкие второстепенные требования, тогда как Opus 5.5 держит сложную структуру железной хваткой.
- Локальный запуск полного объема 2.8T MoE потребует серверных стоек с терабайтами распределенной памяти даже в 4-битном квантовании (GGUF Q4_K_M). Обычный домашний ПК такую махину без дистилляции не потянет.
- В задачах изящного литературного редактирования текстов Claude Opus 5.5 по-прежнему сохраняет пальму первенства по тонкости языковых интонаций.
Ниже я привожу рабочий пример взаимодействия с официальным эндпоинтом Kimi K3.1 Pro через стандартный клиент OpenAI, демонстрирующий настройку глубоких рассуждений:
import openai

# Kimi K3.1 Pro полностью совместима с протоколом OpenAI API
client = openai.OpenAI(
    api_key="MOONSHOT_API_KEY",
    base_url="https://api.moonshot.ai/v1"
)

response = client.chat.completions.create(
    model="kimi-k3.1-pro",
    messages=[
        {
            "role": "system",
            "content": "You are an autonomous engineering agent inside an Ubuntu terminal."
        },
        {
            "role": "user",
            "content": "Audit the Nginx configuration, identify misconfigured SSL ciphers, and fix upstream timeouts."
        }
    ],
    temperature=0.2,
    max_tokens=4096,
    stream=True,
    extra_body={
        "reasoning_effort": "high",
        "thought_budget_tokens": 8192
    }
)

for chunk in response:
    delta = chunk.choices[0].delta
    if hasattr(delta, "reasoning_content") and delta.reasoning_content:
        print(f"[Рассуждения]: {delta.reasoning_content}", end="", flush=True)
    if delta.content:
        print(delta.content, end="", flush=True)
А если тебе нужно отправить прямой запрос к API через терминал с помощью утилиты curl без установки внешних библиотек, это делается буквально одной командой:
curl -X POST https://api.moonshot.ai/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $MOONSHOT_API_KEY" \
  -d '{
    "model": "kimi-k3.1-pro",
    "messages": [
      {"role": "user", "content": "Explain the sparse routing mechanism of Kimi K3.1 Pro"}
    ],
    "temperature": 0.3
  }'
Главный вывод прост: 4 ноября 2026 года монополия закрытых лабораторий на сложные автономные рассуждения окончательно уходит в прошлое. Мы получаем инструмент мирового класса с открытыми весами, доступный каждому независимому разработчику.