

Каждый разработчик, пробовавший поднять локальную модель для кодинга на своем рабочем ноутбуке, неизбежно упирался в железную стену компромиссов. Легкие модели на 7–14 млрд параметров (вроде базовых версий Qwen или DeepSeek) заводятся легко и строчат код как из пулемета, но стоит подсунуть им нетривиальный многопоточный баг или запутанный рефакторинг в чужом репозитории, как они начинают уверенно выдумывать несуществующие методы. Тяжелые плотные сетки на 32–70 млрд параметров рассуждают на порядок взрослее, но требуют 48–80 ГБ видеопамяти и выдают на потребительском железе унылые 15–25 токенов в секунду, превращая работу в испытание для нервной системы.
Стартап Recursive Superintelligence под руководством известного исследователя Ричарда Сохера разрубил этот гордиев узел, выпустив модель Flint 40B под кристально чистой лицензией Apache 2.0.
Сверхразреженная архитектура 256 экспертов: как получить качество 40B на ресурсах 2.5B
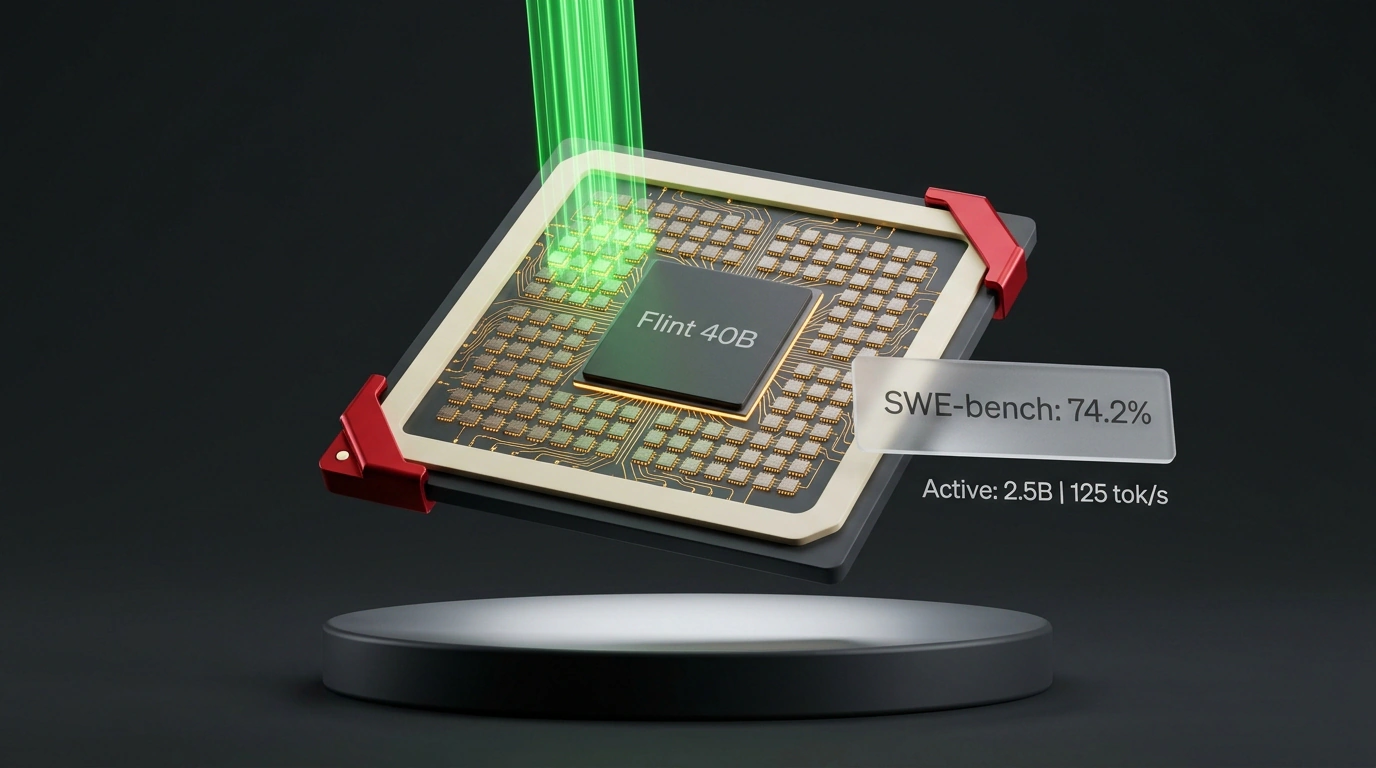
Секрет невероятной прыти Flint 40B заключается в экстремально разреженной архитектуре Mixture-of-Experts. Общий объем параметров модели составляет солидные 39.8 миллиарда, однако при генерации каждого отдельного токена активируется всего 2.5 миллиарда весов!
Давай посмотрим на геометрию сети:
- Модель состоит из 49 слоев: первых двух плотных слоев для первичного захвата контекста и 47 слоев разреженного ветвления MoE.
- В каждом MoE-слое упаковано по 256 специализированных микро-экспертов.
- Динамический маршрутизатор токенов выбирает на каждом шаге ровно 6 профильных экспертов, плюс к ним постоянно подмешивается 1 общий эксперт (shared expert), удерживающий глобальную связность синтаксиса.
В итоге процессор или видеокарта твоего компьютера совершают математические вычисления так, будто они крутят компактную модель на 2.5B, но логическая глубина и эрудиция берутся из гигантского 40-миллиардного хранилища знаний.
Автономное обучение через Eureka Machine и результаты SWE-bench Verified
Еще одна потрясающая деталь релиза — то, как именно была натренирована модель. Небольшая команда Recursive обучила Flint 40B менее чем за четыре месяца благодаря собственной платформе автономных исследований Eureka Machine.
Eureka Machine — это мета-система ИИ, которая сама генерировала тысячи синтетических программных репозиториев, моделировала миллионы циклов обучения с подкреплением (Reinforcement Learning), отслеживала компиляцию тестов и автоматически вычищала тупиковые ветки рассуждений. Человеческие инженеры выступали лишь постановщиками общих критериев и арбитрами.
Результаты в бенчмарках программной инженерии расставили все по местам:
- На авторитетнейшем бенчмарке SWE-bench Verified (где модели дают реальный баг-репорт из открытого репозитория, и она должна клонировать код, локализовать проблему, написать тест и сформировать корректный патч) Flint 40B показала 74.2%, став безоговорочным лидером среди всех открытых моделей до 50B параметров.
- На тесте соблюдения сложных многоуровневых инструкций IFEval модель выбила 95.1%.
- Контекстное окно составляет 262 144 токена, что позволяет загружать архитектурную документацию средних проектов целиком.
125 токенов в секунду на Apple Silicon и запуск в полностью изолированном контуре
В квантованном формате GGUF Q4_K_M файл модели весит около 23 ГБ. Это означает, что на любом MacBook Pro с чипом Apple M4 Pro или M3 Max и 48 ГБ объединенной памяти модель запускается играючи, оставляя достаточно места для операционной системы и IDE.
При этом скорость инференса на ноутбуке составляет стабильные 125–130 токенов в секунду, а на серверах с видеокартами уровня RTX 4090 переваливает за 150 токенов в секунду. Это быстрее, чем скорость чтения человека!
Чтобы поднять локальный сервер Flint 40B через популярный движок llama.cpp, достаточно одной команды в терминале:
# Запуск локального OpenAI-совместимого сервера Flint 40B
./llama-server \
  --model ./models/flint-40b-instruct-q4_k_m.gguf \
  --ctx-size 131072 \
  --n-gpu-layers 49 \
  --threads 12 \
  --port 8080 \
  --host 127.0.0.1
После запуска сервера ты можешь подключить Flint 40B к любому редактору кода (VS Code, Cursor, Neovim) или дергать локальный эндпоинт напрямую из скриптов на Python:
import openai

# Подключение к локальному инференсу Flint 40B
client = openai.OpenAI(
    base_url="http://127.0.0.1:8080/v1",
    api_key="local-dev-no-key-required"
)

response = client.chat.completions.create(
    model="flint-40b",
    messages=[
        {
            "role": "system",
            "content": "You are a senior systems engineer. Inspect memory allocations and optimize socket buffers."
        },
        {
            "role": "user",
            "content": "Find potential memory leaks in our epoll network event loop in src/net/worker.c"
        }
    ],
    temperature=0.1,
    max_tokens=2048
)

print(response.choices[0].message.content)
Лицензия Apache 2.0 развязывает руки для коммерческого использования: ты можешь развернуть ассистента в закрытом контуре компании, полностью исключив утечку исходников за пределы локальной сети.