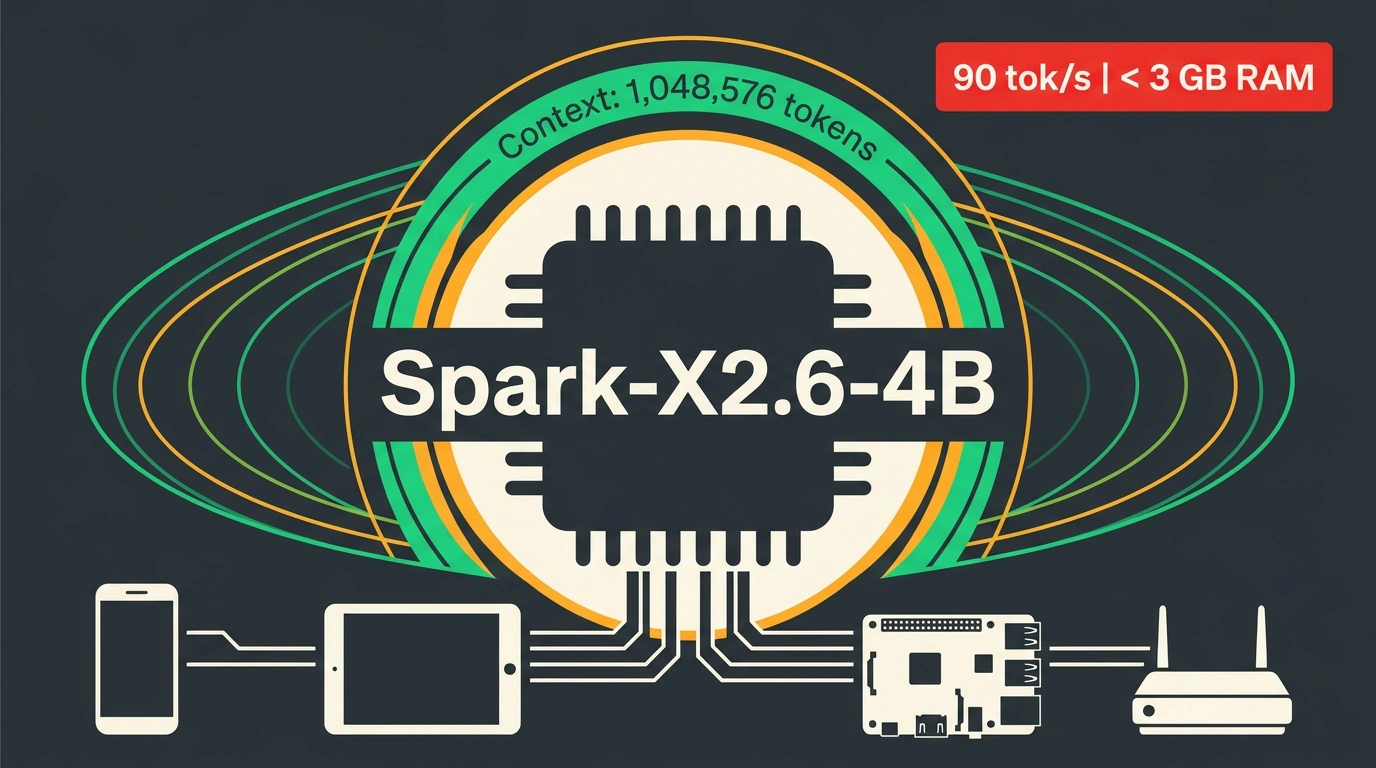


Долгое время в среде AI-инженеров существовало высокомерное предубеждение: всё, что меньше 7–8 миллиардов параметров — это бесполезные игрушки для демонстраций на смартфонах. Считалось, что на ультракомпактных весах невозможно добиться устойчивого следования инструкциям: модели путали форматы вывода, сваливались в зацикливания и начинали яростно галлюцинировать при малейшем усложнении задачи.
Однако релиз модели Spark-X2.6-4B, разработанной лабораторией XHToken (семейство SparkLLM), заставляет пересмотреть эти устаревшие догмы. Модель на 4 миллиарда параметров демонстрирует возможности, которые еще год назад требовали серверных сетей весом в 70B.
Гибридное внимание 3:1: как упаковать миллион токенов контекста в 3 гигабайта памяти
Главное препятствие для длинного контекста на малых весах — квадратичный рост объема кэша ключей и значений (KV-Cache). Если дать 4B-модели стандартное контекстное окно на миллион токенов, память видеокарты мгновенно забьется вспомогательными матрицами внимания.
Разработчики Spark-X2.6-4B решили эту проблему за счет элегантной гибридной схемы внимания:
- Три последовательных слоя трансформера используют локальное скользящее окно (Sliding-Window Attention, SWA), удерживая только ближайшие несколько тысяч токенов.
- Каждый четвертый слой переключается на глобальное внимание (Full Global Attention), связывая отдаленные концы документа воедино.
Такое соотношение 3:1 позволило развернуть гигантское контекстное окно в 1 048 576 токенов (1M). При этом в 4-битном квантовании вся модель вместе с кэшем занимает менее 3 ГБ оперативной памяти! Ее можно запустить на Raspberry Pi 5, планшете или плате банкомата.
Нововведения версии 2.6: режим размышлений и устранение зацикливаний
В версии 2.6 разработчики сосредоточились на пост-тренинге (Post-Training Alignment):
- Режим явных рассуждений (Explicit Reasoning Mode): модель поддерживает генерацию тегов
<think>, позволяя настраивать глубину внутренней цепочки мыслей перед выдачей структурированного ответа. - Алгоритм DPO против зависаний: в версии 2.5 при сложных логических ветвлениях модель иногда попадала в бесконечный цикл повторения одной фразы. В 2.6 применен специальный алгоритм оптимизации предпочтений, блокирующий зацикливания на корню.
- Безошибочный JSON: точность генерации строго структурированных данных выросла на 18%.
Ниже показан пример локальной классификации обращений в техподдержку с извлечением сущностей через библиотеку transformers:
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "XHToken/Spark-X2.6-4B"
tokenizer = AutoTokenizer.from_pretrained(model_id, trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    torch_dtype=torch.bfloat16,
    device_map="auto",
    trust_remote_code=True
)

prompt = """<|system|>
You are a high-speed edge classifier. Classify customer tickets and output JSON.
<|user|>
Списали 2490 рублей за тариф Бизнес, но доступ в личный кабинет закрыт. Договор #98124.
<|assistant|>
<think>
Категория: Billing (списание) + Account (доступ). Главная причина обращения — биллинг.
Сущности: договор 98124, сумма 2490, тариф Бизнес.
</think>
{"category": "Billing", "contract_id": "98124", "amount": 2490, "tier": "Бизнес"}"""

inputs = tokenizer(prompt, return_tensors="pt").to(model.device)
outputs = model.generate(**inputs, max_new_tokens=256, temperature=0.1)
print(tokenizer.decode(outputs[0][inputs.input_ids.shape[1]:], skip_special_tokens=True))
А для запуска в локальной утилите Ollama достаточно одной стандартной команды:
# Локальный запуск квантованной версии Spark-X2.6-4B в Ollama
ollama run spark-x2.6-4b:latest "Классифицируй входящий финансовый документ"
Сценарии для периферии: первая линия поддержки и онбординг
Благодаря скорости генерации свыше 90 токенов в секунду на обычных процессорах, Spark-X2.6-4B становится идеальным инструментом для автоматизации первой линии:
- Мгновенная сортировка сотен тысяч входящих писем клиентов без затрат на облачные API.
- Локальный онбординг в мобильных приложениях без отправки персональных данных пользователя на сервер.
- Лицензия Apache 2.0 дает полную свободу внедрения в коммерческие продукты.