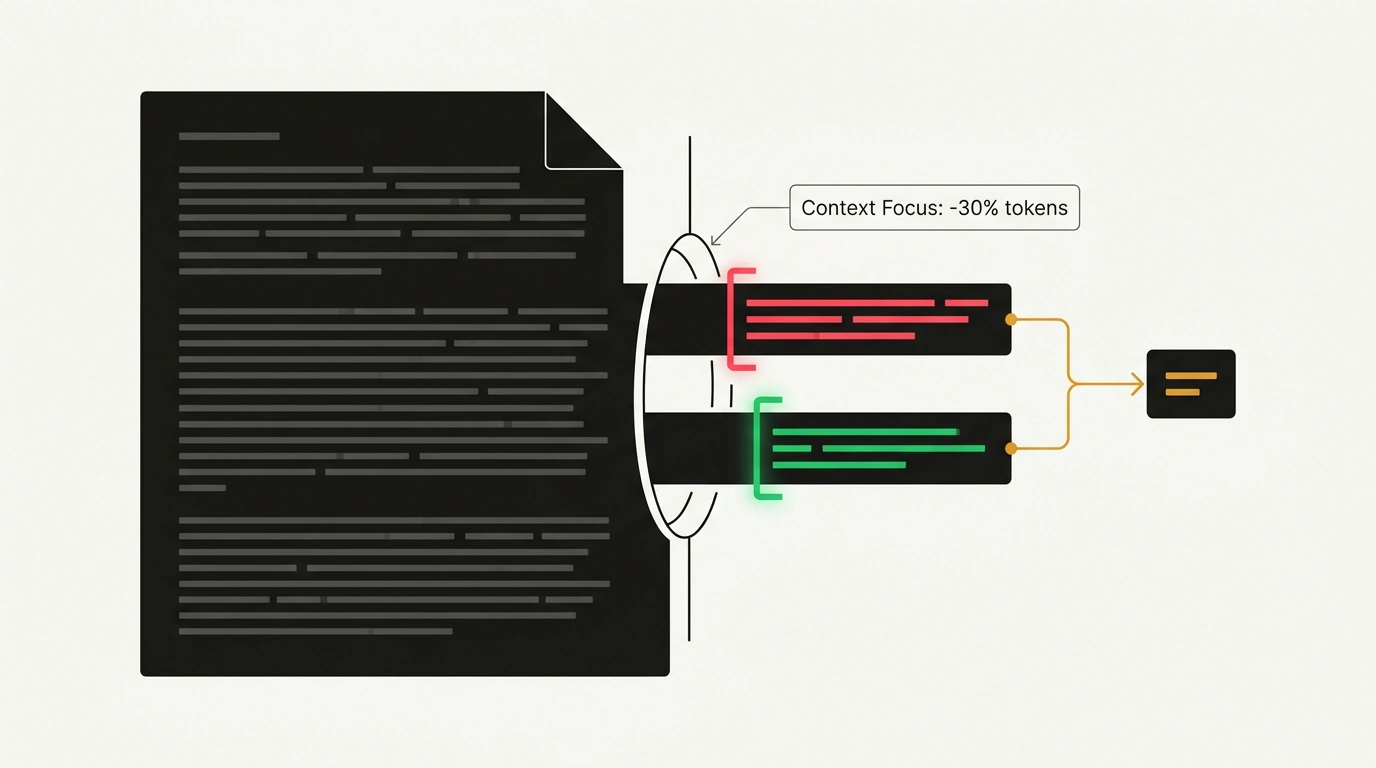


Классическая ошибка при построении поисковых пайплайнов RAG выглядит знакомо. Разработчик настраивает векторную базу, делает поиск по эмбеддингам, вытаскивает десяток полных текстовых чанков и без разбора отправляет их в контекст дорогой генеративной модели. В итоге большую часть контекста занимает посторонний информационный мусор, счет за токены растет, а нейросеть страдает от эффекта «потери в середине» (lost in the middle), упуская нужную строчку среди страниц технической воды.
Релиз семейства моделей Cohere Rerank 5 решает эту проблему на корню. Главное нововведение версии — механизм Context Focus, который не просто переставляет документы местами по релевантности, но и хирургически вырезает из них точечные смысловые фрагменты, сокращая расходы на контекст более чем на треть.
Два бойца: версии Pro и Fast под разные нагрузки
В пятом поколении линейка Rerank разделилась на две специализированные модели под разные сценарии:
rerank-v5.0-pro— флагманская модель максимальной точности. Она создана для сложного анализа технической документации, нормативных актов, финансовых отчетов и полуструктурированных таблиц.rerank-v5.0-fast— легковесная модель с минимальной задержкой. Этот вариант оптимизирован под высоконагруженные агентские циклы, где реранжирование вызывается десятки раз в минуту в фоновом режиме.
Обе модели получили расширенное контекстное окно до 32 000 токенов (в предыдущем поколении лимит составлял лишь 4 000 токенов), нативную поддержку более 100 языков и способность напрямую разбирать структуры JSON и YAML без сглаживания в плоский текст.
Кроме того, в Rerank 5 появились калиброванные оценки релевантности (calibrated scores). Раньше разработчикам приходилось гадать и отбирать фиксированное число документов через параметр top_n. Теперь баллы релевантности отнормированы и сопоставимы между запросами, что позволяет задавать строгий порог отсечения (например, брать только фрагменты со score > 0.35).
Механизм Context Focus: вырезать шум прямо на входе
Ключевой архитектурный прорыв Rerank 5 — функция Context Focus. Стандартный реранкер получает на вход список найденных документов и возвращает их в новом порядке, но сами документы остаются неизменными. Если в массивном регламенте на 2000 слов полезной оказалась лишь одна фраза о сроках гарантии, в генеративную модель все равно улетал весь блок.
Context Focus работает иначе: модель анализирует текст документа и возвращает точные диапазоны символов (start и end), содержащие прямой ответ на вопрос. При формировании финального промпта для генератора ты передаешь только эти извлеченные абзацы. По данным тестов Cohere, это сокращает объем контекста более чем на 30% при одновременном снижении риска галлюцинаций.
Если ты системно занимаешься оптимизацией расходов на инфраструктуру, рекомендую изучить наши материалы про стратегии снижения затрат на API-запросы и методики сжатия контекста Ponytail. Связка предварительной фильтрации с точечным реранжированием дает ощутимую экономию в продакшене.
Практика интеграции: Python SDK и LlamaIndex
Подключение Context Focus в Python выполняется через официальный клиент Cohere API v2 с передачей параметра relevant_spans:
import cohere

# Инициализация клиента Cohere API v2
co = cohere.ClientV2(api_key="COHERE_API_KEY_HERE")

documents = [
    "Регламент возврата оборудования: клиент обязан уведомить поддержку в течение 14 дней с момента поставки.",
    "История основания компании: первый офис был открыт в Торонто в 2019 году группой исследователей.",
    "Условия гарантийного обслуживания: при нарушении пломбы корпус признается негарантийным."
]

query = "В какой срок необходимо сообщить о возврате оборудования?"

# Вызов rerank-v5.0-pro с извлечением точечных интервалов ответа
response = co.rerank(
    model="rerank-v5.0-pro",
    query=query,
    documents=documents,
    top_n=2,
    relevant_spans={"mode": "enabled", "threshold": 0.15, "max_spans": 2}
)

for rank, result in enumerate(response.results):
    doc_text = documents[result.index]
    print(f"Ранг {rank + 1} | Score: {result.relevance_score:.4f}")
    if hasattr(result, "relevant_spans") and result.relevant_spans:
        for span in result.relevant_spans:
            print(f"  -> Context Focus: {doc_text[span['start']:span['end']]}")
В поисковом стеке на базе LlamaIndex модель встраивается в качестве пост-процессора узлов:
from llama_index.core import VectorStoreIndex
from llama_index.postprocessor.cohere_rerank import CohereRerank

# Настройка узла реранжирования с быстрой моделью Rerank 5 Fast
reranker = CohereRerank(
    model="rerank-v5.0-fast",
    api_key="COHERE_API_KEY_HERE",
    top_n=3
)

# Построение движка с первичной выборкой и последующим сжатием
query_engine = index.as_query_engine(
    similarity_top_k=15,
    node_postprocessors=[reranker]
)

response = query_engine.query("Каковы штрафы за несоблюдение SLA во 2 квартале?")
print(str(response))
Механизм показывает наилучшие результаты на крупных чанках текста размером от 1 000 до 10 000 символов (статьи, регламенты, отчеты). На мелких фрагментах короче 100 знаков накладные расходы на вычисление интервалов не компенсируют экономию токенов.
Границы применения и экономический баланс
Главное ограничение Cohere Rerank 5 связано с сетевой зависимостью: модель доступна как облачный сервис, что требует учета задержек. Кроме того, опция Context Focus по умолчанию выключена, поэтому ее нужно явно активировать в коде через словарь relevant_spans.
Тем не менее, внедрение выделенного реранкера полностью оправдывает себя в любой корпоративной базе знаний. Затраты на вызов Rerank 5 на порядки ниже стоимости прогона лишних токенов через генеративные LLM, а точность ответов перестает страдать от случайного мусора в выборке.