
Когда в середине 2024 года компания Anthropic представила функционал Projects внутри веб-интерфейса Claude, корпоративный мир охватила волна эйфории. Казалось, священный грааль автоматизации наконец-то найден. Инструкция выглядела до смешного простой: собери в одну папку все PDF-отчеты компании, регламенты продаж, должностные инструкции, брендбуки с Tone of Voice и образцы успешных писем, перетащи их в окно проекта — и вуаля! Перед тобой сидит идеальный цифровой сотрудник, который досконально знает твой бизнес и готов в любую секунду выдать безупречный результат.
Однако спустя несколько месяцев эйфория сменилась глухим раздражением. Руководители и маркетологи обнаружили, что созданные «умные проекты» работают из рук вон плохо. На сложные запросы модель начинает выдавать водянистые, стерильные ответы, путает старые и новые тарифы, противоречит собственным правилам и упорно игнорирует критически важные пункты регламентов.
В чем причина этого системного кризиса? Почему надежда на гигантские статические контексты оказалась опасной иллюзией и как на самом деле нужно проектировать промышленные решения на базе моделей Claude 3.5 Sonnet и Claude Opus 5.5?
Ответы на эти вопросы дали ведущие мировые практики корпоративного внедрения генеративного ИИ — Киран Фланаган (экс-CMO HubSpot, автор аналитического подкаста Marketing Against the Grain) и Рубен Хассид (основатель образовательной платформы по промпт-инжинирингу). Мы уже изучали опыт построения компаний одного человека на стеке Claude и ИИ-агентов, а также разбирали инженерные правила промптинга ведущего инженера Anthropic Феликса Райсберга. Теперь мы погрузимся в глубинную анатомию динамического промптинга и разберем шесть универсальных архитектурных архетипов, превращающих Claude в безотказное операционное ядро компании.
Иллюзия статического контекста: почему свалка документов в Claude Projects не работает
Давай честно признаем горькую правду: привычка сваливать документы в статические папки проектов (Projects) — это худшее, что можно сделать с языковой моделью.
На первый взгляд кажется, что контекстное окно в 200 000 токенов или даже миллион токенов снимает любые ограничения. Но архитектура трансформеров устроена так, что внимание модели не распределяется по тексту абсолютно равномерно. Когда ты загружаешь в проект двадцать файлов общим объемом в сотню тысяч токенов, происходит сразу несколько деструктивных процессов:
- Контекстное размывание (Context Dilution). Механизм самовнимания вынужден непрерывно сопоставлять каждое входящее слово запроса с гигантским массивом справочной информации. Чем больше лишнего шума находится в контексте, тем ниже вероятность того, что модель сфокусируется на критически важном предложении.
- Эрозия актуальности (Knowledge Decay). В любом живом бизнесе процессы меняются еженедельно: запускаются новые рекламные акции, корректируются условия возврата товара, обновляются скрипты работы с возражениями. Забытый в папке полугодовой PDF-файл со старыми регламентами становится постоянным источником токсичных галлюцинаций, которые модель уверенно скармливает клиентам.
- Внутренние противоречия. Если в брендбуке 2023 года написано «мы общаемся строго на "Вы" и сохраняем академический тон», а в свежей инструкции для соцсетей указано «пиши дерзко и на "ты"», модель усреднит эти требования. На выходе получится неуклюжий франкенштейн, не удовлетворяющий ни одному из стандартов.
Сам факт загрузки файла в проект не создает у модели поведенческого рефлекса. Ей нужен строгий алгоритмический маршрутизатор, который подает нужные знания точно в момент принятия решения.
Анатомия деградации внимания: эффект потери информации в середине окна
В академических кругах феномен ухудшения работы моделей на длинных контекстах давно известен под термином Lost in the Middle («Потерянные в середине»).
Исследования показывают, что трансформеры лучше всего запоминают информацию, расположенную в самом начале контекста (эффект первичности) и в самом конце (эффект свежести). Если ключевое правило или критическое исключение из тарифа оказалось спрятано на сороковой странице загруженного в середину документа, вероятность того, что модель вспомнит о нем при формировании ответа, стремительно падает.
Представь человеческую память: если перед экзаменом дать студенту прочитать пятисотстраничную энциклопедию, а потом задать точечный вопрос по сноске на странице 248, он неизбежно растеряется. Точно так же ведет себя нейросеть. Вместо того чтобы удерживать в голове гигантскую статическую энциклопедию, современный инженер обязан построить систему, которая извлекает из базы данных строго один нужный абзац и подает его модели прямо перед генерацией ответа.
Именно этот подход лежит в основе методологии динамического внедрения контекста (Dynamic Context Injection).
Чтобы эта динамическая маршрутизация не превращалась в хаотичный набор самодельных скриптов, Фланаган и Хассид формализовали шесть фундаментальных промпт-архетипов, закрывающих 95% корпоративных потребностей:
- Архетип «Извлекатель» (The Extractor). Превращает неструктурированный поток данных (расшифровки звонков в Zoom, записи интервью, юридические договоры, сырые отзывы) в строго типизированные таблицы или JSON-схемы. Главный закон здесь: жесткий запрет на домысливание. Если в тексте нет точной суммы сделки или должности контактного лица, поле обязано остаться со значением
null. - Архетип «Оппонент-критик» (The Adversary / Critic). Выступает в роли безжалостного оппонента для стресс-тестирования маркетинговых гипотез, бизнес-планов и архитектурных схем до выделения реальных денег. Модели категорически запрещается расточать похвалы: она обязана найти пять критических уязвимостей и смоделировать наихудший сценарий развития событий.
- Архетип «Синтезатор смыслов» (The Synthesizer). Сопоставляет разнородные информационные пласты — метрики рекламной воронки, отзывы оттока клиентов из опросов и логи тикетов поддержки — находя неочевидные причинно-следственные связи, скрытые от беглого взгляда аналитика.
- Архетип «Оркестратор процессов» (The Orchestrator). Раскладывает абстрактную цель руководства на детализированное дерево шагов с оценкой ресурсов, зависимостями и четкими критериями готовности (Definition of Done).
- Архетип «Голосовой калибратор» (The Voice Mimic). Воспроизводит уникальный авторский стиль фаундера или эксперта компании на основе предварительного стилометрического анализа эталонных текстов в блоке
<scratchpad>. - Архетип «Шлюз соответствия» (The Policy Gate / Governor). Работает как беспристрастный контролер качества, сверяющий любой исходящий контент с юридическими требованиями и корпоративным регламентом.
Архитектура динамической маршрутизации: подача регламентов точно в срок
Концепция динамического промптинга утверждает: контекст — это не постоянное хранилище, а переменная функция от текущего действия (Context-as-a-Function).
Вместо того чтобы держать в активном окне модели все регламенты компании разом, архитектура делится на два независимых контура:
- Внешнее структурированное хранилище. Все правила, шаблоны, базы знаний и карточки продуктов лежат во внешней базе данных (векторной базе вроде Pinecone, реляционной PostgreSQL или локальном каталоге Markdown-файлов).
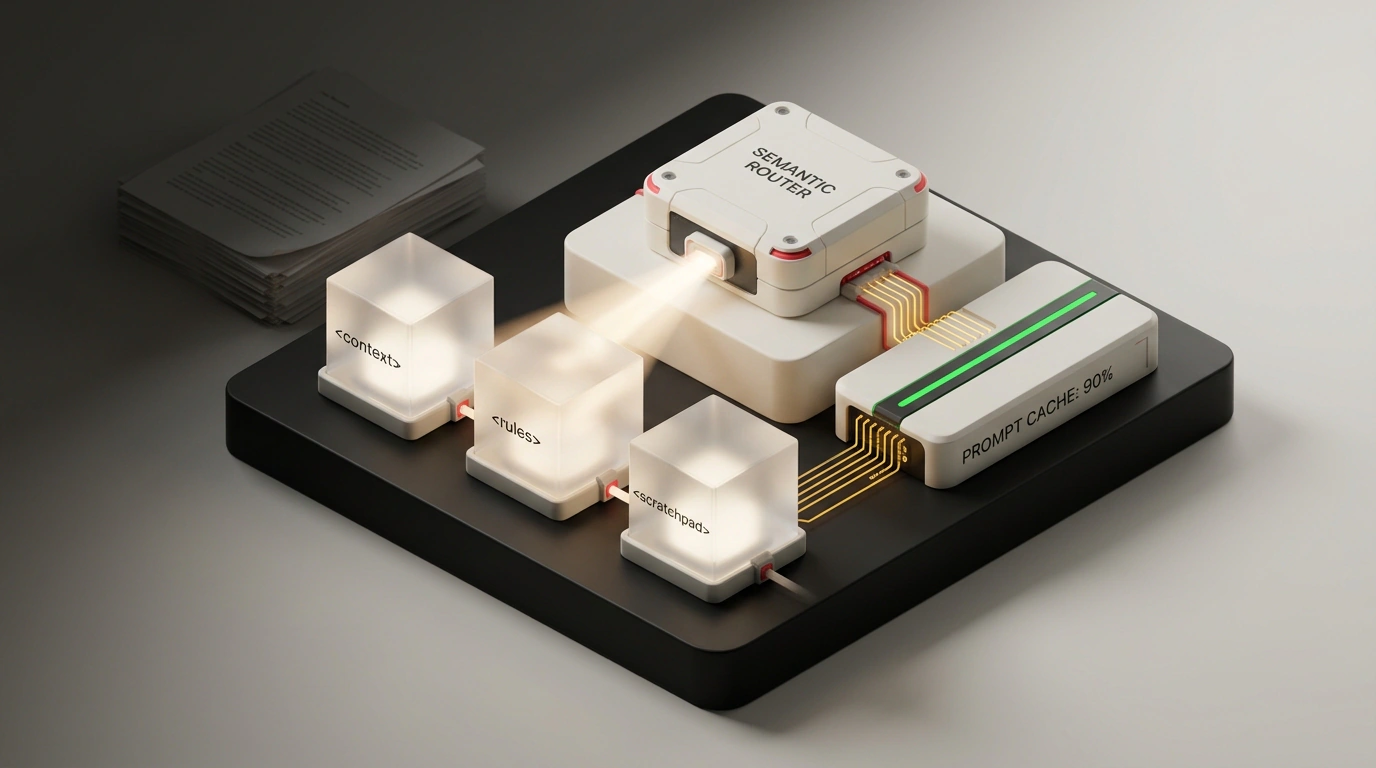
- Семантический маршрутизатор (Semantic Router). Когда поступает входящий запрос от пользователя, легковесный классификатор анализирует его намерение (интент). Если клиент спрашивает о возврате денег, система динамически подтягивает из базы ровно один регламент возврата (две страницы текста) и упаковывает его в промпт. Если же клиент интересуется партнерской программой, подтягивается партнерский договор.
В результате объем контекста сокращается с двухсот тысяч токенов до трех тысяч. Модель видит только кристально чистую, непротиворечивую и актуальную инструкцию по конкретному узкому вопросу. Плотность внимания возрастает многократно, а риск галлюцинаций снижается практически до нуля.
Модульные XML-промпты: разделение ролей, правил и рабочей памяти
Чтобы Claude работал с максимальной математической точностью, инженеры Anthropic рекомендуют использовать строгую разметку тегами XML. Модели семейства Claude проходили специальное обучение на структурированных XML-документах, поэтому они воспринимают такие теги как абсолютные системные границы, отделяющие инструкции от пользовательских данных.
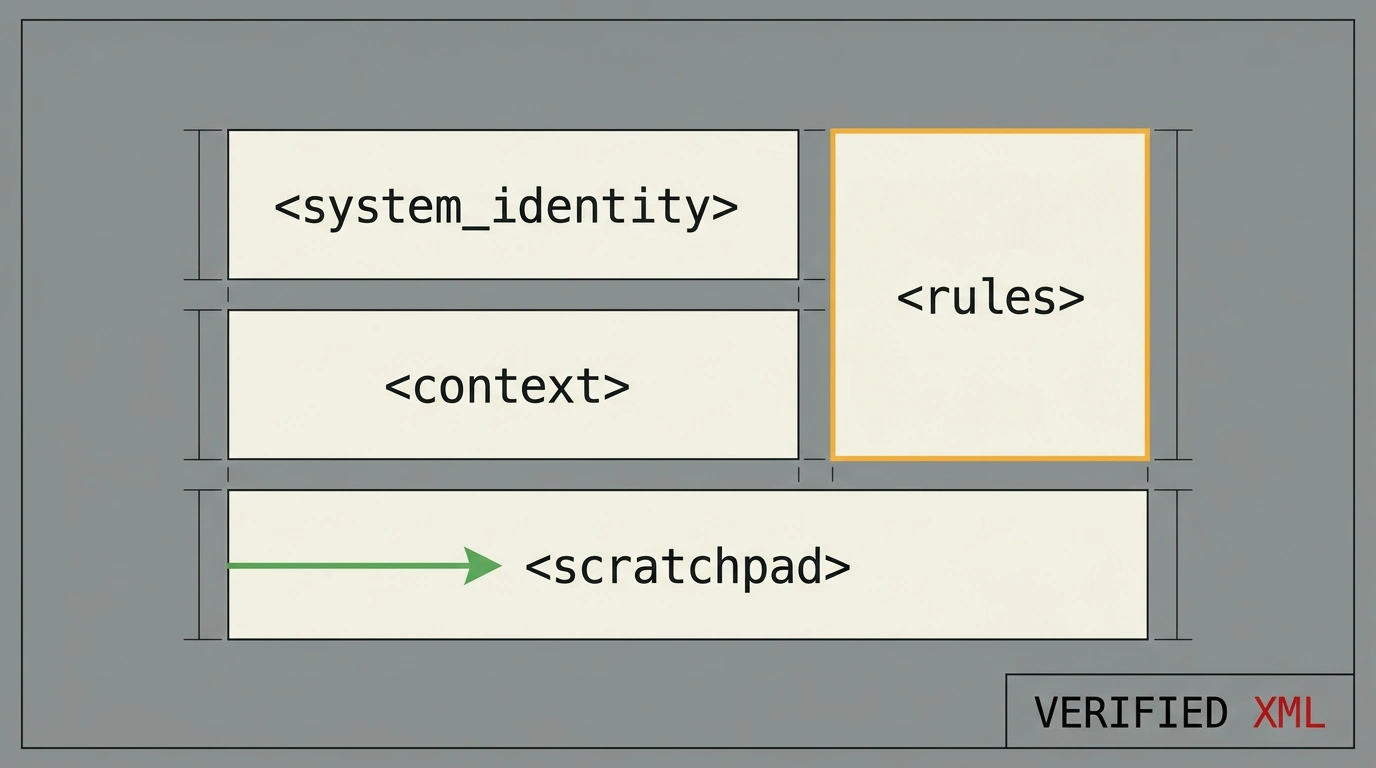
Базовая архитектура промышленного модульного промпта делится на четыре ключевых блока:
<system_identity>
Ты — старший аудитор информационной безопасности. Твоя единственная цель — находить уязвимости в кодовой базе.
</system_identity>

<context>
{здесь динамически подставляется релевантный фрагмент документации}
</context>

<rules>
- Никогда не домысливай параметры, которых нет во входящих данных.
- Если информации недостаточно, верни статус UNVERIFIED.
- Ответ строго в формате JSON по указанной схеме.
</rules>

<scratchpad>
Прежде чем сгенерировать ответ, проведи пошаговый анализ в этом блоке:
1. Выдели ключевые сущности.
2. Проверь совпадение со списком исключений.
3. Сформулируй итоговый вывод.
</scratchpad>
Блок <scratchpad> (черновик рассуждений) имеет колоссальное значение. Когда модель проговаривает свои мысли и проверяет гипотезы внутри тегов черновика, она физически генерирует промежуточные токены рассуждения. Это многократно повышает логическую связность и позволяет избежать скороспелых ошибок в финальном выводе.
Экономика кэширования: как сократить задержку и срезать 90% расходов на API
Переход к профессиональному использованию Claude в корпоративной среде невозможен без понимания экономики кэширования промптов (Prompt Caching). До появления этой технологии каждый запрос к API тарифицировался по полной стоимости всего переданного контекста. Если твой системный промпт с примерами занимал 30 000 токенов, то при тысяче обращений в день ты сжигал астрономические суммы на повторной передаче одного и того же текста.
В API Anthropic механизм кэширования устроен поразительно элегантно:
- Ты помечаешь статическую часть своего промпта (системные правила, описание схемы JSON, неизменяемые примеры хороших ответов) специальным параметром
cache_control: {"type": "ephemeral"}. - При первом обращении сервер компилирует внутреннее представление этого контекста и сохраняет его в высокоскоростном кэше на 5 минут.
- При каждом последующем запросе, содержащем этот закэшированный блок, ты платишь всего 10% от базового тарифа на входные токены.
- Срок жизни кэша автоматически продлевается еще на 5 минут при каждом новом попадании.
Но финансовая экономия — это лишь половина выигрыша. Вторая половина — это время отклика (TTFT). Обработка закэшированного блока в 50 000 токенов занимает у серверов не 6–8 секунд, а буквально 300–500 миллисекунд. Твой сервис начинает отвечать пользователю с потрясающей интерактивной скоростью.
Шлюзы валидации: строгие JSON-схемы и контроль галлюцинаций
Даже самый идеальный промпт иногда может дать сбой, если модель решит проявить неуместную творческую инициативу. В корпоративных системах автоматизации неструктурированный текст — это главный источник головной боли для разработчиков бэкенда. Невозможно надежно распарсить регулярными выражениями вольный рассказ нейросети о том, какую скидку она решила согласовать клиенту.
Решение заключается во внедрении жестких шлюзов валидации:
- Принудительный вывод в JSON (Structured Outputs). Модели передается схема Pydantic или JSON Schema, описывающая типы полей, обязательные атрибуты и допустимые диапазоны значений (Enums).
- Программный верификатор (Validator Gate). Ответ модели не отправляется клиенту напрямую. Он попадает в локальный бэкенд, который валидирует структуру через библиотеку парсинга. Если модель пропустила обязательное поле или вернула невалидную дату, система автоматически делает повторный вызов с указанием точной ошибки валидации.
- Шлюз соответствия (Policy Gate). Перед отправкой критических документов специальный агент-контролер прогоняет текст через бинарный чеклист на соответствие закону о персональных данных, правилам вежливости и отсутствию ложных обещаний.
Разбор реального внедрения: автоматизация клиентской поддержки с измеримым SLA
Давай сведем всю теорию воедино и посмотрим, как эти принципы работают на примере реального кейса: автоматизация первой линии поддержки в компании, предоставляющей облачные B2B-сервисы.
Раньше компания пыталась использовать стандартный чат-бот, куда была загружена вся база знаний из 150 статей. Бот постоянно путался, советовал клиентам функции из устаревших тарифов и требовал постоянного вмешательства живых операторов. Показатель решения проблемы с первого контакта (First Contact Resolution, FCR) составлял жалкие 28%.
Инженеры полностью перестроили систему по новой методологии:
- Шаг 1: Семантическая классификация. Входящий запрос клиента поступает на легковесный роутер, который за 50 миллисекунд определяет категорию проблемы (биллинг, баг в API, интеграция с CRM, общий вопрос).
- Шаг 2: Динамическая сборка контекста. Из базы знаний подтягивается ровно одна профильная статья с актуальными параметрами API и статусом текущих инцидентов на серверах.
- Шаг 3: Модульный промпт с кэшированием. В Claude Opus 5.5 отправляется закэшированный системный блок с правилами вежливости и JSON-схемой, куда динамически вставляется свежая статья и текст клиента. В блоке
<scratchpad>модель сначала сверяет статус серверов, проверяет права пользователя и только потом формирует ответ. - Шаг 4: Программный шлюз. Ответ проверяется на отсутствие запрещенных обещаний («мы вернем деньги в течение часа») и отправляется в тикет-систему.
Результаты внедрения превзошли все ожидания:
- Показатель FCR подскочил с 28% до 79%.
- Время ответа клиенту сократилось с 14 минут до 18 секунд.
- Расходы на вызовы API упали в 7 раз за счет кэширования статических блоков инструкций.
- Количество жалоб на дезинформацию со стороны бота снизилось до статистического нуля.
Этот мастер-класс доказывает: успех внедрения ИИ в бизнесе зависит не от слепой веры в магию нейросетей, а от зрелой инженерной дисциплины. Откажись от свалки статических файлов, собирай контекст динамически под конкретную задачу, внедряй модульные XML-структуры и экономь бюджет через кэширование — и твои системы перейдут на принципиально новый уровень надежности.