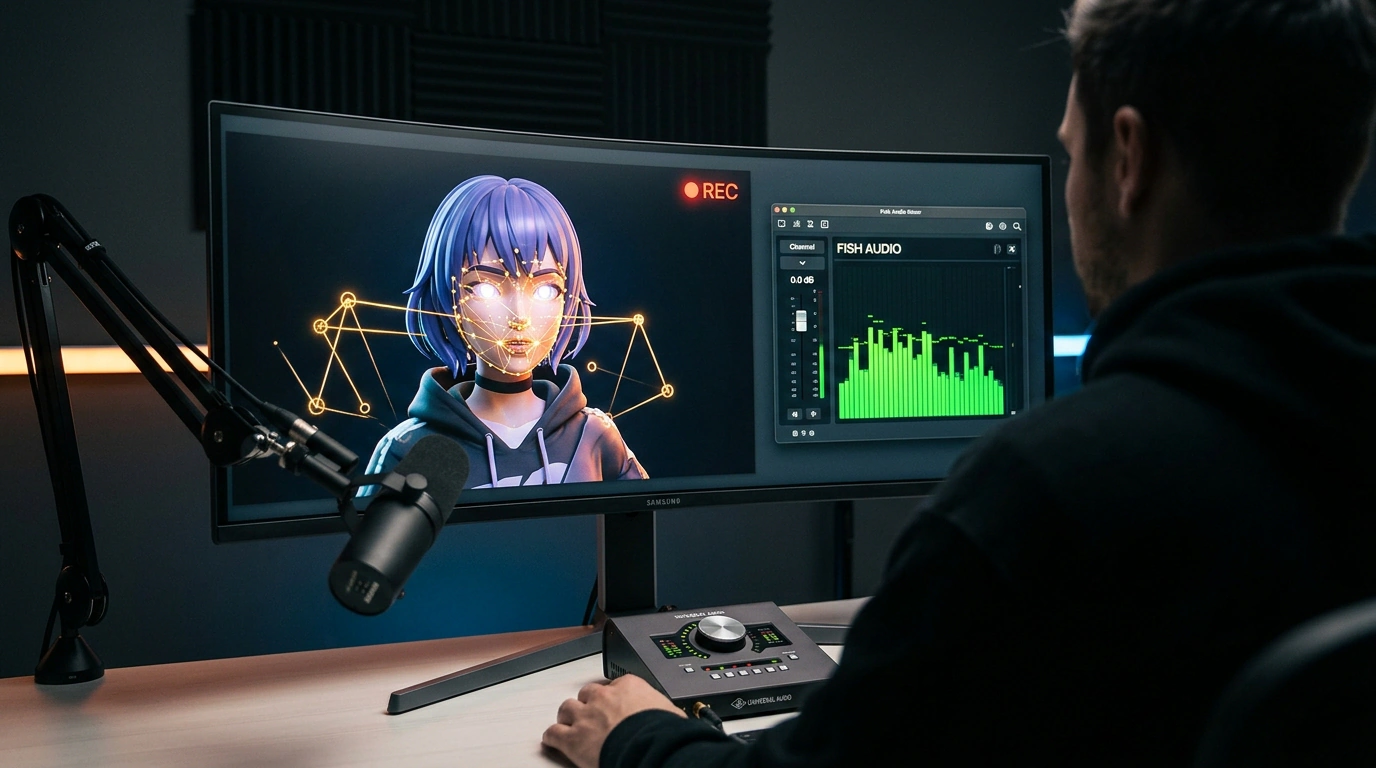

Если ты хоть раз пробовал запускать собственный образовательный YouTube-канал или записывать видеоуроки для онлайн-курса, то прекрасно знаешь, на чем ломается большинство начинающих авторов. Это вовсе не сценарий и не дефицит знаний. Главный барьер — классическое студийное производство.
Тебе нужно купить приличную камеру, настроить трехточечный свет, бороться с шумом микрофона, накладывать грим, чтобы лицо не блестело под софитами, и часами переписывать дубли, спотыкаясь о сложные термины. Добавь сюда естественный психологический зажим перед объективом, и создание одного двадцатиминутного ролика превращается в каторгу на несколько выходных подряд.
Индустрия вирусного контента давно нашла обходной путь: так называемые безликие каналы (Faceless Channels). Но если раньше под этим понимали унылые слайд-шоу с роботизированным голосом из бесплатного онлайн-синтезатора, то сегодня технологии вышли на принципиально иной уровень. Практик автоматизации Ник Сараев структурировал законченный конвейер производства образовательных видео на базе виртуальных персонажей (AI VTubers) и нейросетевого клонирования голоса.
Давай разберем архитектуру этой фабрики контента, которая позволяет методисту в одиночку выпускать десятки профессиональных уроков в неделю.
Голосовое ядро Fish Audio: живые паузы и эмоциональные теги
Главная беда старых синтезаторов речи — абсолютная безжизненность интонаций. Монотонный механический бубнеж усыпляет зрителя уже на второй минуте, а YouTube безжалостно режет охваты таким видео.
В современном конвейере в качестве звукового ядра используется платформа Fish Audio. В чем ее прорыв?
- Нулевое клонирование голоса (Zero-shot Voice Cloning). Чтобы скопировать тембр живого эксперта, достаточно загрузить чистый 15-секундный аудиофайл без фоновой музыки.
- Естественное дыхание и смысловые паузы. Модель нативно поддерживает расстановку вздохов, естественных запинок, повышение интонации при вопросах и смысловые акценты на ключевых терминах.
- Пакетная генерация по API. Методист пишет сценарий в Markdown, нажимает кнопку, и система за пару минут генерирует кристально чистую аудиодорожку студийного качества.
Визуальный аватар: Live2D против 3D-моделей в VRoid Studio
В роли лектора выступает цифровой персонаж. В зависимости от стилистики проекта используются два направления:
- 2D-иллюстрации (Live2D в связке с VTube Studio). Идеально подходит для аниме-эстетики или мультяшных персонажей-маскотов компании. Художник рисует персонажа по слоям, а программа VTube Studio оживляет его движения.
- 3D-аватары (VRoid Studio). Полностью бесплатный редактор, в котором можно за пару часов собрать объемную фигуру лектора в деловом костюме, настроить прическу и цвет глаз, а затем экспортировать стандартный файл модели формата VRM в среду Warudo или Unity.
Аудио-реактивный липсинг через виртуальный кабель: рот двигается в такт речи
А вот здесь кроется главный технический трюк. В классическом стриминге блогер сидит перед веб-камерой, а нейросеть считывает мимику его лица. Но цель нашего конвейера — полная автоматизация без живого человека в кадре!
Как заставить нарисованного персонажа реалистично открывать рот синхронно сгенерированному голосу? Используется виртуальный аудиошлюз (VB-Audio Cable). Звуковой поток из Fish Audio направляется на виртуальный аудиовыход, который в настройках VTube Studio или Warudo выбирается в качестве микрофона.
Специальный аудио-реактивный плагин (Audio-Based Lip Sync) анализирует амплитуду и частотный спектр речи в реальном времени. Когда алгоритм слышит звуки «А» или «О», рот аватара распахивается шире, на звуках «И» и «Е» растягивается в улыбке, а в моменты пауз между предложениями персонаж мягко закрывает рот и моргает.
Финальный шаг — вывод персонажа на прозрачном фоне в OBS Studio поверх обучающих слайдов или демонстрации экрана с кодом.
В результате себестоимость часа готового обучающего видео сокращается в десять раз: исчезают расходы на операторов, монтажеров и аренду студий, а эксперт получает возможность делиться знаниями, сохраняя полную приватность личной жизни.