
В гонке языковых моделей долгое время существовал непреодолимый водораздел: с одной стороны — закрытые проприетарные гиганты (Claude 3.7 Sonnet, GPT-4o) с недосягаемым качеством рассуждений и написания сложного кода, с другой — открытые веса, которые можно запускать на собственном сервере, но которые ощутимо спотыкаются на комплексных архитектурных задачах.
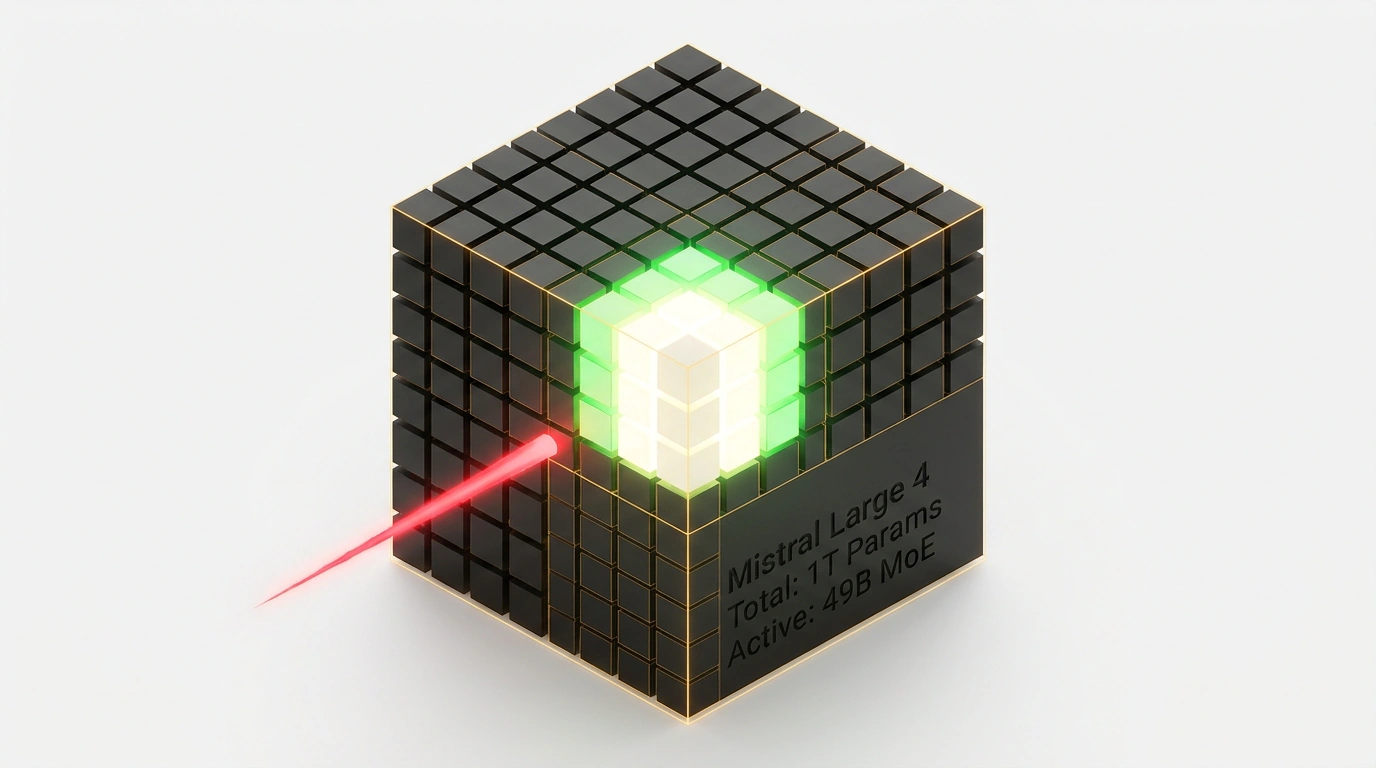
Французская лаборатория Mistral AI нанесла мощный удар по этой монополии, представив модель Mistral Large 4. Это настоящий колосс с архитектурой смеси экспертов (Mixture of Experts, MoE): общий пул параметров модели превышает 1 триллион, однако благодаря избирательной маршрутизации токенов на каждом шаге инференса активируются всего 49 миллиардов параметров. Мы уже следили за эволюцией архитектуры Mistral Large Le Chonk, а четвертая версия доводит эту концепцию до производственного совершенства.
Архитектура MoE: триллион весов без экспоненциального замедления
Почему подход смеси экспертов так важен для программирования? Классические плотные (dense) модели при каждом сгенерированном токене вынуждены активировать абсолютно все веса сети. Для модели размером в триллион параметров это потребовало бы чудовищных вычислительных ресурсов и привело бы к черепашьей скорости генерации в 1–2 токена в секунду.
В Mistral Large 4 сеть разбита на десятки специализированных экспертных блоков. Маршрутизатор (Router Gate) анализирует входящий контекст и направляет вычисления только тем экспертам, которые специализируются на текущей задаче (например, синтаксический анализ C++, оптимизация SQL-запросов или доказательство математических теорем).
В результате:
- Колоссальная эрудиция: Модель удерживает в весах глубокое понимание сотен языков программирования, фреймворков и устаревших библиотек.
- Высокая скорость инференса: На этапе генерации нагрузка на память эквивалентна компактной 49B-модели, что обеспечивает комфортные 35–45 токенов в секунду на современных серверных кластерах.
- Контекстное окно 128 000 токенов: Модель способна переварить архитектуру крупного сервиса целиком, находя скрытые баги в межмодульном взаимодействии.
- Нативная поддержка вызова функций (Function Calling): Модель обучалась на структурированных данных и возвращает строгие JSON-схемы без выпадения из формата.
- Продвинутый математический вывод: При решении алгоритмических олимпиадных задач сеть демонстрирует стабильные цепочки рассуждений (Chain of Thought) без потери промежуточных переменных.
Развертывание через vLLM и вызов через SDK
Для практического запуска локального инференса такого масштаба требуется распределенный сервер на 8 ускорителях уровня NVIDIA H100 или A100 (80GB) с поддержкой 8-битного квантования FP8.
Запуск инференс-сервера с тензорным параллелизмом через vLLM выполняется следующей конфигурацией:
# Установка свежей версии vLLM с оптимизированными ядрами MoE
pip install --upgrade vllm

# Запуск распределенного сервера на 8 GPU с тензорным параллелизмом
python3 -m vllm.entrypoints.openai.api_server     --model mistralai/Mistral-Large-4-Instruct-FP8     --tensor-parallel-size 8     --max-model-len 32768     --gpu-memory-utilization 0.95     --port 8000
А вот так выглядит вызов модели для сложной задачи системного программирования через официальный Python SDK Mistral:
from mistralai import Mistral

api_key = "local_or_cloud_key"
client = Mistral(api_key=api_key)

prompt = "Напиши высокопроизводительный пул потоков на C++20 с поддержкой work-stealing алгоритма и unit-тестами."

response = client.chat.complete(
    model="mistral-large-latest",
    messages=[
        {"role": "system", "content": "You are a world-class principal C++ systems architect."},
        {"role": "user", "content": prompt}
    ],
    temperature=0.2,
    max_tokens=4096
)

print(response.choices[0].message.content)
Бенчмарки и реальная стоимость владения
В независимых тестах на программирование (HumanEval, SWE-bench Verified) Mistral Large 4 демонстрирует впечатляющие 88.4% решения реальных задач из репозиториев GitHub, практически наступая на пятки флагману от Anthropic. Модель прекрасно ориентируется в многопоточных примитивах, корректно использует барьеры памяти и пишет идиоматичный код.
Однако для энтузиастов и небольших студий главный сдерживающий фактор — инфраструктурный порог входа. Аренда серверного узла с 8 картами H100 обходится в 20–25 долларов в час. Полноразмерный чекпоинт весит более 600 гигабайт даже в квантованном виде, что требует скоростных NVMe-накопителей и высокоскоростной шины Infiniband для межпроцессорного обмена.
Впрочем, сообщество уже экспериментирует с более агрессивными форматами квантования (4-битный AWQ и GPTQ), которые позволяют ужать модель до 240 гигабайт и запустить её на четырех видеокартах RTX 6000 Ada или двух узлах Mac Studio M3 Ultra с объединенной памятью 192 ГБ. В таких конфигурациях скорость генерации падает до 12–15 токенов в секунду, но возможность иметь карманный триллион параметров без отправки кода наружу для многих закрытых лабораторий перевешивает любые задержки.
Поэтому для большинства команд наиболее рациональным сценарием остается использование официального API Mistral с оплатой за фактически потребленные токены, сохраняя возможность экстренной миграции весов в собственный закрытый контур при ужесточении корпоративных требований к защите данных.