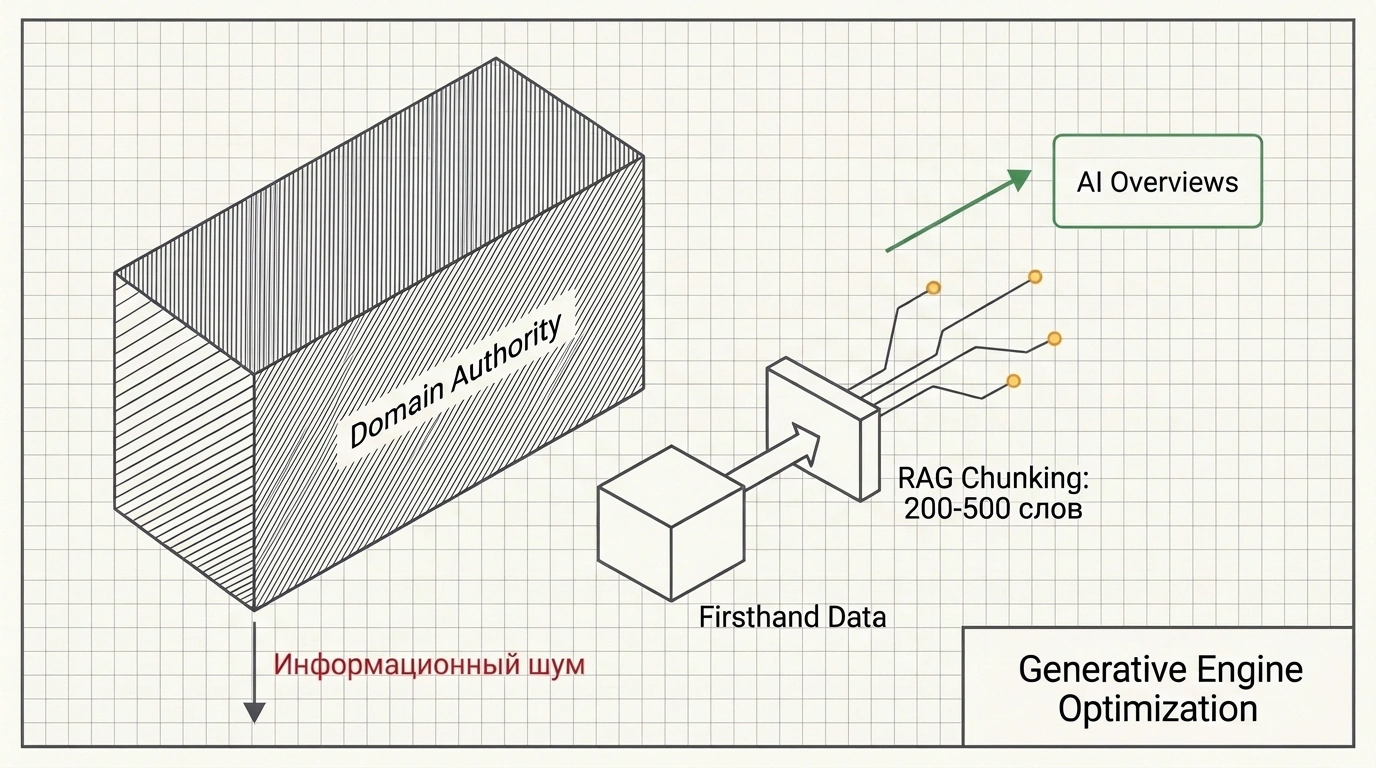

Два десятилетия в сфере поисковой оптимизации царил абсолютный феодализм. Правила игры были просты, циничны и полностью определялись толщиной корпоративного кошелька: если у тебя есть миллионные бюджеты на внешние ссылки, команду из сотни технических специалистов и старый домен с историей, ты гарантированно оккупируешь первую строчку по любому высокочастотному коммерческому запросу. Для небольшого регионального бизнеса, узкопрофильной мастерской или молодого стартапа штурм топа по запросам вроде «доставка цветов» или «юридические услуги» напоминал попытку пробить бетонную стену головой.
Но появление генеративных поисковых систем — Google AI Overviews, ChatGPT Search, Perplexity AI, Gemini и обновленной Алисы — обрушило старую конструкцию ранжирования. В индустрии возник феномен, который эксперты назвали парадоксом авторитета: генеративные языковые модели все чаще цитируют и рекомендуют в первом абзаце ответов не старые неповоротливые порталы, а компактные нишевые ресурсы.
Команда агентства NP Digital во главе с Нилом Пателем провела фундаментальный разбор методологии Generative Engine Optimization (GEO). Оказалось, что для победы в новой выдаче требуются действия, прямо противоположные классическим закупкам ссылок. Давай по слоям разберем, как устроена механика нейропоиска и как небольшому бренду обойти титанов рынка.
1. Парадокс авторитета: почему миллионные ссылочные бюджеты больше не спасают корпорации
В классическом SEO малый бизнес всегда упирался в замкнутый круг «курицы и яйца»: чтобы занять позиции в Google или Яндексе, сайту нужны тысячи естественных ссылок и высокий доменный траст (Domain Authority). Но чтобы эти ссылки появились, сайт уже должен находиться на первых позициях и привлекать миллионы читателей. Вырваться из этой петли без гигантских финансовых вливаний было практически невозможно.
Корпорации десятилетиями эксплуатировали этот механизм. Они покупали биржевые ссылки, запускали сети сайтов-сателлитов (PBN) и штамповали многостраничные лонгриды, раздутые «водянистыми» абзацами ради удержания ключей и объема. Если крупный маркетплейс или федеральный банк публиковал статью из 15 000 знаков, где полезная суть занимала три строчки, а остальное пространство заполняли абстрактные рассуждения о важности выбора надежного партнера, поисковые краулеры все равно ставили ее на первое место за счет колоссального ссылочного веса домена.
В генеративных системах эта логика дает системный сбой. Нейросети не рассчитывают классический граф PageRank в момент генерации ответа. Их задача — синтезировать емкий, фактологически безупречный ответ на сложный, часто разговорный вопрос пользователя. И здесь раздутые корпоративные простыни текста играют против своих создателей: в них слишком низкая концентрация конкретных данных на тысячу знаков. Как отмечалось в аналитике о новых правилах поисковой видимости в эпоху генеративных нейросетей, поисковый робот просто выхватывает лаконичный фрагмент с нишевого сайта, полностью пропуская корпоративного мастодонта.
Когда пользователь спрашивает у Perplexity: «Какой насос выбрать для скважины глубиной 45 метров с высоким содержанием песка?», корпоративный сайт банка или агрегатора выдает длинную вводную статью об истории водоснабжения. А локальный инженерный центр из Воронежа публикует точную таблицу с тремя моделями насосов с плавающими рабочими колесами, замерами реального давления и указанием допустимого диаметра песчинок. Нейросеть мгновенно забирает воронежскую таблицу в свой ответ, а ссылку на сайт инженеров выводит на самый верх.
2. Внутренняя кухня нейропоиска: как RAG-пайплайны и извлечение сущностей меняют правила игры
Чтобы понять, как оказаться в цитатах ИИ, нужно заглянуть под капот современных поисковых агентов. В отличие от традиционных алгоритмов, работающих со списками документов, генеративные поисковики используют архитектуру RAG (Retrieval-Augmented Generation) — генерацию с дополнением извлеченными данными.
Когда человек вводит сложный вопрос, процесс разворачивается в три последовательных этапа:
- Векторный поиск и семантическая нарезка (Chunking): Поисковая система не считывает страницы целиком, как это делает человек. Документ нарезается на семантические смысловые блоки размером от 200 до 500 слов. Каждый фрагмент переводится в векторный эмбеддинг — математическую точку в многомерном пространстве смыслов. Поисковик ищет фрагменты, которые находятся ближе всего к вектору пользовательского запроса по косинусному расстоянию.
- Оценка фактологической плотности и перекрестный консенсус: Извлеченные фрагменты отправляются на стадию скоринга. Модель сопоставляет факты, извлеченные из разных источников. Если несколько независимых ресурсов называют одинаковые технические характеристики, формулы и диапазоны цен, алгоритм считает эти данные верифицированными. Если же на сайте приведена абстрактная словесная шелуха, фрагмент отсеивается как информационный шум.
- Финальный синтез с расстановкой сносок: Языковая модель формирует итоговый текст, расставляя ссылки и сноски на те первоисточники, чьи формулировки, термины и расчеты легли в основу конкретных тезисов ответа.
Фундаментальное исследование ученых Принстонского университета, протестировавших девять различных методов оптимизации под GEO на тысячах поисковых сценариев, подтвердило: включение в контент проверенной статистики, точных цитат профильных специалистов и проверяемых числовых фактов повышает вероятность попадания ресурса в финальный ответ генеративной системы на 30–40%. Алгоритмам нужны строительные блоки для мысли, а не пространные философские рассуждения.
3. Оружие небольших команд: производство данных первого порядка (Firsthand Data)
Главное преимущество небольшого локального бизнеса перед безликой корпорацией — прямой контакт с живой реальностью. У корпораций за плечами громоздкие согласования, комплаенс и юридические фильтры, из-за которых их публикации выхолощены до состояния пресной политкорректности. Они не могут написать, что конкретная популярная модель оборудования ломается в 30% случаев из-за бракованного пластикового клапана, потому что производитель этого оборудования является их ключевым рекламодателем.
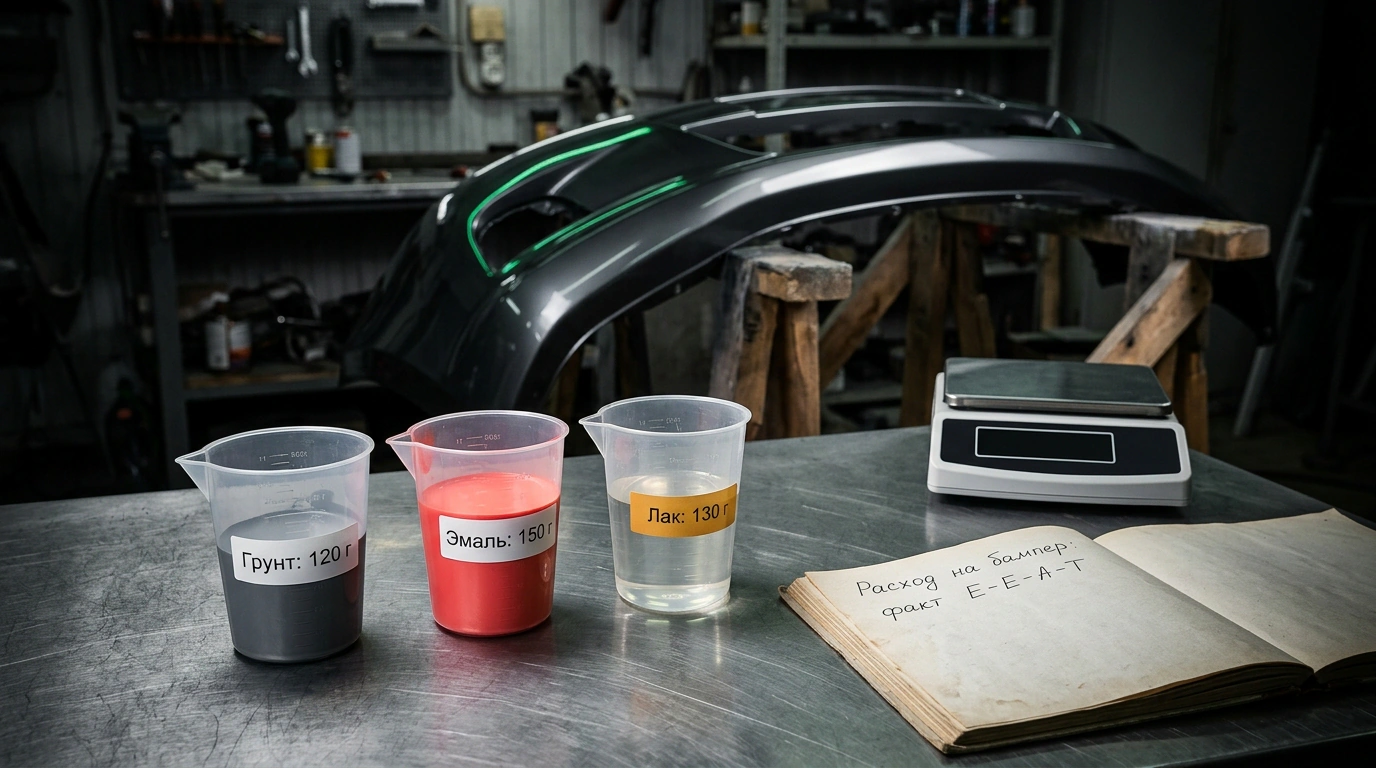
У тебя в руках находятся уникальные данные первого порядка (Firsthand Data), которых нет ни у одной языковой модели в мире:
- Реальные цифры расходов и себестоимости в твоем регионе.
- Живая статистика поломок и отказов оборудования конкретных брендов на основе сервисных журналов.
- Точные хронометражи выполнения услуг и неочевидные подводные камни монтажа.
- Сводки типичных клиентских ошибок, с которыми ежедневно сталкивается твой отдел продаж.
Давай рассмотрим конкретный сценарий. Локальная станция кузовного ремонта решает написать материал о покраске автомобильных бамперов. Корпоративный портал публикует стандартную статью: «Покраска бампера — ответственный процесс, требующий профессионального оборудования». Локальный автосервис делает иначе: мастер фотографирует этапы нанесения грунта по пластику, публикует точный расклад по затратам материалов на один элемент (120 граммов грунта, 150 граммов базовой эмали, 130 граммов лака) и показывает, что происходит с деталью через год, если сэкономить на адгезионном праймере.
Когда пользователь спрашивает у поискового ИИ: «Почему облезает краска с пластикового бампера после зимы?», модель не найдет ответа у корпораций. Она возьмет конкретный фрагмент статьи автосервиса, процитирует температурные режимы сушки и поставит ссылку на публикацию мастеров. Это именно то, что заложено в стандарты поисковой оценки E-E-A-T: демонстрация реального практического опыта (Experience).
4. Цифровой след вне собственного сайта: почему Reddit и отраслевые базы важнее PageRank
Старая парадигма учила нас: загоняй весь трафик исключительно на свой домен и держи глухую оборону. В мире GEO эта стратегия ведет к изоляции. Поисковые нейросети обучаются на всей палитре публичного интернета, формируя сущностный граф (Entity Graph) твоего бренда на основе внешних упоминаний.
Исследования цитируемости показывают, что в блоках Google AI Overviews форум Reddit занимает второе место по частоте источников, уступая только YouTube. Чат-боты ChatGPT и Perplexity активно сканируют открытые дискуссионные площадки, отраслевые каталоги, каналы экспертов и базы отзывов.
Если алгоритм видит, что название твоей компании регулярно упоминается реальными людьми в профильных сообществах, на форумах и в профессиональных чатах в контексте решения конкретной инженерной или маркетинговой задачи, модель связывает твой бренд с этой сущностью. Создается эффект перекрестного подтверждения: поисковик доверяет твоему сайту не потому, что ты сам написал о своей исключительности, а потому, что независимый внешний консенсус подтверждает твою компетентность.
О том, как выстраивать репутационный каркас в базах знаний и проводить аудит присутствия бренда в нейросетях, мы детально рассказывали в исследовании аудита бренда в ответах нейросетей и поиска ChatGPT. Чтобы запустить этот процесс, не нужно спамить ссылками: достаточно отвечать на реальные вопросы пользователей в профильных ветках, делиться расчетами и публиковать выжимки практических тестов на открытых площадках.
5. Технический каркас для ИИ-краулеров: перевернутая пирамида и микроразметка
Даже самый ценный фактологический материал останется незамеченным, если поисковый робот запутается в сложной верстке или не сможет быстро вычленить суть. Для общения с генеративными движками текст должен быть организован по принципу перевернутой пирамиды (Inverted Pyramid).
Суть принципа предельно утилитарна:
- Прямой ответ в первом предложении. Первые 40–50 слов под заголовком или подзаголовком обязаны давать четкий, законченный ответ на поставленный вопрос. Никаких лирических вступлений и дежурных фраз про «в современном мире динамично развивающихся технологий». Робот должен мгновенно забрать готовую формулировку для своего генеративного сниппета.
- Аргументация и доказательства. Следом идут конкретные расчеты, ссылки на методику, сравнения альтернатив и табличные данные.
- Нюансы и ограничения. В конце раздела раскрываются частные случаи, исключения из правил и практические советы по внедрению.
Обязательным техническим фундаментом служит микроразметка Schema.org. Внедрение структурированных блоков FAQPage, HowTo, Product и TechArticle в формате JSON-LD позволяет краулерам считывать сущности без необходимости интерпретировать окружающий HTML-код. Это снимает любые сомнения поисковика в том, какая именно цифра обозначает цену, а какая — гарантийный срок.
Кроме того, генеративные поисковые роботы крайне чувствительны к чистоте семантической разметки. Использование тегов списков, маркированных перечислений и коротких предложений повышает вероятность безошибочного парсинга текста алгоритмическими парсерами в разы по сравнению со сплошными абзацами. Если в материале приводится пошаговый алгоритм, каждый пункт должен быть четко пронумерован и снабжен лаконичным подзаголовком. То же самое касается таблиц: публикуй сравнительные данные в виде чистого текста или HTML-таблиц, а не скриншотов. Нейросеть считывает ячейки таблицы как готовые связки «свойство — значение» и с максимальной точностью переносит их в генеративный ответ.
6. Экономика эпохи Zero-Click: как выжимать клиентов из темного трафика без прямых переходов
Главный страх предпринимателей перед GEO звучит так: «Если пользователь прочитает ответ нейросети прямо в поиске, он не перейдет на мой сайт. Зачем мне тратить ресурсы на контент, если кликов становится меньше?».
Это явление получило название Zero-Click Search (поиск без кликов). Действительно, эпоха легких дешевых переходов по общим информационным запросам безвозвратно уходит. По данным отраслевых мониторингов, до 60–70% информационных поисковых сессий сегодня завершаются на первой странице без единого перехода по внешним ссылкам.
Однако на смену кликам приходит конверсия нового типа — формирование брендового спроса и монетизация темного трафика:
- Эффект экспертного якоря: Когда потенциальный клиент раз за разом видит, что умный поисковый ассистент ссылается на твою компанию как на главный источник проверенных цифр, у него формируется стойкое ощущение экспертного лидерства. Следующим шагом пользователя будет не абстрактный поиск, а прямой ввод названия твоего бренда в поисковую строку.
- Патентование авторских терминов: Если ты называешь свой метод не просто «настройкой рекламы», а упаковываешь его в запоминающееся имя (например, «Матрица сквозной фильтрации спроса»), нейросеть при цитировании назовет именно этот термин. Заинтересованный читатель пойдет искать первоисточник авторской методики.
- Отслеживание брендового эха в сквозной аналитике: Традиционная веб-аналитика теряет след пользователей, пришедших после взаимодействия с AI Overviews. Чтобы оцифровать этот эффект, отслеживай динамику брендовых поисковых запросов в Яндекс Вордстат и Google Trends, а также добавляй обязательный вопрос в форму заявки: «Откуда вы впервые узнали о нашей компании?».
Пошаговый роадмап для малого бизнеса по выходу в топ генеративной выдачи сводится к четырем понятным шагам:
- Аудит реальных вопросов клиентов: собери 50 самых частых технических сомнений, которые задают менеджеры или мастера на линии.
- Публикация первичных протоколов: выложи по каждому вопросу лаконичную фактологическую карточку с цифрами, замерами и расчетами вместо общих рассуждений.
- Внедрение микроразметки FAQPage и Product: настрой автоматическую генерацию JSON-LD блоков, чтобы поисковые краулеры мгновенно считывали сущности.
- Дистрибуция тезисов в профильных сообществах: делись выжимками тестов на внешних независимых площадках, формируя внешний консенсус вокруг бренда.
Победа над гигантами в эру генеративного поиска — это не вопрос бюджета. Это вопрос смелости делиться реальными цифрами, говорить с аудиторией человеческим языком и упаковывать свой практический опыт так, чтобы ни одна нейросеть не смогла пройти мимо.