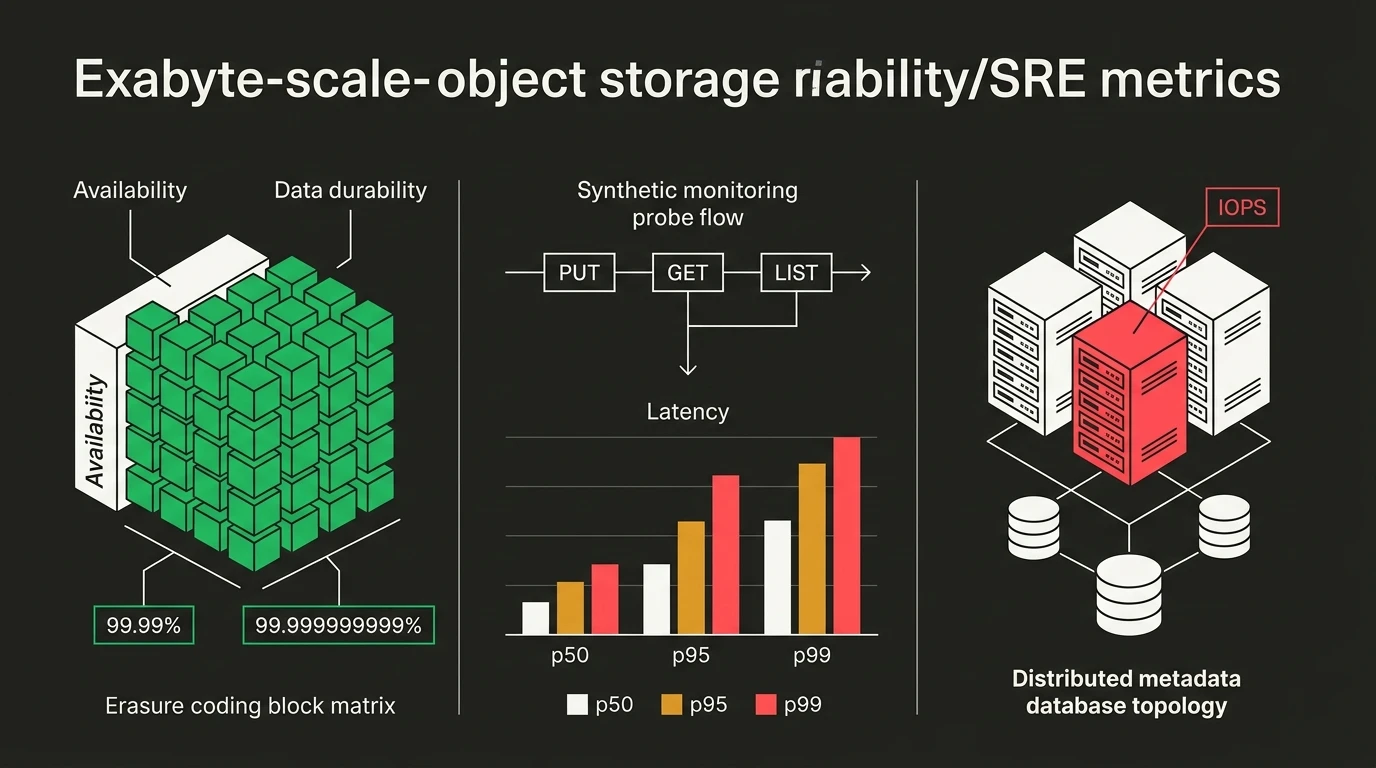

Когда инфраструктура хранения разрастается до масштаба сотен петабайт или эксабайт, привычные инженерные интуиции перестают работать. На таком объеме стандартные дашборды с агрегированным аптаймом создают опасную иллюзию благополучия: общий показатель может уверенно держаться на уровне 99,99%, пока система незаметно теряет блоки данных, отдельные диски захлебываются от перекоса нагрузки, а клиенты страдают от секундных задержек. Инженер Шридхар Раджарао (Sridhar Rajarao), руководивший SRE-командой крупного объектного хранилища на протяжении восьми лет, обобщил этот опыт в набор из семи практических сигналов, которые действительно отражают реальное состояние системы.
Доступность против сохранности: почему аптайм обманчив
Первое фундаментальное разделение, необходимое при эксплуатации распределенного хранилища, — это разграничение доступности (Availability) и долговечности или сохранности данных (Durability). Доступность измеряет долю успешных HTTP-запросов к API сервиса. Раджарао ориентировался на целевой показатель 99,99%, рассчитываемый раздельно для каждого региона и каждого внутреннего сервиса.
Однако высокий аптайм ничего не говорит о физической сохранности байтов на дисках. Долговечность отвечает на вопрос: какова вероятность того, что однажды записанный объект не будет безвозвратно утрачен в течение года? В промышленных системах стандартом является уровень «одиннадцати девяток» (годовая вероятность потери блока не превышает 10⁻¹¹). Такая надежность достигается не простым дублированием, а избыточным кодированием (erasure coding), при котором объект разделяется на фрагменты данных и контрольные блоки, распределенные по независимым доменам отказа (availability domains).
Сервис может быть временно недоступен из-за сетевого сбоя, но данные при этом остаются в полной безопасности. И наоборот: API может успешно возвращать статус 200 OK, но если фоновый процесс восстановления блоков (rebuild) отстает от темпа деградации физических носителей, система находится в шаге от тихой потери информации. Подтвердить реальную долговечность невозможно пассивным наблюдением — для этого необходимы регулярные ежемесячные учения по аварийному восстановлению (recovery drills) с контролируемым отключением оборудования.
Задержка первого байта и непрерывные канарейки
Второй пласт метрик связан с восприятием сервиса пользователями. Измерение средней задержки скрывает реальные проблемы, поэтому отслеживать необходимо перцентили p50, p95 и p99. При этом ключевым показателем является TTFB (Time to First Byte) — время от отправки запроса клиентом до получения первого байта ответа.
Главное эксплуатационное правило состоит в том, что задержку TTFB нельзя усреднять по всему хранилищу. Ее необходимо сегментировать по размерным корзинам объектов. Чтение файла объемом 10 МБ и легкий проверочный запрос заголовков (HEAD) на 100 байт не могут делить единый целевой показатель задержки: то, что является отличным временем отклика для многомегабайтного архива, сигнализирует о тяжелой деградации при чтении микрометаданных.
Для проактивного контроля привлекаются синтетические канарейки (synthetic canaries). Это изолированные фоновые процессы, которые непрерывно и с высокой частотой выполняют сквозные циклы записи, чтения и листинга (PUT, GET, LIST) во всех обслуживаемых регионах. Главная задача канареек — обнаружить локальную деградацию сети или подсистемы ввода-вывода в течение 30 секунд. Если алерт срабатывает только после того, как в поддержку обратились пользователи, мониторинг считается не справившимся со своей задачей.
Локальные перекосы и уязвимость базы метаданных
На огромном масштабе средние значения ввода-вывода (IOPS) скрывают критические перекосы. Метрика Hotspots сопоставляет показатели самых нагруженных узлов (top-N) с медианой всего кластера по операциям ввода-вывода и объему отданных байтов. Если один узел или группа дисков берет на себя непропорциональную нагрузку, деградация начнется задолго до исчерпания емкости всей системы. Поэтому контроль IOPS ведется не на уровне серверов, а в разрезе отдельных физических дисков и шардов.
Финальная и самая уязвимая точка объектного хранилища — база данных метаданных (Metadata DB). Пользователям кажется, что объектное хранилище представляет собой простую бессерверную структуру, однако операции поиска объектов, авторизация, сборка списков и проверка прав жестко опираются на шардированную СУБД каталога.
В слое метаданных ключевыми сигналами служат нагрузка на процессор каждого шарда, отставание репликации (replication lag) и перекос по горячим ключам (hot-key skew). Если из-за неудачного хеширования или ошибки ребалансировки один шард базы метаданных окажется перегружен, плоскость управления (control plane) откажет полностью. В результате все хранилище перестанет отвечать на запросы, даже если физические диски с данными работают безупречно.