

В разработке систем на базе искусственного интеллекта наметился важный сдвиг. Долгое время для задач классификации, скоринга и маршрутизации запросов применялись стандартные генеративные языковые модели (LLM). Однако авторегрессионный механизм генерации токенов порождает заметные накладные расходы: задержки в сотни миллисекунд, высокий расход памяти и риск галлюцинаций в структурированном выводе.
В качестве альтернативы формируется класс компактных моделей решений (Decision Models, концепция System 1). Заметным представителем этого подхода стал открытый проект Laya (лицензия Apache-2.0), сопоставляемый с облачным сервисом Jev.
Архитектура прямого прохода и обучение RLCD
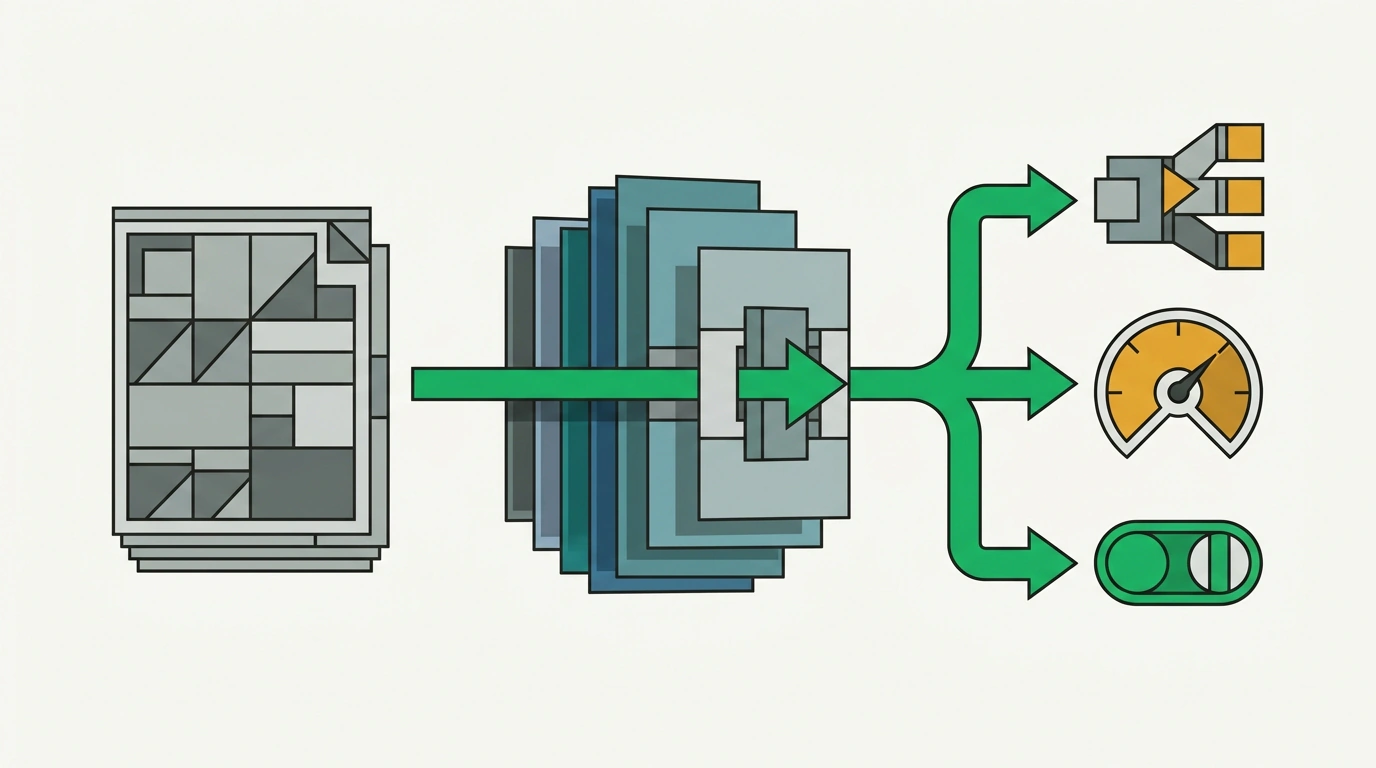
Ключевое отличие Laya — отказ от генерации свободного текста. Модель не строит цепочки рассуждений, а принимает типизированное состояние (текст или JSON-документ) и за один прямой проход (single forward pass) возвращает строгие скалярные оценки: выбор из списка, числовой балл или булев флаг.
Модель обучается методом RLCD (Reinforcement Learning with Strictly Proper Scoring Rules) — обучением с подкреплением на основе правил скоринга, штрафующих за неуверенность. В линейку входят чекпоинты на базе энкодеров ModernBERT-large (421M параметров) и mmBERT-base (322M параметров):
import laya
from laya import Router

router = Router(preload=True)

# 1. Входное состояние (тикет техподдержки)
state = {
    "from": "client@enterprise.com",
    "subject": "Срочный возврат платежа #9921",
    "body": "Списана двойная сумма за подписку. Прошу вернуть дубль сегодня."
}

# 2. Декларативное описание типизированных вопросов
questions = {
    "department": {
        "type": "choice",
        "instructions": "В какой отдел направить обращение?",
        "criteria": {
            "billing": "счета, платежи, возвраты средств",
            "technical": "сбои сервиса, ошибки в коде",
            "sales": "новые договоры, тарифы"
        }
    },
    "urgency": {
        "type": "score",
        "instructions": "Оцените критичность инцидента",
        "criteria": ["низкая", "умеренная", "критическая"]
    },
    "refund_requested": {
        "type": "noul",
        "instructions": "Требует ли клиент прямой возврат средств?"
    }
}
Роутер определяет язык и направляет запрос в нужный чекпоинт:
# 3. Вычисление решения за один прямой проход без генерации токенов
result = router.predict(state, questions)

department = result["answers"]["department"]["choice"]     # "billing"
confidence = result["answers"]["department"]["confidence"] # 0.94
is_refund  = result["answers"]["refund_requested"]["value"] # True

print(f"Отдел: {department} ({confidence}), Возврат: {is_refund}")
Статус сравнительных замеров и оговорки о бенчмарках
В сообществе разработчиков интерес вызвали замеры Laya в сравнении с облачным сервисом Jev на примере игровой задачи («Змейка»). В демонстрационном тесте локальная Laya на чипе M5 Pro показала медианную задержку около 15 мс (до 86 решений/сек) против 298–317 мс у облачного Jev, главным образом из-за сетевого раундтрипа.
Редакция подчеркивает: эти цифры получены в рамках демонстрационного теста авторов проекта. В доступных источниках отсутствуют независимые первичные подтверждения и общепринятые отраслевые бенчмарки, сопоставляющие качество решений Laya и Jev на широком спектре задач. Поэтому приводимые показатели нельзя рассматривать как доказанный универсальный ориентир.
Ограничения контекста и практические сценарии
Разработчики открыто фиксируют технические ограничения архитектуры:
- Узкое контекстное окно: Вход ограничен 512–1024 токенами, что исключает анализ объемных кодовых баз без предварительной нарезки.
- Ограниченное обобщение: Без донастройки (fine-tuning) модель уступает крупным LLM в решении нестандартных творческих задач.
Тем не менее для бэкенд-конвейеров, где требуется миллисекундная фильтрация спама, приоритизация очередей или валидация JSON-структур прямо на локальных серверах, компактные модели прямого прохода становятся эффективным инструментом снижения задержек и инфраструктурных затрат.