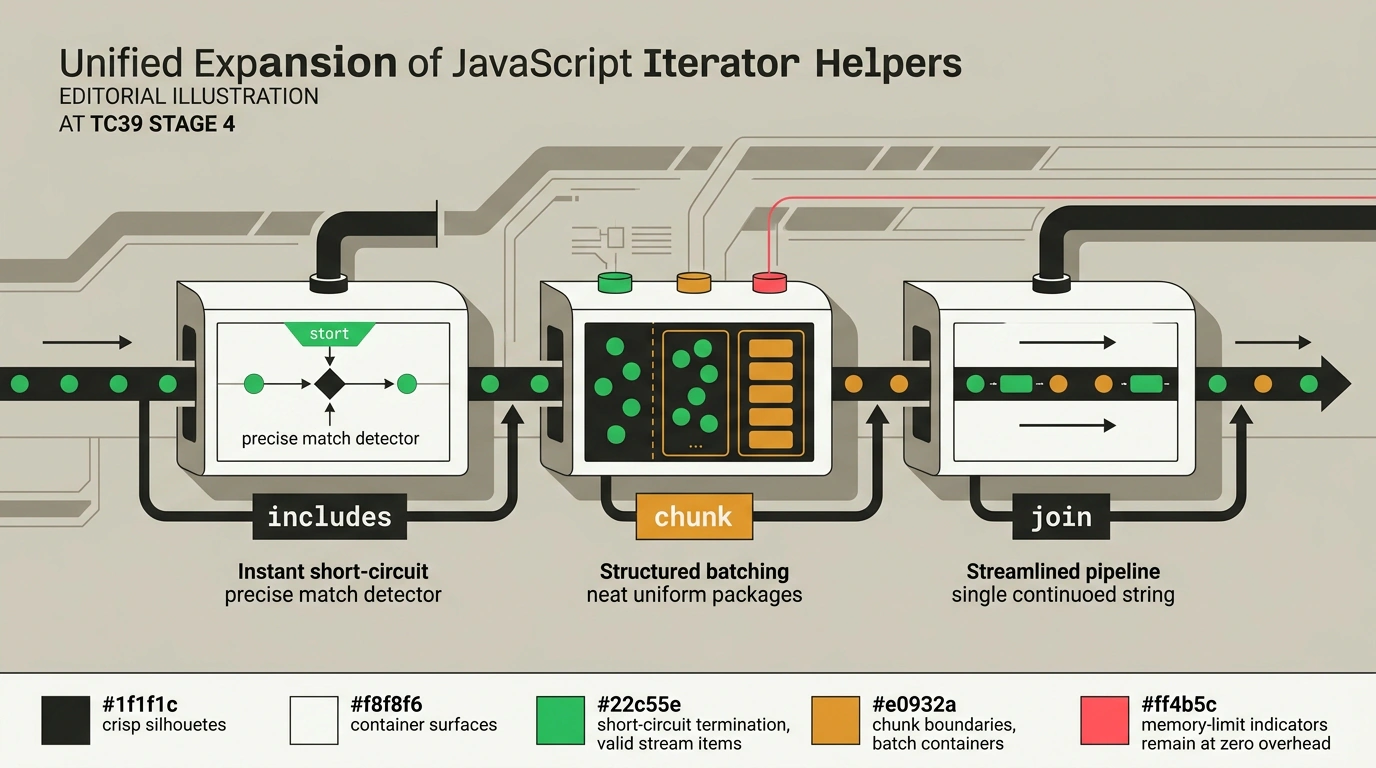
Работа с большими коллекциями данных в JavaScript долгое время сопровождалась неприятным компромиссом между элегантностью кода и расходом оперативной памяти. Разработчики привыкли использовать удобные цепочки методов массивов (map, filter, includes), однако для ленивых генераторов или внешних потоков данных эти операции требовали предварительной выгрузки всей последовательности в массив через Array.from(). На заседании комитета TC39 от 29 сентября 2026 года сразу три долгожданных расширения интерфейса Iterator.prototype были единогласно переведены на финальную стадию Stage 4, официально пополнив стандарт ECMAScript.
Проверка наличия элементов через Iterator.prototype.includes
Первое предложение стандартизирует поточный поиск элемента Iterator.prototype.includes(value). В отличие от массивов, где длина известна заранее, на итераторе метод выполняет ленивое сканирование последовательности с использованием точного алгоритма сравнения SameValueZero (который, в отличие от строгого равенства ===, корректно определяет NaN === NaN).
Критическое преимущество метода — немедленный ранний выход (short-circuiting). Как только совпадение найдено, итератор прекращает потреблять ресурсы, вызывает метод закрытия iterator.return() и возвращает true. Это позволяет безопасно проверять даже потенциально бесконечные генераторы, если искомый элемент гарантированно встретится в потоке:
function* idGenerator() {
  let id = 1;
  while (true) yield id++;
}

// Ленивый поиск: генератор остановится на числе 42 и освободит ресурсы
const hasTargetId = idGenerator().includes(42);
console.log(hasTargetId); // true
Поточное объединение строк с помощью Iterator.prototype.join
Метод Iterator.prototype.join(separator) решает давнюю проблему склеивания строковых потоков без промежуточной аллокации памяти. Раньше при формировании CSV-отчетов или экспорте текстовых логов из базы данных инженеры преобразовывали итератор строк в гигантский массив в куче V8, рискуя вызвать аварийное завершение процесса по Out of Memory.
Нативная реализация join последовательно считывает элементы итератора, приводит их к строковому типу и конкатенирует с заданным разделителем (по умолчанию запятая ,). Вычисления происходят на уровне оптимизированного C++ кода браузерных движков, снижая накладные расходы сборщика мусора практически до нуля.
Пакетное разбиение последовательностей в Iterator.prototype.chunk
Третье расширение — Iterator.prototype.chunk(size) — переносит популярный паттерн батчинга из библиотеки Lodash прямо в стандартный прототип итератора. Метод группирует элементы потока в компактные массивы указанного размера, возвращая новый итератор порций.
Связка chunk и join позволяет построить чистый поточный конвейер выгрузки и пакетной отправки данных во внешний API:
function* logStream() {
  yield '2026-09-30 INFO service started';
  yield '2026-09-30 WARN high disk latency';
  yield '2026-09-30 ERROR connection reset';
  yield '2026-09-30 INFO retry successful';
}

// Разбиваем поток на пачки по 2 записи и склеиваем в мини-пакеты
const batches = logStream()
  .chunk(2)
  .map(batch => batch.join(' \n '));

for (const payload of batches) {
  console.log('Отправка батча в систему аналитики:\n' + payload);
}
Финальное утверждение спецификаций на Stage 4 знаменует зрелость функциональной обработки данных в JavaScript: потоки и генераторы получили первоклассные нативные инструменты, избавляющие продакшен от лишних сторонних зависимостей.