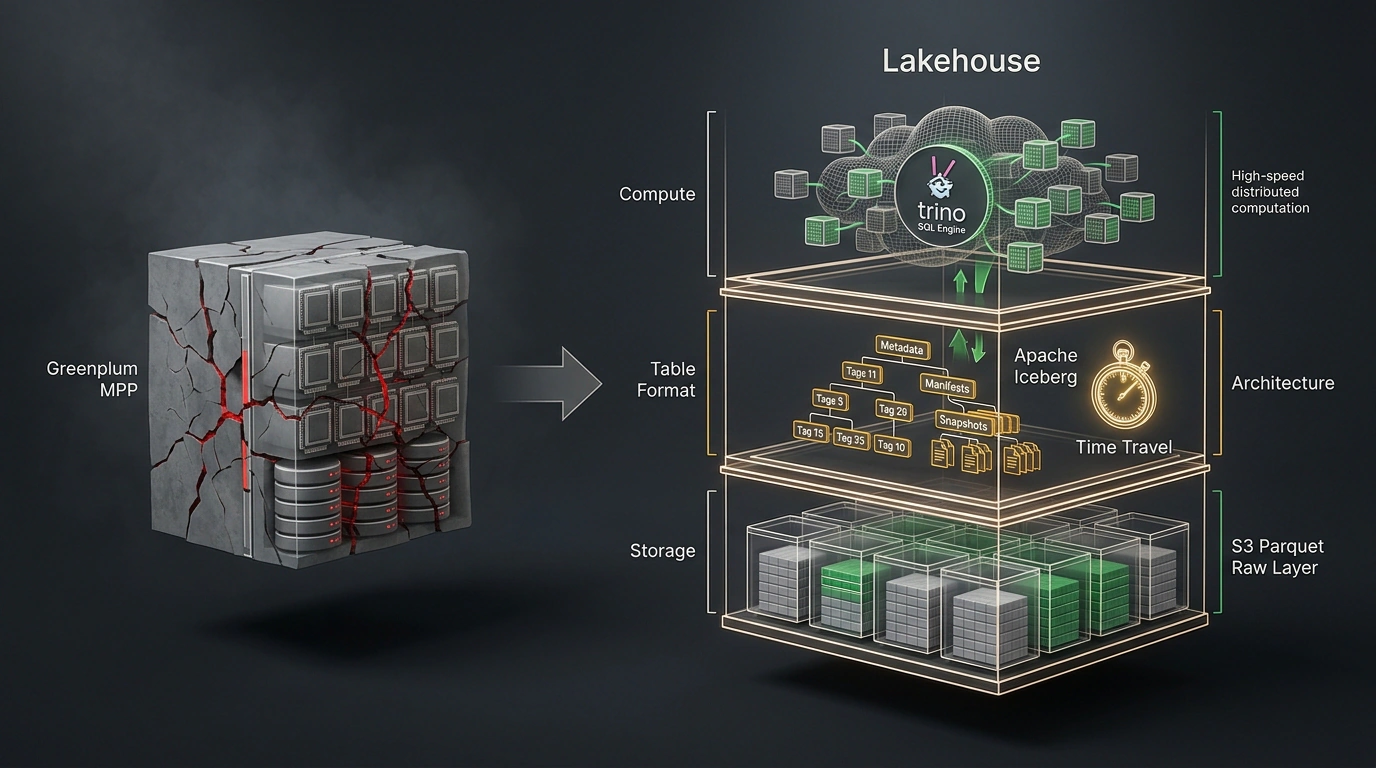

Масштабирование корпоративного аналитического хранилища данных (КХД) неизбежно подводит инженерную команду к развилке. Долгие годы де-факто стандартом для сложных аналитических нагрузок оставалась СУБД Greenplum — мощное решение с массово-параллельной архитектурой (MPP). Однако взрывной рост объемов информации в крупных цифровых сервисах обнажает фундаментальные ограничения классических распределенных баз данных: монолитную связку вычислений и дискового пространства, дороговизну сопровождения и хрупкость кластера при сбоях.
Практический кейс образовательного холдинга Skillbox, представленный экспертами Алексеем Рыбаком и Алексеем Белозерским на инженерном стриме Devhands, демонстрирует один из самых зрелых в российской практике примеров переезда на открытую архитектуру Data Lakehouse. Отказ от монолитного Greenplum в пользу триады из распределенного SQL-движка Trino, открытого табличного формата Apache Iceberg и объектного хранилища S3 позволил радикально сократить совокупную стоимость владения (TCO) и устранить технологические тупики масштабирования.
Пределы классических MPP: почему Greenplum исчерпал себя
Архитектура Greenplum проектировалась под аппаратные серверы с локальными дисками. Каждый сегмент кластера одновременно выполняет вычисления и хранит фиксированную часть данных. На объемах в десятки терабайтов эта связка оборачивается тремя системными барьерами:
- Связанность ресурсов (Coupled Compute & Storage): если аналитикам требуется сохранить дополнительные сотни гигабайт истории, бизнесу приходится докупать тяжелые серверы с дорогими многоядерными CPU и терабайтами оперативной памяти. В результате вычислительные мощности простаивают большую часть суток, но расходы на инфраструктуру растут.
- Проблема неравномерного распределения (Data Skew): выбор ключа распределения (
DISTRIBUTED BY) требует ювелирной точности. Стоит характеру данных сместиться, как один сегмент кластера получает в разы больше строк, чем остальные. Поскольку скорость выполнения распределенного SQL-запроса в MPP лимитируется самым медленным узлом, весь кластер начинает тормозить. - Хрупкость ребалансировки (gpexpand): выход из строя одной ноды или плановое расширение кластера запускает долгую утилиту перераспределения данных
gpexpand. На больших базах этот процесс растягивается на сутки, катастрофически снижая пропускную способность КХД для бизнес-пользователей.
Архитектурная триада Lakehouse: Trino, Iceberg и объектное хранилище
Концепция Data Lakehouse объединяет дешевизну и масштабируемость «озера данных» (Data Lake) со строгой структурой и ACID-транзакционностью классических реляционных баз. В Skillbox архитектура разделилась на три независимых уровня:
- Слой хранения (Storage): распределенное S3-совместимое объектное хранилище на базе Ceph и облачных сервисов. Стоимость хранения терабайта в S3 на порядок ниже содержания корпоративных NVMe-массивов в серверах Greenplum.
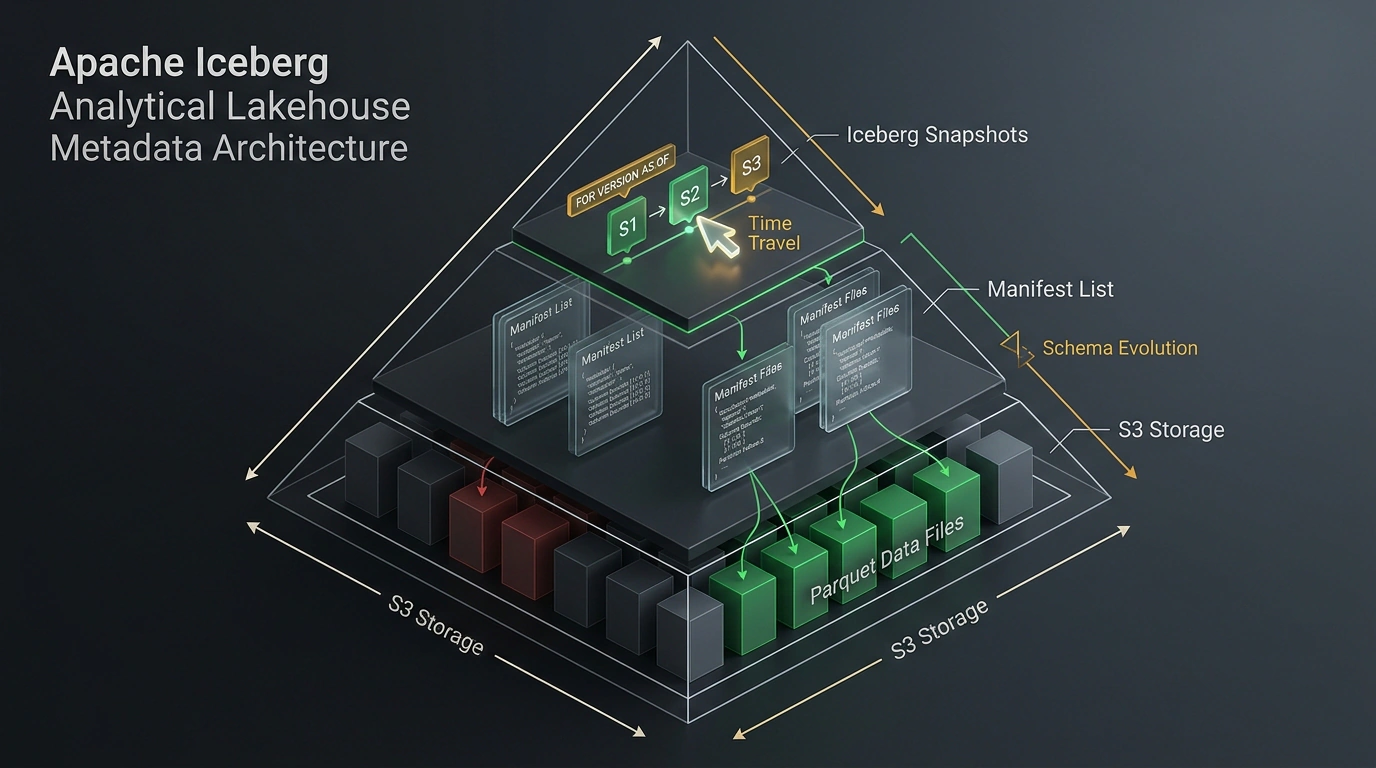
- Табличный мета-слой (Table Format): Apache Iceberg превращает набор статических файлов в S3 в полноценную реляционную таблицу со снимками состояния (snapshots), скрытым партиционированием и эволюцией схем без перезаписи файлов данных.
- Вычислительный слой (Compute): бессерверный распределенный SQL-движок Trino. Координатор Trino компилирует SQL-запросы, обращается к метаданным Iceberg и распараллеливает чтение Parquet-файлов между пулом воркеров.
Сырой слой Parquet: главная страховка от человеческих ошибок
Фундаментальным инженерным решением команды Skillbox стало формирование неизменяемого (immutable) сырого слоя (Raw Layer) прямо в S3. Данные из операционных баз (PostgreSQL, MySQL) и потоки событий сбрасываются в бакеты в виде колоночных файлов Apache Parquet.
Это решение устранило экзистенциальный страх любого инженера данных: риск необратимого повреждения витрин при сбое сложного ETL-пайплайна. Если в трансформациях аналитического слоя обнаруживается ошибка трехмесячной давности, витрину больше не нужно восстанавливать из медленных бэкапов. Достаточно запустить Airflow DAG, который за несколько часов пересчитает витрину заново из неизменяемого сырого слоя S3.
Магия метаданных Iceberg: Time Travel и эволюция схем
В традиционных озерах данных на Hive любая модификация таблицы (UPDATE, DELETE или добавление столбца) превращалась в мучительную перезапись терабайтов файлов на диске. Apache Iceberg решает эту проблему за счет трехуровневого дерева метаданных:
- Снимки состояния (Snapshots): каждая транзакция создает новый манифест-файл, фиксирующий точный список активных файлов данных. Это обеспечивает моментальные консистентные снимки без блокировок читателей.
- Путешествие во времени (Time Travel): аналитики могут в любой момент воспроизвести состояние витрины на конкретную секунду в прошлом (например,
FOR VERSION AS OF...), что критически важно для финансового аудита и сверки отчетности. - Эволюция партиционирования: при изменении шага партиций (например, переход от дневных папок к месячным) старые данные остаются на месте, а новые пишутся по новому правилу. Пользователю не нужно знать внутреннюю структуру папок — Iceberg применяет оптимизацию фильтрации автоматически.
Бесшовная замена витрин: кастомный оператор Airflow
В классическом Greenplum обновление витрин часто сопровождалось короткими даунтаймами или рисками отдачи полупустых данных, пока выполнялся TRUNCATE и повторный INSERT. В Lakehouse переключение витрин происходит атомарно на уровне указателей метаданных.
Команда Skillbox разработала специализированный оператор Airflow TrinoIcebergAtomicSwapOperator. Пайплайн строит новые данные в изолированной промежуточной таблице (staging), проводит автоматическую валидацию контрольных сумм и затем одной SQL-командой ALTER TABLE ... SWAP WITH ... меняет местами метаданные продуктовой и тестовой таблицы. Для конечных аналитиков и дашбордов BI переход занимает миллисекунды и протекает совершенно незаметно.
Сквозной сценарий: проектирование аналитической таблицы и переключение
Создание витрины активности студентов в Trino с партиционированием по месяцам и форматом Parquet:
-- Определение аналитической таблицы Apache Iceberg в Trino
CREATE TABLE iceberg.analytics.student_activity_mart (
    student_id BIGINT,
    course_id VARCHAR(64),
    module_id VARCHAR(64),
    action_type VARCHAR(32),
    spent_seconds INTEGER,
    event_timestamp TIMESTAMP(6) WITH TIME ZONE
)
WITH (
    format = 'PARQUET',
    partitioning = ARRAY['month(event_timestamp)', 'action_type'],
    location = 's3a://lakehouse-warehouse/analytics/student_activity/'
);

-- Аналитический запрос с механизмом Time Travel для сверки исторического отчета
SELECT
    course_id,
    count(DISTINCT student_id) AS active_students,
    sum(spent_seconds) / 3600 AS total_hours_spent
FROM iceberg.analytics.student_activity_mart FOR VERSION AS OF 29841029481923
WHERE event_timestamp >= CURRENT_DATE - INTERVAL '30' DAY
GROUP BY course_id;
Реализация кастомного оператора Airflow для атомарного переключения витрины:
# plugins/lakehouse_operators.py - оператор атомарного переключения метаданных витрины
from airflow.models import BaseOperator
from trino.dbapi import connect

class TrinoIcebergAtomicSwapOperator(BaseOperator):
    """Атомарная подмена рабочей витрины через замену указателей в каталоге Iceberg."""
    def __init__(self, target_table: str, staging_table: str, **kwargs):
        super().__init__(**kwargs)
        self.target_table = target_table
        self.staging_table = staging_table

    def execute(self, context):
        conn = connect(
            host="trino-coordinator.internal",
            port=8080,
            user="airflow_lakehouse_runner",
            catalog="iceberg",
            schema="analytics"
        )
        cursor = conn.cursor()
        self.log.info(f"Начало атомарной подмены: {self.staging_table} -> {self.target_table}")

        # Выполнение команды атомарного обмена указателями в Trino
        swap_query = f"ALTER TABLE {self.target_table} SWAP WITH {self.staging_table}"
        cursor.execute(swap_query)
        cursor.fetchall()
        self.log.info("Подмена успешно завершена без простоя бизнес-запросов.")
Подводные камни: проблема мелких файлов и сетевые задержки
Переход на Lakehouse не является серебряной пулей и требует строгой инженерной гигиены:
- Проблема мелких файлов (Small Files Problem): если потоковые данные пишутся в S3 малыми порциями, образуются миллионы микрофайлов Parquet. Чтение метаданных начинает занимать больше времени, чем сканирование самих данных. Решение — регулярный запуск регламентных задач компактизации (
OPTIMIZE / rewrite_data_files). - Сетевые задержки S3: время отклика объектного хранилища выше задержек прямого чтения с NVMe-накопителей. Для компенсации воркеры Trino агрессивно кэшируют колоночные индексы и метаданные в оперативной памяти и на локальных SSD.
Итоговая экономика и вердикт для архитекторов данных
Опыт Skillbox доказывает состоятельность концепции Lakehouse для масштабных цифровых платформ:
- Эластичность затрат: в моменты пиковых нагрузок (закрытие квартала, генерация дипломов) вычислительный пул Trino в кластере Kubernetes динамически масштабируется до сотен воркеров, а ночью сворачивается до базового минимума.
- Отказоустойчивость: авария любого воркера Trino больше не приводит к панике кластера — запрос просто автоматически перенаправляется на исправный узел.
- Разделение задач: для быстрых онлайн-дашбордов с миллисекундным откликом витрины выгружаются в ClickHouse, тогда как тяжелая историческая аналитика полностью перешла в Trino и Iceberg.
Data Lakehouse на стеке Trino, Apache Iceberg и S3 перестал быть уделом технологических гигантов уровня Netflix и Apple, превратившись в доступный, воспроизводимый и экономически оправданный стандарт современной индустрии данных.