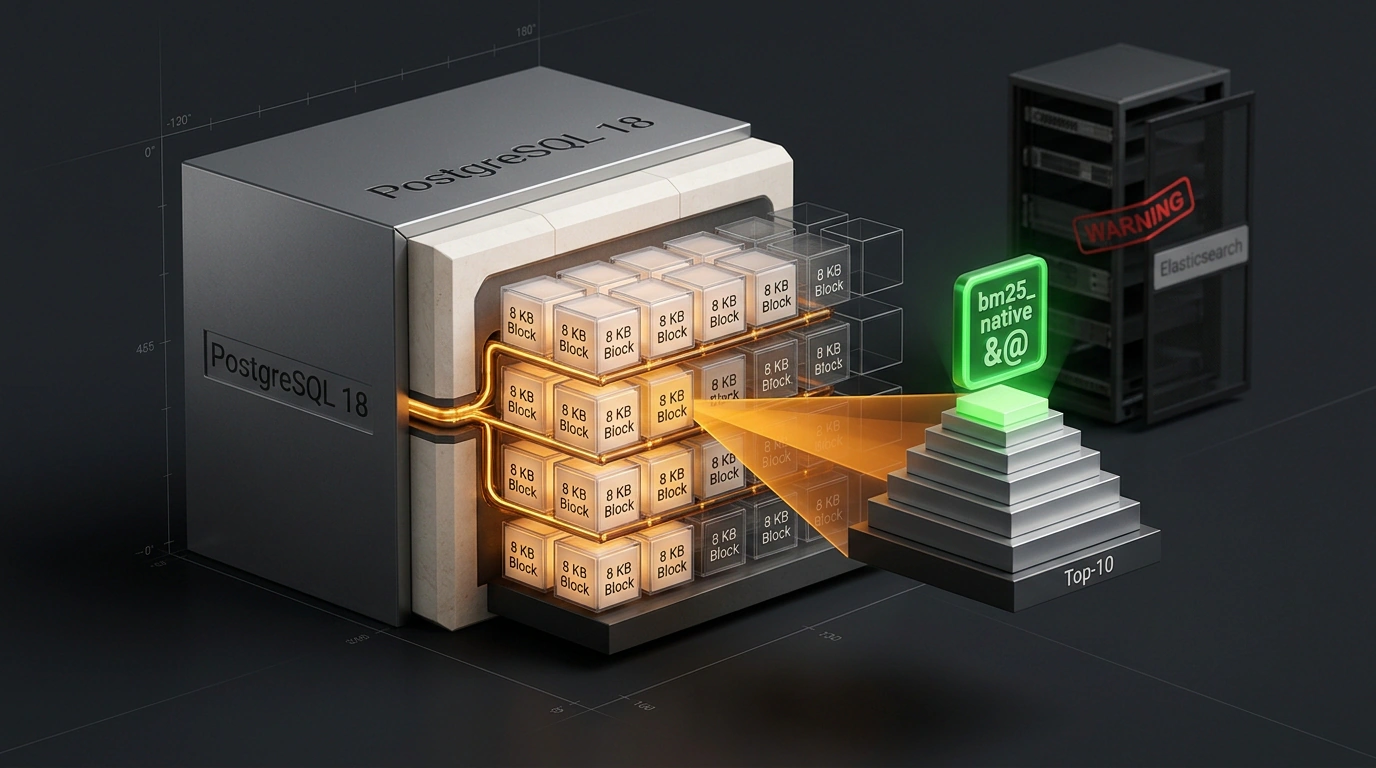
Организация качественного текстового поиска в проектах на PostgreSQL традиционно ставит инженеров перед неприятным выбором. Встроенный полнотекстовый поиск (tsvector и tsquery с индексами GIN) хорошо справляется с простой фильтрацией, но его ранжирование через ts_rank далеко от современных стандартов релевантности. Чтобы выдать пользователю действительно точные результаты, командам приходится разворачивать внешние поисковые кластеры: Elasticsearch, OpenSearch или Meilisearch.
Однако появление отдельного поискового движка влечет за собой колоссальные инфраструктурные издержки: необходимость настраивать захват изменений (CDC через Debezium и Kafka), бороться с рассинхронизацией данных, мириться с нарушением ACID-гарантий и оплачивать дополнительные серверные мощности.
Релиз расширения с открытым исходным кодом pgx-bm25 1.0, разработанного компанией PostgreSQL Experts (PGX, Inc.), предлагает элегантный выход из этого тупика. Проект встраивает признанный индустриальный стандарт ранжирования Okapi BM25 непосредственно в ядро реляционной СУБД в виде нативного метода доступа к индексам.
Метод доступа bm25_native и алгоритм Block-max WAND
В отличие от тяжелых надстроек, pgx-bm25 написан на чистом C против стандартных заголовочных файлов ядра (postgres.h). Сборка выполняется стандартным инструментом PGXS без необходимости тащить в СУБД виртуальные машины Java или внешние компиляторы.
Инженерная сила расширения заключается в его глубокой интеграции с внутренними подсистемами PostgreSQL:
- Физическое хранилище: индексные структуры размещаются в стандартных страницах отношений по 8 КБ. Они автоматически защищены журналом упреждающей записи (WAL), участвуют в создании контрольных точек (checkpoints), очищаются стандартным процессом
VACUUMи без задержек тиражируются на ведомые реплики через потоковую репликацию. - Упорядоченное сканирование (Ordered Index Scan): поисковые запросы типа Top-N отдаются напрямую из индекса в порядке убывания релевантности. Из плана выполнения полностью исчезает узел
Sort. Это предотвращает переполнение рабочей памятиwork_memи мучительные сбросы временных файлов на диск при поиске по миллионам записей. - Алгоритм Block-max WAND: алгоритм динамической оценки блоков отсекает целые диапазоны документов, которые гарантированно не попадут в десятку лучших результатов, избавляя процессор от вычисления точных баллов совпадения для нерелевантных страниц.
Создание индекса BM25F и запросы без узла Sort
Расширение официально поддерживает актуальные ветки PostgreSQL 17 и 18. Для работы достаточно подключить модуль и объявить многоколоночный индекс BM25F, настроив весовые коэффициенты для разных полей таблицы.
-- Подключение расширения к рабочей базе данных
CREATE EXTENSION bm25_native;

-- Создание таблицы базы знаний
CREATE TABLE articles (
    id bigint PRIMARY KEY GENERATED ALWAYS AS IDENTITY,
    title text NOT NULL,
    summary text,
    body text NOT NULL
);

-- Создание многоколоночного индекса с индивидуальными весами полей
CREATE INDEX articles_bm25_idx ON articles
USING bm25_native (title, summary, body)
WITH (
    k1 = 1.2,
    b = 0.75,
    title_boost = 3.0,
    summary_boost = 1.5,
    body_boost = 1.0
);
Синтаксис поисковых запросов опирается на два выразительных оператора: тройная «собака» @@@ выполняет логическую фильтрацию кортежей, а оператор &@@ задает порядок сортировки по алгоритму Okapi BM25.
-- Поиск первых 10 наиболее релевантных статей
-- Запрос выполняется мгновенно без этапа физической сортировки строк
EXPLAIN ANALYZE
SELECT id, title, bm25_score(ctid) AS score
FROM articles
WHERE body @@@ 'highload database replication'
ORDER BY body &@@ 'highload database replication'
LIMIT 10;
Для сложных сценариев расширение предоставляет безопасные jsonb-конструкторы условий (bm25_boolean, bm25_term), исключающие инъекции поискового синтаксиса, а также функцию генерации сниппетов bm25_snippet() с автоматическим HTML-экранированием. Важная практическая деталь: коэффициенты k1, b и веса колонок можно менять на лету командой ALTER INDEX ... SET (...) без блокирующей переиндексации таблицы.
Инженерный вердикт: когда пора отказываться от Elasticsearch
Релиз pgx-bm25 1.0 дает командам разработки надежный повод пересмотреть архитектуру поискового слоя. Если вашему сервису нужен быстрый, релевантный полнотекстовый поиск по каталогу, документации или сообщениям пользователей без фасеточной агрегации терабайтных логов, содержание отдельного кластера Elasticsearch становится избыточной роскошью.
Хранение поискового индекса внутри PostgreSQL гарантирует строгую транзакционную целостность: как только транзакция зафиксирована, новые данные мгновенно доступны поиску. Простота эксплуатации, стандартные бэкапы через pg_dump и отсутствие сетевой синхронизации экономят недели инженерного труда и тысячи долларов инфраструктурного бюджета.