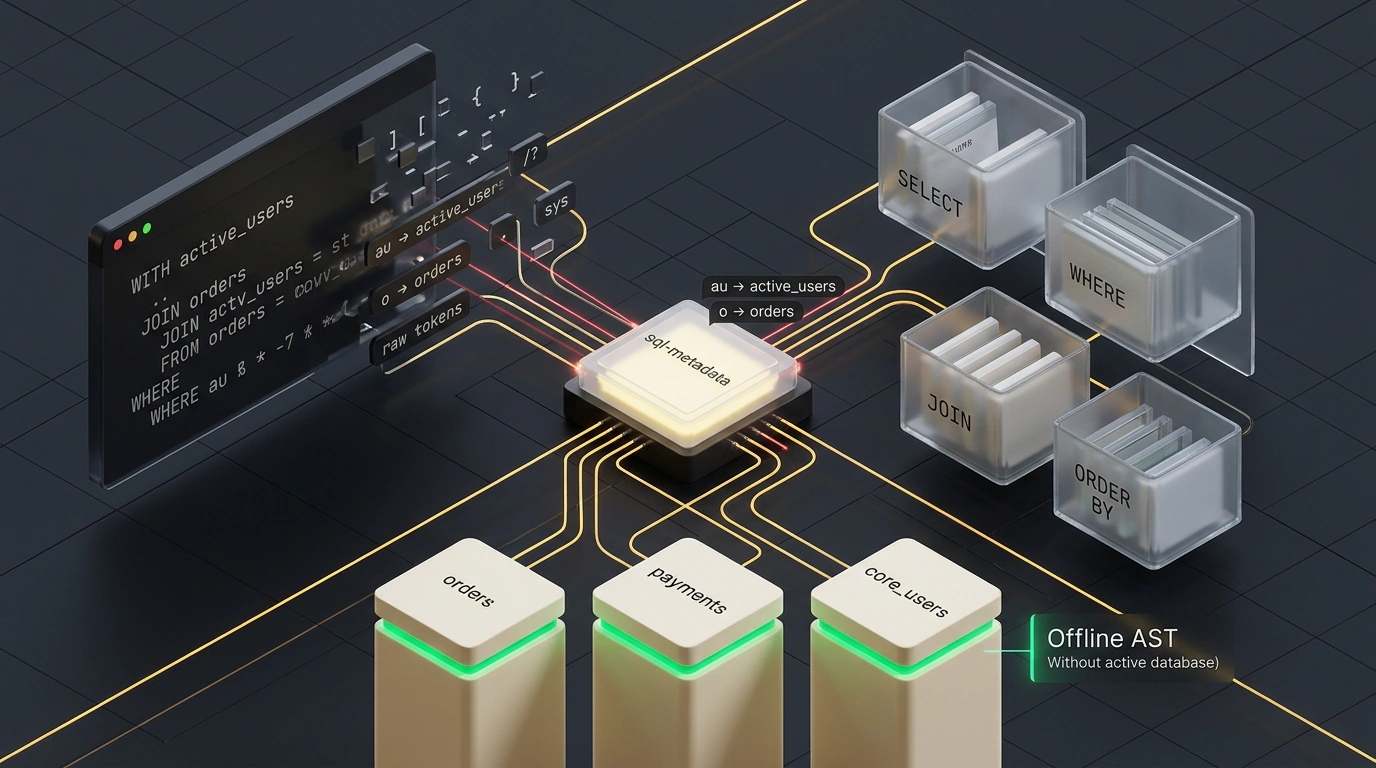

В аналитических платформах, моделях dbt и пайплайнах Airflow ежедневно выполняются тысячи SQL-запросов. Инженерам регулярно требуется анализировать эти выражения: определять читаемые таблицы, выявлять колонки в фильтрах WHERE и объединениях JOIN и отслеживать обращения к персональным данным (PII).
Отправлять EXPLAIN в рабочую СУБД или читать information_schema накладно: тестам в CI/CD нужны доступы к боевой базе, запрос может зависеть от временных таблиц, а лишняя нагрузка замедляет прод. Безопаснее разобрать синтаксис запроса статически в Python без сетевых подключений.
Почему регулярные выражения бессильны перед грамматикой SQL
Ранние библиотеки (например, sqlparse) использовали линейную токенизацию и регулярные выражения. Для простых выражений вида SELECT a FROM b этого хватало. Но в реальных проектах SQL устроен сложнее.
Когда появляются псевдонимы таблиц (FROM orders o), подзапросы и общие табличные выражения (WITH cte AS (...)), линейный парсер теряет контекст. Он не может связать колонку o.amount с физической таблицей и путает виртуальные CTE с реальными источниками. Это напоминает попытку понять смысл текста поиском слов по словарю вместо построения синтаксического дерева связей.
Библиотека sql-metadata (автор Maciej Brencz, macbre) решает эту проблему интеграцией с компилятором sqlglot. Она строит абстрактное синтаксическое дерево (AST) запроса, сохраняя семантику конструкций.
Разрешение псевдонимов и сегментация колонок
Ключевая особенность sql-metadata — автоматическое разрешение псевдонимов (Alias Resolution). Парсер связывает алиасы с исходными таблицами и привязывает колонки к источникам даже через несколько уровней вложенности.
Словарь columns_dict раскладывает поля по смысловым секциям: выборка (select), фильтрация (where), объединения (join) и сортировка (order_by). Это позволяет сразу отделить отображаемые данные от вспомогательных ключей.
Библиотека поддерживает диалекты PostgreSQL, MySQL, SQLite, MSSQL и Apache Hive.
Пример статического анализа запроса с CTE и объединениями:
from sql_metadata import Parser

query = """
WITH active_users AS (
    SELECT id, email FROM core_users WHERE is_active = TRUE
)
SELECT
    au.email,
    o.order_id,
    o.amount,
    p.status AS payment_status
FROM active_users au
JOIN orders o ON o.user_id = au.id
LEFT JOIN payments p ON p.order_id = o.order_id
WHERE o.created_at >= '2026-01-01'
ORDER BY o.amount DESC;
"""

parser = Parser(query)

# 1. Извлечение физических таблиц (виртуальный CTE отфильтрован)
print("Таблицы:", parser.tables)
# ['core_users', 'orders', 'payments']

# 2. Список колонок
print("Все колонки:", parser.columns)
# ['id', 'email', 'is_active', 'order_id', 'amount', 'status', 'user_id', 'created_at']

# 3. Детализация по секциям
print("Секции колонок:", parser.columns_dict)
# {
#   'select': ['active_users.email', 'orders.order_id', 'orders.amount', 'payments.status'],
#   'where': ['core_users.is_active', 'orders.created_at'],
#   'join': ['orders.user_id', 'active_users.id', 'payments.order_id', 'orders.order_id'],
#   'order_by': ['orders.amount']
# }

# 4. Разрешение псевдонимов
print("Псевдонимы:", parser.tables_aliases)
# {'au': 'active_users', 'o': 'orders', 'p': 'payments'}
Нормализация запросов для мониторинга
Функция normalize_sql подготавливает запросы для APM и систем логирования. Она маскирует константы, позволяя группировать однотипные запросы в единый шаблон:
from sql_metadata import normalize_sql

raw_sql = "SELECT id, name FROM users WHERE age > 21 AND status = 'ACTIVE';"
normalized = normalize_sql(raw_sql)

print("Нормализованный запрос:", normalized)
# SELECT id, name FROM users WHERE age > ? AND status = ?;
Прикладная польза в Data Governance
Инструмент применяется в трех основных задачах:
- Построение Data Lineage: автоматическое отслеживание движения данных от сырых таблиц к витринам.
- Аудит безопасности: проверка того, что запросы аналитиков не обращаются к таблицам с персональными данными в обход политик доступа.
- CI/CD линтинг: блокировка миграций с
SELECT *до их попадания в прод.
sql-metadata превращает SQL-скрипты в структурированные метаданные на Python, избавляя от ручного разбора и рисков работы с живой БД.