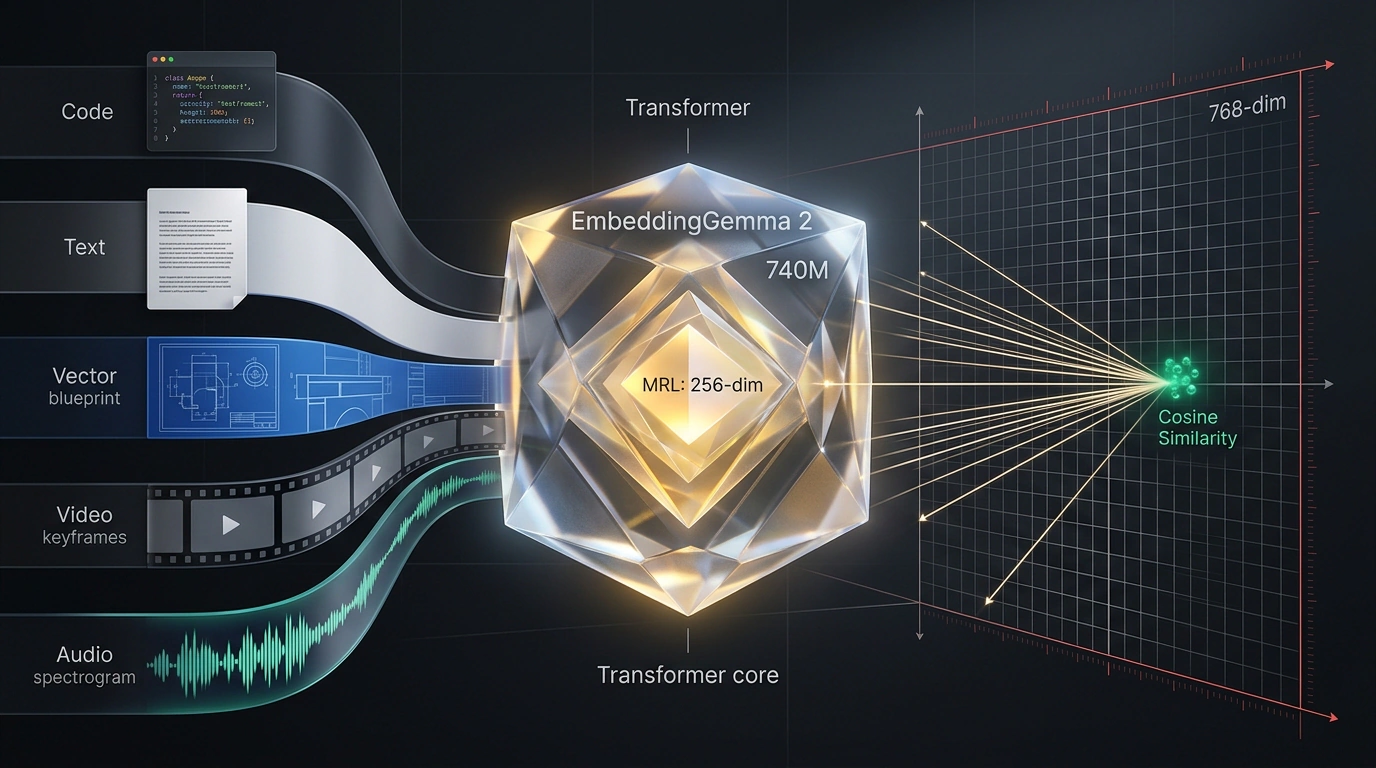

В современных архитектурах семантического поиска и RAG (Retrieval-Augmented Generation) инженеры долгое время мирились с настоящей «Вавилонской башней». Текстовые документы, фрагменты исходного кода, скриншоты ошибок, графические схемы архитектуры и аудиозаписи технических митингов говорили на абсолютно разных цифровых языках.
Чтобы построить корпоративную базу знаний, включающую все эти типы данных, приходилось выстраивать громоздкий конвейер из разнородных моделей. Текст индексировался моделями вроде bge-large или text-embedding-3, изображения скармливались модели CLIP или SigLIP, а аудиофайлы предварительно расшифровывались через тяжелый Whisper. В результате данные оказывались в изолированных векторных пространствах. Вектор картинки из CLIP нельзя напрямую сравнить обычным косинусным расстоянием с вектором текстового запроса из языкового энкодера: они обладают разной размерностью и семантическим распределением. Система поиска превращалась в сложный каскад эвристик, многократных поисковых вызовов и медленной постобработки.
Исследовательская команда Google представила открытую модель EmbeddingGemma 2, которая устраняет эту разобщенность. Построенная на архитектуре семейства Gemma, компактная модель весом 740 млн параметров способна проецировать данные сразу пяти модальностей — текста, исходного кода, изображений, видео и аудио — в единое общее 768-мерное векторное пространство.
Как устроено общее пространство признаков для пяти модальностей
Центральный технологический сдвиг EmbeddingGemma 2 — сквозное кросс-модальное сопоставление (cross-modal alignment). В едином векторном пространстве модели семантически близкие понятия оказываются рядом, независимо от того, в какой форме они были представлены на входе.
Представьте себе международный синхронный перевод. Раньше для общения представителей пяти стран требовалось переводить каждую фразу сначала на английский, теряя интонации и контекст. Общее векторное пространство работает как телепатический канал: текстовая фраза «Схема взаимодействия микросервисов через TokenReview API», графический файл с нарисованной архитектурной диаграммой этой схемы и аудиозапись, где разработчик голосом описывает этот процесс, превращаются в три вектора, направленные практически в одну точку 768-мерного пространства.
Поисковому движку больше не требуется транскрибировать звук в буквы или запускать оптическое распознавание символов (OCR) на скриншотах. Текстовый поисковый запрос напрямую сравнивается с эмбеддингами изображений или аудиодорожек через элементарное скалярное произведение (Dot Product) нормализованных векторов.
Модульные энкодеры и сжатие векторов через MRL
Модель суммарным объемом 740 млн параметров разделена на три независимых модуля:
- Текстовый и кодовый стержень (Text & Code Backbone): 270 млн параметров с поддержкой длинного контекста в 8192 токена;
- Визуальный энкодер (Vision Encoder): 170 млн параметров для анализа фотографий, схем и ключевых видеокадров;
- Аудиоэнкодер (Audio Encoder): 300 млн параметров для прямого анализа спектрограмм речи и звуков.
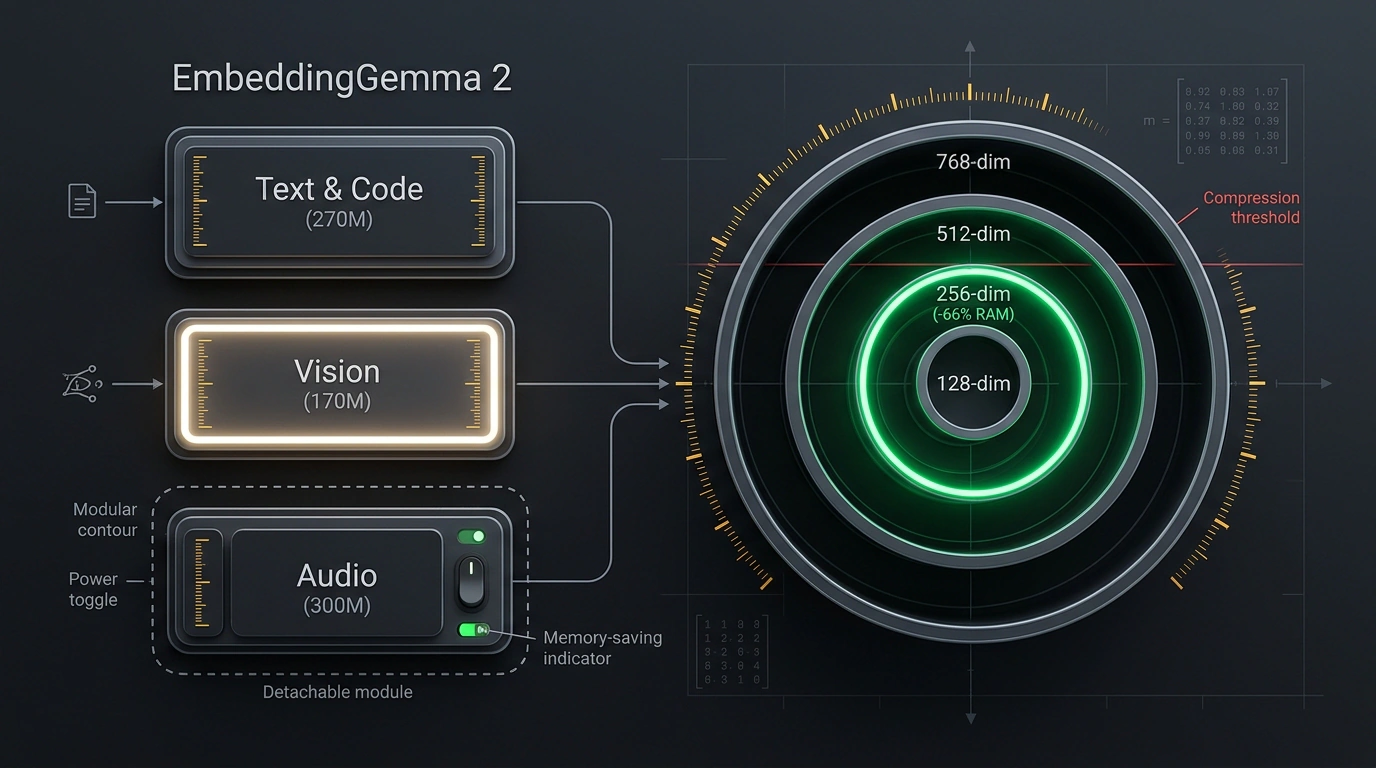
Разработчики не обязаны держать в памяти видеокарты всю модель целиком. Если корпоративная база знаний состоит только из документации, кода и диаграмм, аудиомодуль можно отключить, сэкономив почти половину оперативной памяти.
Второй важный механизм — технология Matryoshka Representation Learning (MRL). Векторы EmbeddingGemma 2 обучались по принципу «матрешки»: наиболее значимая смысловая информация упакована в первые измерения вектора. Базовый вектор имеет размерность 768 чисел с плавающей точкой, однако его можно усечь до 512, 256 или 128 измерений без переобучения модели. Сжатие до 256 измерений экономит до 66% дискового пространства и оперативной памяти в векторных базах (Qdrant, pgvector, Milvus), теряя менее 1.5% точности на бенчмарках.
На тестах MTEB v2 (многоязычный текстовый поиск) и MMEB (мультимодальный поиск) EmbeddingGemma 2 превосходит специализированные решения аналогичного веса, демонстрируя прирост точности в поиске по фрагментам программного кода на 14%.
Практический поиск по тексту и графике на Python
Для работы с моделью в экосистеме Python используется стандартная библиотека transformers. В коде ниже показан процесс загрузки модели, одновременной генерации эмбеддингов для текстового запроса и графической архитектурной схемы, вычисление косинусного сходства и сжатие векторов через механизм MRL:
import torch
import torch.nn.functional as F
from PIL import Image
from transformers import AutoModel, AutoProcessor

model_id = "google/embeddinggemma-2"

# Инициализация процессора и весов модели
processor = AutoProcessor.from_pretrained(model_id)
model = AutoModel.from_pretrained(
    model_id,
    torch_dtype=torch.bfloat16,
    device_map="auto"
)

# 1. Текстовый запрос разработчика
query_text = "Схема взаимодействия микросервисов через TokenReview API"
text_inputs = processor(text=[query_text], return_tensors="pt", padding=True).to(model.device)

with torch.no_grad():
    text_outputs = model.get_text_features(**text_inputs)
    # Нормализация L2 для расчета косинусного расстояния
    query_emb = F.normalize(text_outputs, p=2, dim=-1)

# 2. Индексация изображения (архитектурный чертеж)
diagram_image = Image.open("architecture_diagram.png").convert("RGB")
image_inputs = processor(images=[diagram_image], return_tensors="pt").to(model.device)

with torch.no_grad():
    image_outputs = model.get_image_features(**image_inputs)
    image_emb = F.normalize(image_outputs, p=2, dim=-1)

# 3. Вычисление релевантности (Dot Product = Cosine Similarity)
similarity_768 = torch.matmul(query_emb, image_emb.T).item()
print(f"Сходство на 768-мерных векторах: {similarity_768:.4f}")

# 4. Применение Matryoshka Representation Learning (срез первых 256 измерений)
query_emb_256 = F.normalize(query_emb[:, :256], p=2, dim=-1)
image_emb_256 = F.normalize(image_emb[:, :256], p=2, dim=-1)

similarity_256 = torch.matmul(query_emb_256, image_emb_256.T).item()
print(f"Сходство на усеченных векторах 256-dim: {similarity_256:.4f}")
Как видно из листинга, для усечения вектора достаточно срезать срез тензора [:, :256] и повторно нормализовать длину вектора функцией F.normalize. Это открывает возможность двухэтапного поиска: быстрый грубый фильтр по 128-мерным векторам в оперативной памяти с последующим точным ранжированием топ-50 кандидатов по полным 768-мерным векторам.
Запуск локального HTTP-сервера эмбеддингов через llama.cpp
Благодаря компактному размеру модель отлично квантуется. Сообщество открытого проекта Unsloth подготовило квантованные веса в формате GGUF (unsloth/embeddinggemma-2-GGUF), позволяющие запускать инференс на процессорах с векторными инструкциями AVX-512 или чипах Apple Silicon (через Metal) с потреблением менее 1.5 ГБ оперативной памяти.
Для интеграции в локальные сервисы достаточно запустить легковесный HTTP-сервер из экосистемы llama.cpp:
# 1. Скачивание квантованного файла весов Q4_K_M
curl -LO https://huggingface.co/unsloth/embeddinggemma-2-GGUF/resolve/main/embeddinggemma-2-Q4_K_M.gguf

# 2. Запуск встроенного сервера эмбеддингов
./llama-server \
  -m embeddinggemma-2-Q4_K_M.gguf \
  --embedding \
  --port 8080 \
  -c 8192 \
  --threads 8
Сервер разворачивает OpenAI-совместимый эндпоинт /v1/embeddings, готовый принимать запросы от локальных оркестраторов LangChain, LlamaIndex или пользовательских скриптов.
Архитектурные границы и прикладной вердикт
Открытая коммерческая лицензия Apache 2.0 дает зеленый свет на использование EmbeddingGemma 2 в закрытых корпоративных контурах. Объединив эту модель эмбеддингов с компактной генеративной LLM (например, Gemma 2B или Mistral 7B), инженерные команды получают полностью автономный офлайн-RAG. Чувствительный исходный код, клиентские договоры и внутренние видеозаписи больше не нужно отправлять во внешние облачные API.
При проектировании пайплайнов важно учитывать физические ограничения:
- Обработка видео: длинные видеоролики требуют предварительного сэмплирования кадров (например, 1 кадр в 2 секунды) с последующим пулингом векторов, что требует вычислительного времени.
- Длина контекста: хотя окно в 8192 токена достаточно для большинства файлов и функций кода, крупные репозитории требуют стандартного разбиения на логические чанки.
EmbeddingGemma 2 устанавливает новый ориентир компактных мультимодальных моделей: одна легковесная открытая нейросеть заменяет разрозненный зоопарк узкоспециализированных конвертеров, объединяя весь спектр мультимедийных данных в чистой и быстрой векторной геометрии.