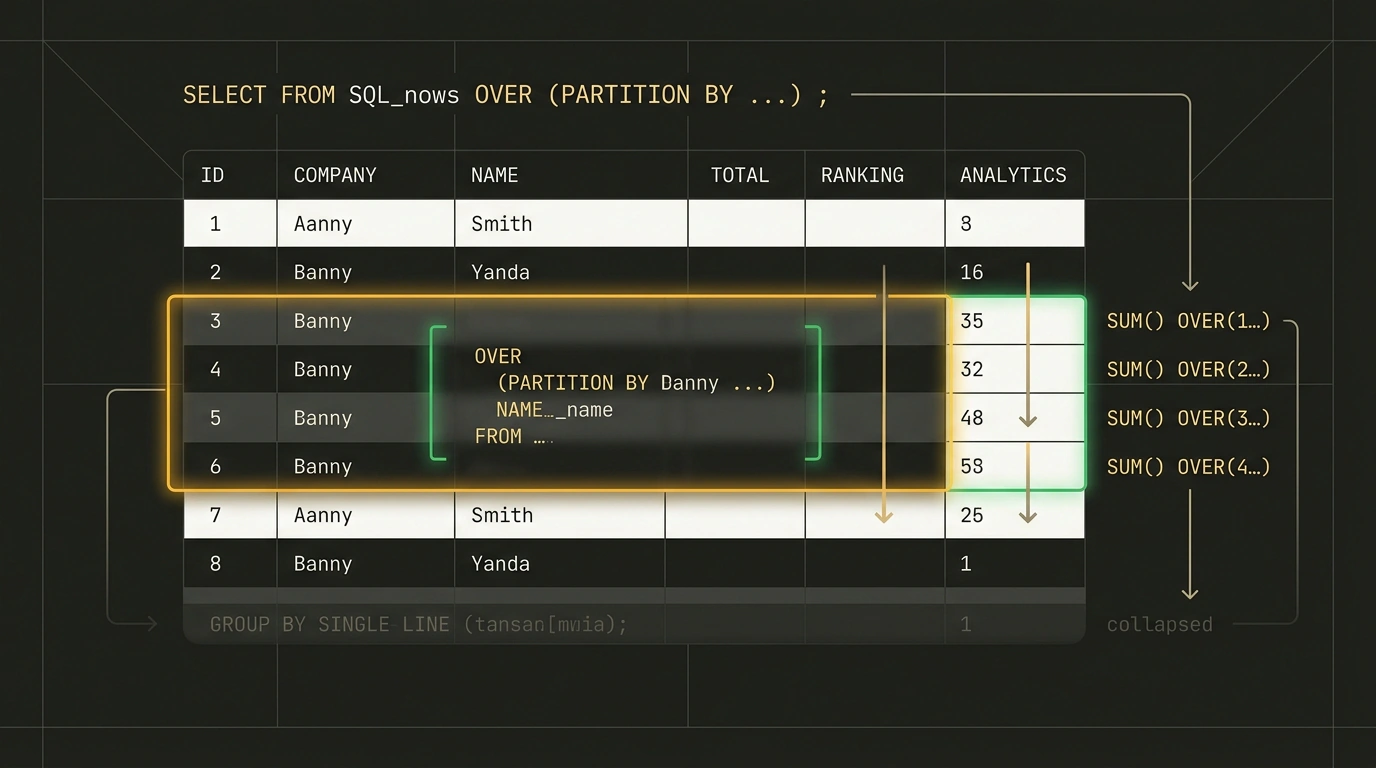

Каждый разработчик или аналитик, работающий с реляционными базами данных, неизбежно сталкивается с задачей расчета накопительных итогов, скользящих средних или поиска лидеров продаж внутри категорий. Классический инструментарий SQL предлагает для агрегации оператор GROUP BY. Однако у него есть фатальное для детальной аналитики свойство: он безжалостно схлопывает (коллапсирует) исходные строки в единственную результирующую запись на группу.
Чтобы посчитать долю конкретного заказа в общей выручке клиента или сравнить сумму чека со средним чеком за прошлую неделю, разработчикам прошлого приходилось писать уродливые самосоединения (JOIN) и коррелированные подзапросы. Запросы работали с квадратичной сложностью, перегружали дисковую подсистему СУБД и читались как зашифрованные послания. Стандарт оконных функций (Window Functions) решает эту проблему элегантно: вычисления производятся над связанным набором строк, сохраняя каждую строку исходной таблицы нетронутой.
Почему классический GROUP BY стирает детализацию данных
В традиционной парадигме агрегации выборка группируется по ключу: если у вас есть таблица из ста тысяч заказов тридцати магазинов, запрос с GROUP BY store_id вернет ровно тридцать строк. Все индивидуальные идентификаторы чеков, точные временные метки и имена покупателей растворяются в агрегатах SUM() и COUNT(). Если вам требуется вывести каждую отдельную покупку, но при этом приписать к ней процент от дневного оборота магазина, обычный GROUP BY бессилен без повторного объединения таблицы самой с собой.
Оконные функции работают иначе. Они не меняют геометрию результирующего набора: сколько строк вошло в выборку после фильтрации WHERE, столько же строк останется на выходе. Но для каждой отдельной строки СУБД формирует виртуальное «окно» — контекстный срез связанных с ней записей, на основе которого вычисляется значение.
Анатомия секции OVER: окна, сортировка и границы фреймов
Вся магия оконных вычислений сосредоточена в управляющей конструкции OVER (...). Она состоит из трех независимых компонентов:
PARTITION BY <столбцы>— разбивает весь массив данных на изолированные карманы (окна), внутри которых функция производит расчет независимо (аналог групп, но без схлопывания).ORDER BY <столбцы>— задает детерминированный порядок обхода строк внутри окна, что критично для расчета накопительных сумм или динамики во времени.- Оконный фрейм
ROWS BETWEEN ...— определяет скользящие границы расчета относительно текущей строки (например, «текущая строка и две предыдущие»).
-- Расчет накопительного итога продаж и динамики к предыдущему дню
SELECT
    category,
    sale_date,
    amount,
    -- Накопительный итог внутри категории по дням
    SUM(amount) OVER (
        PARTITION BY category
        ORDER BY sale_date
        ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
    ) AS running_total,
    -- Значение чека из предыдущей строки для расчета дельты
    amount - LAG(amount, 1, 0) OVER (
        PARTITION BY category
        ORDER BY sale_date
    ) AS diff_to_previous_day
FROM sales
ORDER BY category, sale_date;
Скользящие итоги, смещения LAG и ранжирование через CTE
Функции смещения LAG() и LEAD() позволяют заглядывать в прошлое и будущее без накладных расходов: вычислить темп прироста выручки или интервал между визитами пользователя теперь можно в одну строчку. А для задач ранжирования SQL предлагает три взаимодополняющие функции:
ROW_NUMBER()— присваивает строкам строгую сквозную нумерацию 1, 2, 3... независимо от совпадения значений;RANK()— присваивает одинаковый ранг при равенстве значений, но пропускает следующие номера (1, 2, 2, 4);DENSE_RANK()— присваивает одинаковый ранг без пропусков (1, 2, 2, 3).
Важное архитектурное правило стандартов SQL: оконные функции вычисляются на самом последнем этапе пайплайна выполнения запроса, уже после фильтрации WHERE и агрегации GROUP BY. Поэтому оконную функцию нельзя поставить напрямую в условие WHERE rank <= 2. Для фильтрации выборки результат окна оборачивают в общее табличное выражение (CTE):
-- Поиск двух самых крупных чеков в каждой категории товаров
WITH RankedTransactions AS (
    SELECT
        category,
        sale_date,
        amount,
        DENSE_RANK() OVER (
            PARTITION BY category
            ORDER BY amount DESC
        ) AS rank_in_category
    FROM sales
)
SELECT
    category,
    sale_date,
    amount,
    rank_in_category
FROM RankedTransactions
WHERE rank_in_category <= 2
ORDER BY category, rank_in_category;
Оптимизатор СУБД (PostgreSQL, ClickHouse, MySQL) выполняет такие запросы через специализированный узел плана WindowAgg. Если под секцию PARTITION BY и ORDER BY создан составной B-Tree индекс, СУБД считывает данные из индекса в готовом порядке за один проход ($O(N)$), вообще не тратя оперативную память на промежуточную сортировку. Оконные функции превращают аналитические расчеты из ресурсоемкого кошмара в предсказуемую и высокопроизводительную операцию.