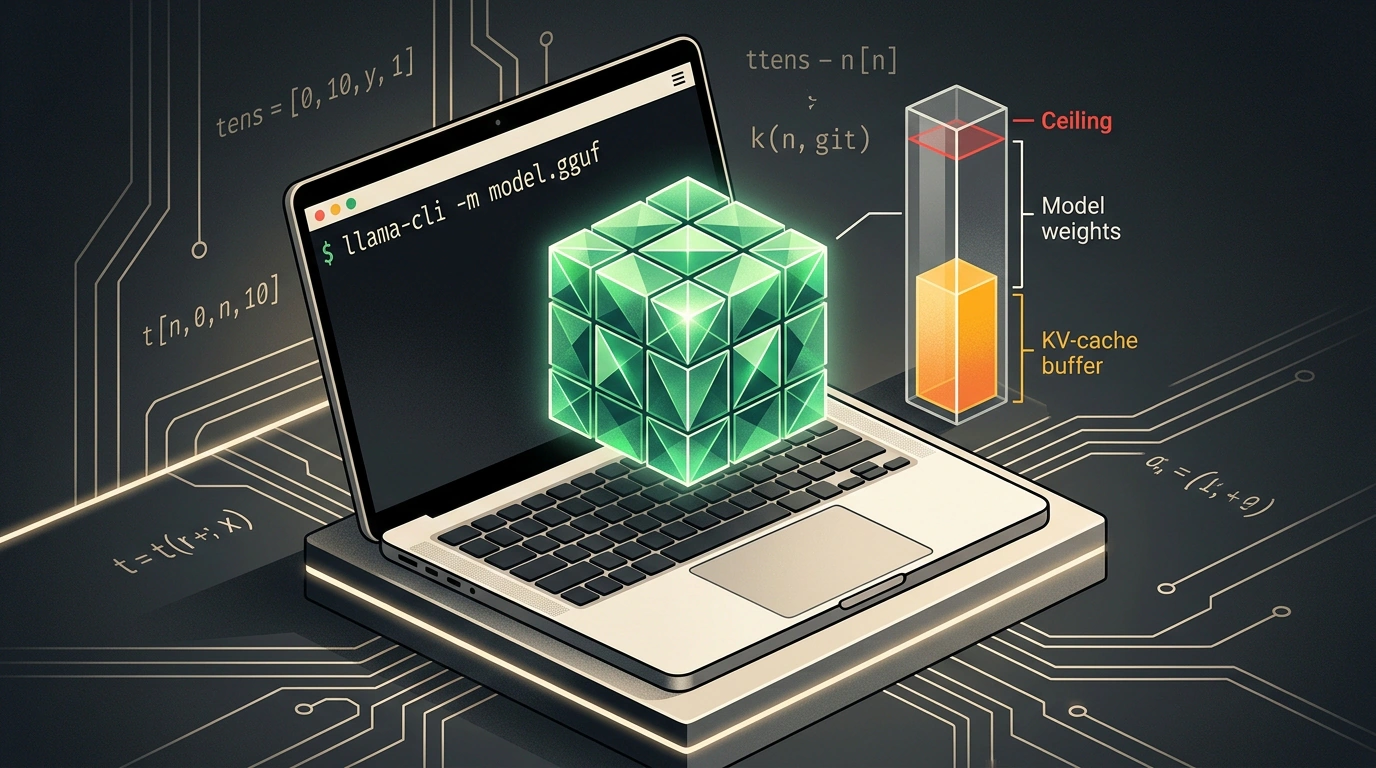

Среди разработчиков до сих пор распространен миф: чтобы запустить производительную языковую модель для анализа кода или локального поиска, непременно нужны серверные видеокарты enterprise-уровня и бесконечные бюджеты на облачные токены. На практике современный рабочий ноутбук вполне способен стать автономной лабораторией искусственного интеллекта. Вы получаете полную независимость от интернета, абсолютную конфиденциальность исходного кода и нулевую стоимость запросов.
Ключом к демократизации локального инференса стала связка двух технологий: эффективного формата квантизации GGUF и сверхбыстрого C++-рантайма llama.cpp от Георгия Герганова. Разберем, как подготовить окружение, рассчитать объем памяти и запустить модель класса 7B–8B (например, Mistral 7B или Llama 3) на обычной потребительской машине.
Арифметика квантизации: как сжать 14 гигабайт в карман
В исходном виде веса модели класса 7 миллиардов параметров поставляются с плавающей точкой полуторной точности (FP16). Каждый параметр занимает 16 бит (2 байта), что требует около 14 ГБ дискового пространства и не менее 16–20 ГБ видеопамяти только для загрузки матрицы весов в оперативную память. Обычный офисный ноутбук просто захлебнется от нехватки ресурсов.
На помощь приходит квантизация — процесс математического сжатия весовых коэффициентов до меньшей разрядности. Самым сбалансированным стандартом де-факто стал метод Q4_K_M (4 бита на вес со смешанной точностью критических слоев внимания):
- Объем модели уменьшается более чем в три раза — с 14 ГБ до скромных 4,4 ГБ;
- Смысловые потери при генерации текста и понимании сложных инструкций остаются в пределах погрешности (менее 1–2% перплексии);
- Модель упаковывается в единый бинарный контейнер формата GGUF, объединяющий матрицу весов, метаданные архитектуры и токенизатор.
Анатомия памяти: почему длинный контекст съедает оперативку
Критическая ошибка новичков — расчет доступных ресурсов только по размеру скачанного .gguf-файла. Память приложения складывается из двух независимых составляющих:
- Статический вес модели: рассчитывается по формуле
(Параметры * Битность) / 8 + накладные расходы тензоров. Для 7B модели в квантизации 4 бита это около 3,5–4,4 ГБ. - Динамический буфер внимания (KV-кэш): оперативная память, необходимая для хранения ключей и значений токенов текущего диалога.
Размер KV-кэша растет строго линейно с глубиной контекстного окна. Если вы задаете скромный контекст в 2 048 токенов, кэш займет около 500 МБ. Но если вы передаете в модель объемную документацию на 16 000 или 32 000 токенов, только под буфер контекста потребуется от 2 до 5 ГБ оперативной памяти сверх весов самой модели. Для комфортной работы на ноутбуке с 16 ГБ RAM оптимально выбирать контекст в диапазоне 4 096–8 192 токенов.
Пошаговая инструкция: от загрузки весов до первого промпта
Инструкция ориентирована на локальный терминал macOS, Linux или Windows (WSL2).
Шаг 1. Подготовка инструментария
Убедитесь, что процессор поддерживает набор инструкций AVX2 (все современные чипы Intel Core и AMD Ryzen) или используйте Apple Silicon (серии M1–M4). Установите официальный CLI-клиент Hugging Face через менеджер пакетов Python:
# Установка официальной утилиты загрузки с Hugging Face Hub
pip install -U "huggingface_hub[cli]"
Саму утилиту llama.cpp можно установить через пакетный менеджер (на macOS: brew install llama.cpp) либо скачать готовый скомпилированный архив llama-cli со страницы релизов репозитория GitHub.
Шаг 2. Загрузка оптимизированного весового файла
Загружаем проверенный квант модели Mistral-7B-Instruct-v0.2 в выделенную папку:
# Скачивание файла Q4_K_M в локальную директорию models
hf download TheBloke/Mistral-7B-Instruct-v0.2-GGUF \
  mistral-7b-instruct-v0.2.Q4_K_M.gguf \
  --local-dir ./models
Шаг 3. Запуск инференса через llama-cli
Для выполнения генерации используется утилита llama-cli. Ключевой параметр здесь — -ngl (--n-gpu-layers), отвечающий за перенос слоев нейросети в память видеокарты:
# Сценарий для Apple Silicon или мощной GPU: выгрузка всех слоев в VRAM (-ngl 99)
llama-cli \
  -m ./models/mistral-7b-instruct-v0.2.Q4_K_M.gguf \
  -ngl 99 \
  -c 4096 \
  -p "Объясни простыми словами, чем стек вызовов отличается от кучи в памяти?"

# Сценарий для ноутбука со слабой дискретной картой (2 ГБ VRAM): гибридный режим
llama-cli \
  -m ./models/mistral-7b-instruct-v0.2.Q4_K_M.gguf \
  -ngl 14 \
  -c 2048 \
  --threads 6 \
  -p "Напиши функцию на Python для поиска дубликатов в списке."
Тонкая настройка выгрузки слоев и аппаратные компромиссы
При запуске программы в терминале отобразится системный лог: тип инициализированного бэкенда (Metal, CUDA или Vulkan), число слоев в VRAM и результирующая скорость генерации (tokens per second).
Главный риск при настройке — ошибка Out Of Memory (OOM). Если попытаться выгрузить слишком много слоев в ограниченную видеопамять дискретной карты, процесс аварийно завершится. Поэтому на машинах с небольшим объемом VRAM значение -ngl увеличивают постепенно — начиная с 10–12 слоев.
Скоростные ожидания стоит калибровать реалистично:
- Чистый CPU: скорость генерации для модели 7B составляет 4–8 токенов в секунду. Этого вполне достаточно для комфортного вдумчивого чтения ответов;
- Apple Silicon (M-чипы с объединенной памятью) или полноценный GPU: инференс разгоняется до 25–45 токенов в секунду, опережая скорость человеческого чтения.
Локальный запуск через llama.cpp обеспечивает главное: стабильную, независимую от внешних серверов среду, в которой ваши промпты и данные остаются исключительно на вашей машине.