

Когда Data Science команда впервые доводит большую языковую модель или эмбеддинг до готовности к продакшену, обычно возникает соблазн сделать все «по-быстрому»: взять Dockerfile, положить туда Python, FastAPI, библиотеку Transformers, написать роут /predict и раскатить обычный манифест Deployment в кластер Kubernetes.
Первую неделю всё выглядит великолепно. Но затем начинаются суровые инфраструктурные будни:
- Нагрузка выросла: встроенный
HorizontalPodAutoscaler(HPA) ориентируется на загрузку CPU или памяти узла. Но видеокарта GPU может быть забита на 100% просто аллокацией KV-кэша, даже если запросов сейчас нет! HPA начинает бесконтрольно плодить поды, выгребая все свободные карты в кластере. - Ночью наступило затишье: запросов нет, но поды продолжают висеть, резервируя под себя инстансы с NVIDIA A100 или H100 по несколько долларов в час за каждый ускоритель.
- Нужно выкатить новую версию весов модели: как переключить 10% трафика на канарейку, не перегружая память и не дублируя инфраструктуру?
Чтобы решить эти проблемы на уровне индустриального стандарта, сообщество Cloud Native Computing Foundation (CNCF) создало проект KServe (ранее известный как KFServing). Давай разберем архитектуру KServe, связку с рантаймом vLLM и пошаговую настройку манифеста InferenceService.
Архитектура KServe: из чего состоит платформа?
KServe — это не просто один бинарник. Это оператор Kubernetes, который гармонично объединяет три мощных фундаментальных слоя:
- Сетевой слой (Istio Service Mesh): обеспечивает интеллектуальную маршрутизацию входящего трафика, mTLS-шифрование, разделение потоков для канареечных релизов (Traffic Splitting) и сбор детальных метрик по задержкам ответов.
- Бессерверный слой (Knative Serving): берет на себя управление жизненным циклом реплик, перехват очередей через сайдкар
queue-proxyи масштабирование в ноль (Scale-to-Zero), когда нагрузка отсутствует. - Слой рантаймов инференса: KServe поддерживает готовые оптимизированные среды выполнения — vLLM, Triton Inference Server от NVIDIA, HuggingFace TGI, TorchServe и ONNX Runtime.
Вместо того чтобы вручную собирать по кирпичикам Deployment, Service, Ingress, HPA и сетевые политики, платформенный инженер объявляет единый Custom Resource — InferenceService.
Разработчики платформы разделяют конвейер обработки на три логических звена:
- Transformer: вспомогательный сервис предобработки (например, токенизация текста или изменение размера картинок) и постобработки результатов.
- Predictor: главное вычислительное ядро, где живут веса модели и графические процессоры.
- Explainer: специализированный узел интерпретируемости (LIME, SHAP), объясняющий логику принятого моделью решения.
Такое разделение позволяет вынести легкую CPU-нагрузку (токенизацию) на дешевые вычислительные узлы, оставив дорогую память GPU исключительно под вычисление тензоров. Вопросы правильного проектирования инфраструктуры для нейросетей мы также затрагивали, когда изучали применение паттернов проектирования Kubernetes к нагрузкам больших языковых моделей.
Роль vLLM: непрерывный батчинг и PagedAttention
В современных LLM-пайплайнах узким местом почти всегда становится управление видеопамятью (VRAM). Традиционные библиотеки аллоцируют память под максимальную длину контекста статично, что приводит к дикой фрагментации: до 60–80% VRAM просто простаивает.
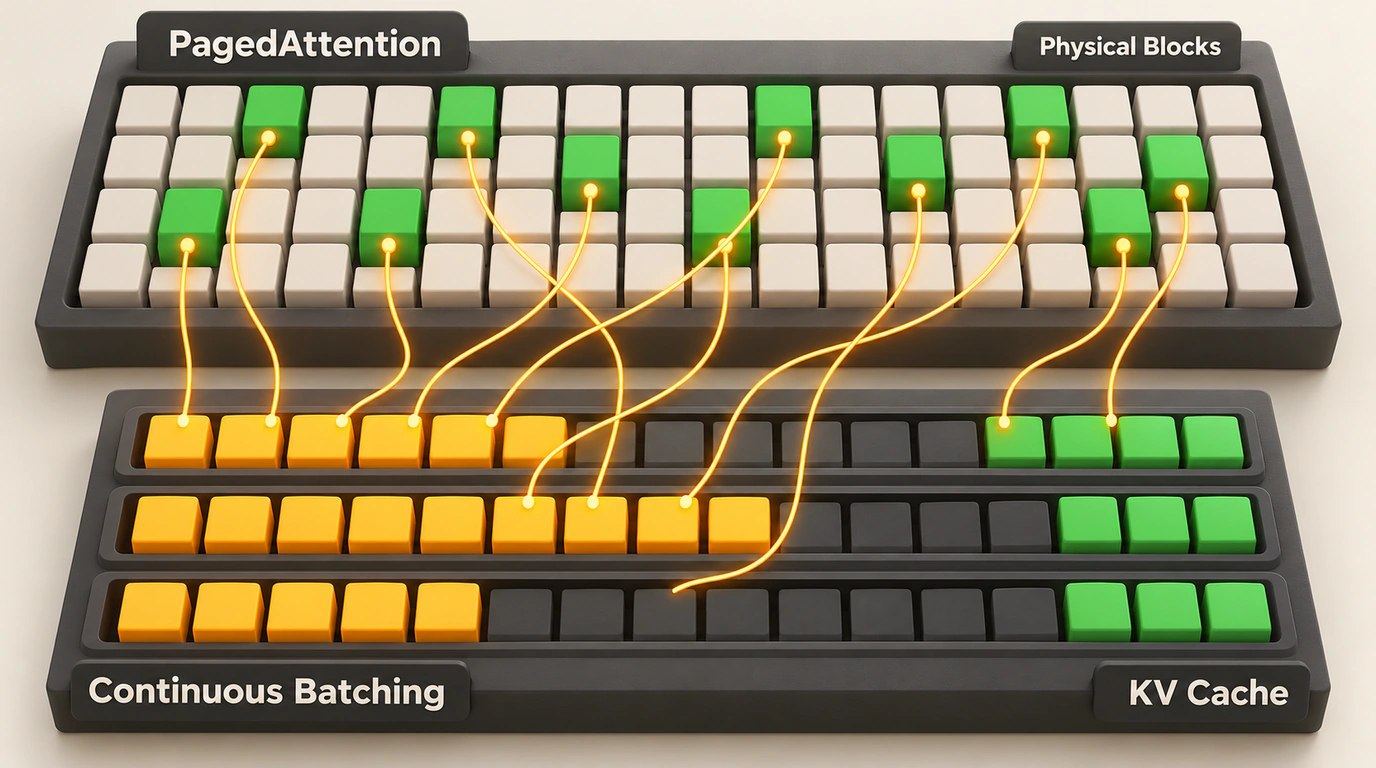
Движок vLLM внедрил алгоритм PagedAttention: память для Key-Value кэша внимания выделяется динамически страницами фиксированного размера, аналогично страницам виртуальной памяти в операционных системах. В сочетании с непрерывным батчингом (Continuous Batching), vLLM позволяет упаковывать в один графический процессор в 2–4 раза больше одновременных запросов с минимальной задержкой первого токена (TTFT).
KServe v0.14+ поддерживает vLLM как нативный ServingRuntime.
Пошаговое руководство: развертывание InferenceService
Давай развернем продакшен-сервис для модели Qwen-2.5-7B-Instruct с использованием KServe и vLLM.
Шаг 1: Подготовка кластера
Для работы потребуется кластер Kubernetes 1.28+ с установленными операторами NVIDIA GPU Operator, Istio, Knative Serving и KServe Operator. Модель заранее сохранена в корпоративный S3-бакет s3://ml-models/qwen-2.5-7b-instruct/.
Шаг 2: Манифест InferenceService
Создаем файл qwen-inference.yaml:
apiVersion: serving.kserve.io/v1beta1
kind: InferenceService
metadata:
  name: qwen-llm-service
  namespace: ml-inference
  annotations:
    serving.kserve.io/autoscalerClass: "kpa"
    autoscaling.knative.dev/target: "10"
    autoscaling.knative.dev/metric: "concurrency"
spec:
  predictor:
    minReplicas: 1
    maxReplicas: 5
    model:
      modelFormat:
        name: vLLM
      storageUri: "s3://ml-models/qwen-2.5-7b-instruct/"
      resources:
        limits:
          cpu: "8"
          memory: "32Gi"
          nvidia.com/gpu: "1"
        requests:
          cpu: "4"
          memory: "16Gi"
          nvidia.com/gpu: "1"
      args:
        - "--model=/mnt/models"
        - "--tensor-parallel-size=1"
        - "--max-model-len=8192"
        - "--gpu-memory-utilization=0.9"
Разберем ключевые параметры:
storageUri: KServe автоматически запускает вспомогательный init-контейнерStorage Initializer, который скачивает веса модели из S3 в локальный том пода перед стартом vLLM.autoscaling.knative.dev/metric: "concurrency": масштабирование ориентируется не на CPU, а на количество одновременно обрабатываемых запросов на реплику (таргет: 10 параллельных сессий).minReplicas: 1: для больших моделей рекомендуется держать минимум одну теплую реплику, чтобы пользователи не ждали холодного старта.
Применяем манифест:
kubectl apply -f qwen-inference.yaml
Шаг 3: Верификация статуса и проверка инференса
Проверяем статус развертывания через CLI:
# Проверяем готовность подов и URL сервиса
kubectl get inferenceservice qwen-llm-service -n ml-inference
В выводе команды поле READY должно перейти в статус True, а в столбце URL появится назначенный адрес сервиса.
Теперь протестируем работу модели через стандартный OpenAI-совместимый эндпоинт:
curl -s -X POST "http://istio-ingressgateway.istio-system.svc.cluster.local/v1/chat/completions" \
  -H "Host: qwen-llm-service.ml-inference.example.com" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen-llm-service",
    "messages": [
      {"role": "system", "content": "Ты опытный инженер-исследователь."},
      {"role": "user", "content": "В чем главное преимущество PagedAttention?"}
    ],
    "max_tokens": 128,
    "temperature": 0.7
  }'
Холодный старт и компромиссы Scale-to-Zero
Масштабирование в ноль (minReplicas: 0) — великолепная идея на бумаге: если ночью запросов нет, поды гаснут, и компания не платит за аренду GPU.
Однако в реальности холодный старт модели весом 15–30 гигабайт состоит из трех фаз:
- Запуск пода и планирование на ноду (5–15 сек).
- Скачивание весов из S3 по внутренней сети кластера (20–60 сек).
- Загрузка тензоров в память GPU (VRAM) и компиляция графа CUDA (15–30 сек).
В итоге первый пришедший клиент может прождать ответа больше минуты! Поэтому компромисс прост: для внутренних фоновых batch-задач смело выставляй minReplicas: 0. Но для диалоговых ботов и клиентских сервисов держи minReplicas: 1, делегируя автомасштабированию только пиковые всплески.