
Казалось бы, что может быть проще в программировании, чем узнать длину строки? В любом базовом учебнике на третьей странице написано: вызываешь str.length или len(s) — и дело в шляпе.
Но давай проведем простой эксперимент. Возьмем одну и ту же безобидную строку — эмодзи семьи: "👨👩👧👦". И спросим у четырех популярных языков программирования, какова длина этой строки.
Вот какие ответы мы получим:
- JavaScript:
11 - Python 3:
7 - Go:
25 - Rust:
25(байты) или7(символы)
Один видимый человеческому глазу символ на экране — и четыре совершенно разных ответа! И если в клиентском коде на JavaScript ты поставил валидацию логина или комментария if (input.length > 10) return error;, то твой пользователь даже не сможет отправить одно-единственное эмодзи, потому что JavaScript считает, что там уже одиннадцать символов.
А если ты передашь эту строку в бэкенд на Go и наивно сделаешь срез первых пяти элементов, сервис мгновенно упадет в панику или превратит текст в битые кракозябры. О том, почему срез s0:3 в Go ломает UTF-8 кодировку, мы уже как-то рассуждали, но сегодня давай разберем всю анатомию Unicode до самого основания.
Четыре уровня реальности в Unicode
Чтобы понять, почему языки дают разные ответы, нужно осознать: понятие «символ» в стандарте Unicode не существует в единственном числе. Есть четыре фундаментальных уровня представления текста:
- Байты (Bytes): сырые физические октеты в оперативной памяти или на диске. В кодировке UTF-8 один символ может занимать от 1 до 4 байт.
- Кодовые единицы (Code Units): минимальная неделимая ячейка конкретной кодировки. В UTF-16 кодовая единица — это 16 бит (2 байта). В UTF-8 — 8 бит (1 байт).
- Кодовые точки (Code Points): абстрактный порядковый номер символа в таблице Unicode (от
U+0000доU+10FFFF). Например, латинская букваAимеет кодовую точкуU+0041. - Графемные кластеры (Grapheme Clusters): то, что обычный человек воспринимает как одну неделимую графическую букву или значок на экране смартфона.
Наш эмодзи семьи "👨👩👧👦" на самом деле состоит из четырех отдельных фигурок людей:
- Мужчина (
U+1F468) - Женщина (
U+1F469) - Девочка (
U+1F467) - Мальчик (
U+1F466)
А между ними стоят невидимые склеивающие символы — Zero-Width Joiner (ZWJ, U+200D)! Всего 4 фигуры + 3 склейщика = 7 кодовых точек.
В UTF-8 каждая фигура занимает по 4 байта, а каждый ZWJ — по 3 байта: (4 * 4) + (3 * 3) = 25 байт.
В UTF-16 каждая фигура не влезает в 16 бит и кодируется парой суррогатов (2 кодовые единицы по 16 бит = 8 единиц на фигуры), плюс 3 обычные кодовые единицы на ZWJ = 11 кодовых единиц.
Как устроена память в языках: смотрим в код
Давай посмотрим, как разные среды работают с этой строкой и как правильно вычислять человеческую длину.
1. JavaScript: пленник наследия UTF-16
JavaScript создавался в 1995 году, когда стандарт Unicode надеялся уместить все символы мира в 16 бит. Поэтому строки в JS исторически представляют собой последовательность 16-битных кодовых единиц UTF-16:
const family = "👨👩👧👦";
console.log(family.length); // 11 (кодовые единицы UTF-16)
// Наивный spread оператор разбивает только суррогатные пары, но не ZWJ!
console.log([...family].length); // 7 (кодовые точки)
// ПРАВИЛЬНО: сегментация на графемные кластеры через Intl.Segmenter
const segmenter = new Intl.Segmenter("ru", { granularity: "grapheme" });
const graphemes = [...segmenter.segment(family)];
console.log(graphemes.length); // 1 (настоящий видимый символ!)
Современный Intl.Segmenter — единственный надежный способ узнать реальное количество видимых символов в браузере и Node.js.
2. Python 3: гибкое представление PEP 393
В Python 3 строки внутри оптимизированы: интерпретатор использует 1, 2 или 4 байта на символ в зависимости от максимальной кодовой точки в строке.
Функция len() в Python всегда возвращает количество кодовых точек:
import unicodedata
family = "👨👩👧👦"
print(len(family)) # 7 (кодовые точки: 4 фигуры + 3 ZWJ)
# Для подсчета реальных графем требуется библиотека regex с флагом X
import regex
graphemes = regex.findall(r'X', family)
print(len(graphemes)) # 1 (настоящий графемный кластер)
3. Go: строгий UTF-8 и понятие Руны
В языке Go создатели изначально спроектировали тип string как неизменяемый срез байтов (immutable byte slice). Функция len() возвращает байты. Чтобы работать с символами, Go ввел концепцию rune (псевдоним для int32), представляющую кодовую точку:
package main
import (
"fmt"
"unicode/utf8"
)
func main() {
family := "👨👩👧👦"
// 1. Длина в байтах UTF-8
fmt.Println(len(family)) // 25
// 2. Длина в кодовых точках (рунах)
fmt.Println(utf8.RuneCountInString(family)) // 7
}
Для сегментации на графемы в Go используется модуль golang.org/x/exp/shiny/materialdesign/colornames или специализированный пакет github.com/rivo/uniseg.
4. Rust: абсолютная безопасность типов
Rust принципиально запрещает операцию индексации по строке s[0], потому что она неоднозначна. Тип &str гарантирует валидный UTF-8, но заставляет программиста явно выбирать, что именно он считает:
fn main() {
let family = "👨👩👧👦";
// 1. Количество байтов
println!("{}", family.len()); // 25
// 2. Количество кодовых точек (chars)
println!("{}", family.chars().count()); // 7
// 3. Графемные кластеры через крейт unicode-segmentation
// use unicode_segmentation::UnicodeSegmentation;
// println!("{}", family.graphemes(true).count()); // 1
}
Ловушка составных букв: почему «ё» не всегда «ё»
Думаешь, проблемы с графемными кластерами возникают только у фанатов эмодзи? Отнюдь!
Возьмем русскую букву «ё». В Unicode ее можно закодировать двумя способами:
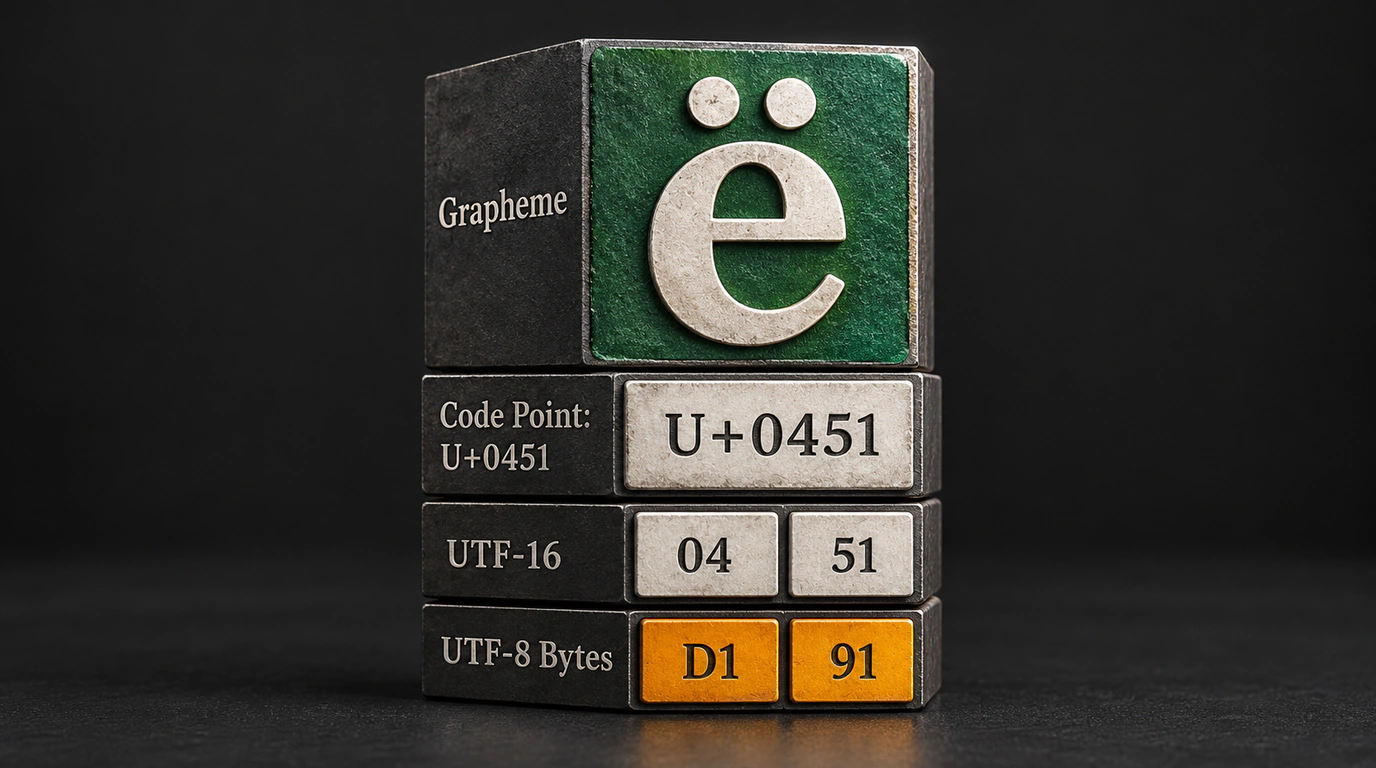
- Precomposed (NFC): единая кодовая точка
U+0451(CYRILLIC SMALL LETTER IO). Длина в JS:1. - Decomposed (NFD): базовая буква
«е»(U+0435) плюс комбинируемое диакритическое двоеточие сверху (U+0308,COMBINING DIAERESIS). Длина в JS:2!
На экране монитора обе буквы выглядят абсолютно одинаково: ё и ё. Но для базы данных или операции поиска строк это совершенно разные сущности! Если один пользователь ввел логин в форме NFC, а другой в NFD, сравнение user1 === user2 вернет false.
Поэтому золотое правило бэкенда при обработке пользовательского ввода: всегда нормализовать строки в каноническую форму NFC:
str.normalize("NFC") в JavaScript или unicodedata.normalize("NFC", s) в Python перед сохранением в базу данных.
Понимание того, как работают кодовые точки и графемы, спасает от самых коварных багов валидации и гарантирует, что интерфейс не развалится при встрече с реальным текстом.