

Каждый бэкенд-инженер рано или поздно упирается в одну и ту же фундаментальную стену: скорость коммита транзакций в базу данных. Твоё приложение может быть написано на сверхбыстром компилируемом языке, в кодовой базе могут отсутствовать лишние аллокации памяти, а сетевой стек может летать на eBPF. Но как только клиент отправляет команду COMMIT, программа вынуждена замереть и дождаться, пока байты физически осядут на энергонезависимом накопителе.
За эту гарантию сохранности данных (букву D в аббревиатуре ACID) отвечает классический журнал упреждающей записи — Write-Ahead Log, или WAL. И почти везде под капотом вызывается знакомый системный вызов fsync(2).
Но в эпоху облачных серверов этот вызов превращается в пытку. Если на локальном NVMe-накопителе сброс кэша занимает микросекунды, то на сетевом блочном томе вроде AWS EBS gp3 задержка каждого сетевого обращения к диску подскакивает до 1 миллисекунды. А теперь представь, что твоя база обрабатывает последовательный поток небольших транзакций: тысяча коммитов в секунду превращается в непреодолимый потолок просто из-за сетевых задержек дискового контроллера.
Именно с этой дилеммой столкнулись инженеры версионируемой реляционной СУБД Dolt под руководством Аарона Сона. Они решили оптимизировать журнал, но первое же очевидное решение обернулось поучительным уроком об устройстве файловых систем Linux.
Ловушка наивной оптимизации: fsync против fdatasync
Если открыть документацию ядра Linux по системным вызовам, различие между fsync(2) и fdatasync(2) выглядит предельно простым:
fsyncсбрасывает на накопитель как сами измененные страницы данных, так и все метаданные файла: время модификации (mtime), права доступа, размер и карту дисковых блоков (экстентов).fdatasyncобещает сбросить только страницы данных, игнорируя служебные атрибуты файла, если они не требуются для корректного последующего чтения.
Кажется, вот он — рецепт мгновенного ускорения! Метаданные журнала (например, время последнего изменения mtime) базе данных при коммите совершенно не нужны: если сервер аварийно перезагрузится, парсер WAL ориентируется на внутренние заголовки записей и контрольные суммы CRC, а не на системные таймстемпы файловой системы.
Инженеры Dolt взяли и заменили вызов fsync на fdatasync на пути записи каждого коммита. Запустили бенчмарки и... не увидели абсолютно никакой разницы. Задержка последовательных транзакций осталась ровно такой же высокой.
В чем же дело? Чтобы понять природу сбоя, нужно спуститься на уровень стандарта POSIX и драйверов файловых систем. По спецификации POSIX вызов fdatasync обязан гарантировать, что данные можно будет прочитать после сбоя питания. А теперь вспомни, как обычно пишется журнал: база данных открывает файл в режиме добавления и делает append, дописывая новые байты в самый конец.
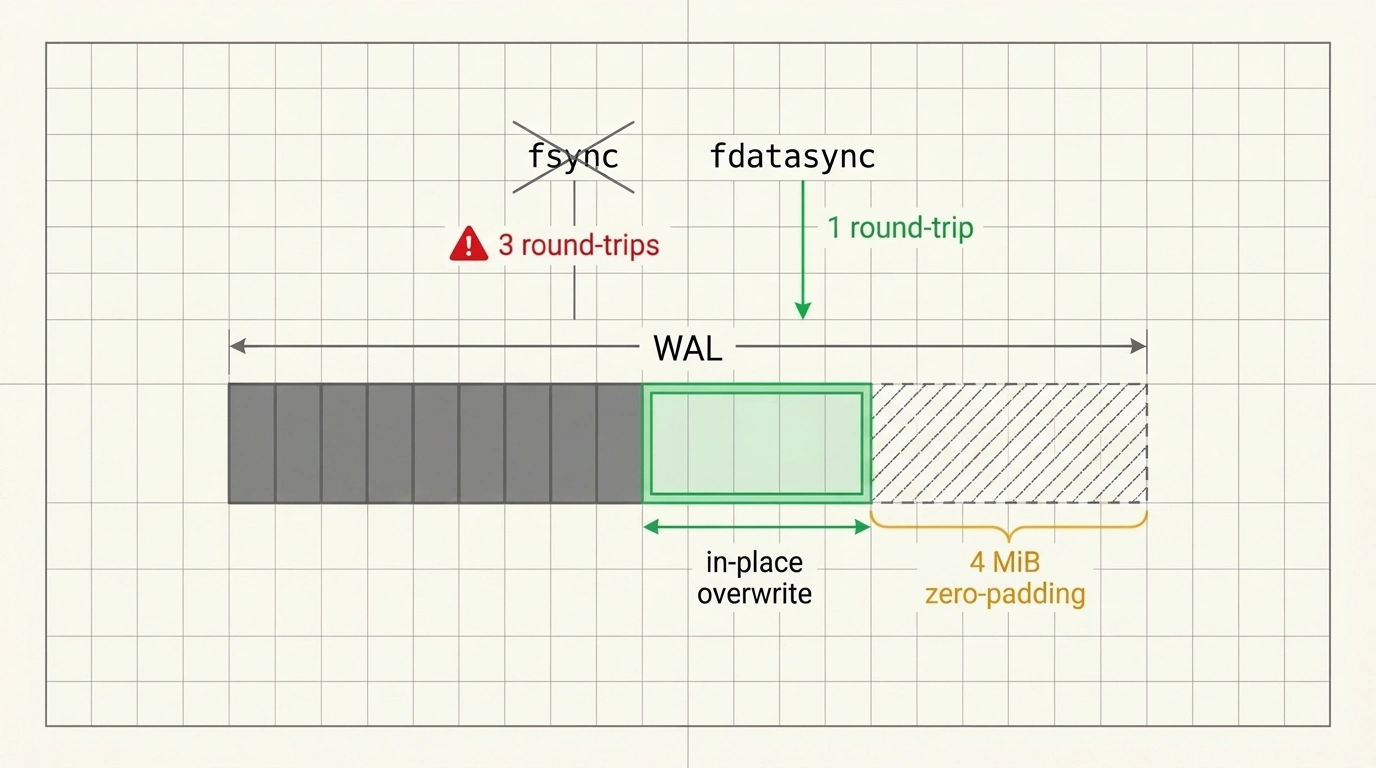
При каждом append размер файла (st_size) увеличивается! А размер файла — это критически важный атрибут метаданных. Если файловая система не зафиксирует новый размер файла в структуре inode, операционная система после перезагрузки просто посчитает дописанный кусок находящимся за пределами файла и вернет EOF. В итоге ядро Linux вынуждено запускать ровно ту же самую тяжелую процедуру сброса метаданных, что и при обычном fsync.
Анатомия дисковых раунд-трипов на Ext4
Давай заглянем под капот файловой системы Ext4 — самого популярного хранилища на серверах под управлением Linux.
Когда процесс делает запись в конец файла с последующим сбросом, драйвер Ext4 с подсистемой журналирования JBD2 (Journaling Block Device) выполняет три последовательных обращения к блочному накопителю:
- Запись данных: измененные страницы оперативной памяти отправляются на диск.
- Запись метаданных в журнал: драйвер блокирует структуры файла и записывает обновленный размер файла и новые дисковые экстенты в кольцевой буфер журнала Ext4.
- Коммит транзакции журнала: на накопитель отправляется аппаратный барьер сброса (flush barrier), гарантирующий, что метаданные зафиксированы.
На сетевом диске EBS каждый такой шаг — это отдельный сетевой раунд-трип на 1 миллисекунду. В итоге один простой коммит транзакции обходится приложению минимум в 3 миллисекунды задержки!
На файловой системе XFS ситуация выглядит чуть мягче: XFS умеет объединять запись метаданных и коммит, совершая два раунд-трипа вместо трех. Но два раунд-трипа — это всё равно в два раза дольше, чем передача одних только полезных данных.
Почему не сработали fallocate и ftruncate
Казалось бы, если проблема в изменении размера файла, давай выделим место заранее! Например, вызовем системный вызов fallocate(2) или ftruncate(2) на 100 мегабайт вперед. Тогда размер файла сразу станет большим, и последующие записи не будут его менять?
Инженеры Dolt проверили и эту гипотезу. Результат снова оказался обескураживающим: выигрыша не было.
Причина кроется в механизме безопасности ядра Linux. Когда ты вызываешь fallocate, файловая система выделяет дисковые блоки, но помечает их как неинициализированные экстенты (unwritten extents). Это сделано специально для того, чтобы одна программа не могла случайно прочитать остаточные чужие данные с диска до того, как сама туда что-то запишет.
Когда приложение впервые пишет реальные байты в неинициализированный блок, ядро Linux перехватывает операцию и обновляет дерево экстентов в inode, переводя блок из статуса «неинициализированный» в статус «валидный». А это опять модификация метаданных, снова требующая блокировки журнала Ext4 и сброса барьера на накопитель!
Контринтуитивное решение: предварительная заливка нулями
Единственный способ заставить файловую систему считать дисковые блоки полностью инициализированными — это физически записать в них данные.
Команда Dolt применила элегантную инженерную схему:
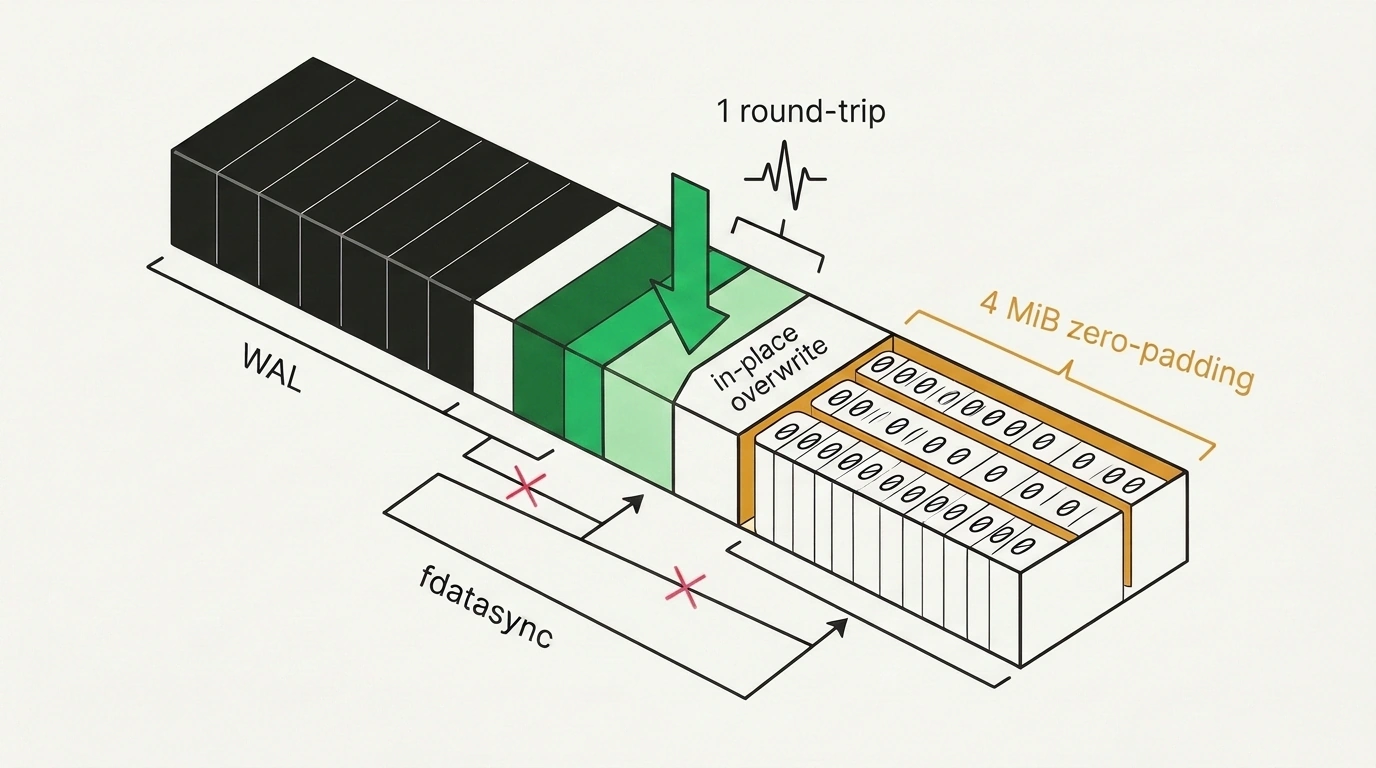
- База данных держит буфер размером 4 МиБ, заполненный нулями (
zero-padding). - Когда указатель записи приближается к границе ранее размеченного пространства, процесс делает обычный системный вызов
write(2), дописывая 4 МиБ нулей в конец файла. - Поскольку нули физически записаны на накопитель, файловая система создает полноценные, инициализированные экстенты.
- Все последующие тысячи мелких транзакций внутри этого 4-мегабайтного окна становятся не расширением файла (
append), а перезаписью существующих секторов (in-place overwrite)!
А при перезаписи уже выделенного блока размер файла не меняется, структура экстентов остается нетронутой, и системный вызов fdatasync наконец-то начинает работать так, как задумывалось: сбрасывает только измененные данные за ровно один сетевой раунд-трип!
Реализация на Go
Вот как эта логика выглядит на чистом Go с использованием прямого системного вызова syscall.Fdatasync:
package wal

import (
    "os"
    "syscall"
)

// Выделяем 4 МиБ буфер нулей для предварительной разметки файла
const zeroBlockSize = 4 * 1024 * 1024
var zeroBytes = make([]byte, zeroBlockSize)

type WALWriter struct {
    file          *os.File
    currentOffset int64
    allocatedEnd  int64
}

// WriteCommit атомарно фиксирует транзакцию в журнале упреждающей записи
func (w *WALWriter) WriteCommit(record []byte) error {
    recordLen := int64(len(record))

    // Если очередная транзакция упирается в границу инициализированных блоков
    if w.currentOffset+recordLen > w.allocatedEnd {
        // Расширяем файл, физически записывая 4 МиБ нулей
        if _, err := w.file.WriteAt(zeroBytes, w.currentOffset); err != nil {
            return err
        }
        w.allocatedEnd = w.currentOffset + zeroBlockSize
    }

    // Перезаписываем область нулей фактическими данными коммита (in-place overwrite)
    if _, err := w.file.WriteAt(record, w.currentOffset); err != nil {
        return err
    }
    w.currentOffset += recordLen

    // Системный вызов fdatasync сбрасывает только кэш данных без блокировок метаданных
    return syscall.Fdatasync(int(w.file.Fd()))
}
Для проверки поведения подсистемы ввода-вывода полезно запустить трассировку системных вызовов через утилиту strace в терминале:
# Мониторинг задержек системных вызовов fdatasync в реальном времени
strace -f -T -e trace=fdatasync,write -p $(pgrep dolt) 2>&1 | grep fdatasync
В выводе терминала отчетливо видно, как задержка вызова fdatasync падает с 3.2 мс до стабильных 0.9–1.1 мс на каждый коммит. В синтетических тестах Sysbench OLTP с короткими последовательными транзакциями общее время фиксации сократилось на 10–40%.
Эта оптимизация не является бесплатной магией. Предварительная запись 4 МиБ нулей удваивает физический объем данных, отправляемых на накопитель (Write Amplification возрастает примерно в 2 раза). Если твоя дисковая подсистема уже утилизирована на 100% по пропускной способности (MB/s) на локальном SSD, трюк с нулями только замедлит работу. Он раскрывает свой потенциал именно на сетевых хранилищах с высокой сетевой задержкой (RTT) и избыточным запасом по полосе пропускания.
Кроме того, фокус с перезаписью секторов теряет смысл на файловых системах с архитектурой Copy-on-Write (Btrfs, OpenZFS): там любая перезапись блока физически превращается в запись нового блока с обновлением дерева метаданных. Но для классических серверных инсталляций на Ext4 и XFS это один из самых красивых и неочевидных способов обойти дисковые просадки.