
Представь типичную рабочую задачу инженера по инфраструктуре или специалиста по облачной безопасности. В компании работают десятки микросервисов, развернутых в трех регионах AWS, пара вспомогательных кластеров крутится в Google Cloud, а внутри офиса развернут production-кластер Kubernetes.
И тут поступает распоряжение: «Проверьте, нет ли у нас случайно открытых на весь мир S3-бакетов, незашифрованных дисков EBS и неймспейсов Kubernetes, где забыли включить сетевую изоляцию NetworkPolicy».
Что делает инженер в обычной ситуации?
Он садится писать простыню кода на Python с использованием библиотеки boto3. Там начинается рутина: сначала нужно перебрать список всех аккаунтов, затем зайти в каждый регион, справиться с постраничной пагинацией токенов (NextToken), распарсить гигантские вложенные структуры JSON, отловить сетевые таймауты и как-то сопоставить полученные идентификаторы с подами из вывода kubectl get pods -o json. Через два дня работы у тебя на руках скрипт на 500 строк, который падает с ошибкой при первой же смене формата ответа в API.
Проект с открытым исходным кодом Steampipe от компании Turbot предлагает взглянуть на эту проблему под совершенно другим углом. Авторы задались простым вопросом: если реляционные базы данных уже полвека идеально справляются с фильтрацией, сортировкой и объединением разнородных сущностей, почему бы не применить этот мощный математический аппарат к облачной инфраструктуре?
Как Steampipe устроен под капотом
Steampipe — это не просто обертка над CLI-командами. Это полноценный распределенный движок SQL-запросов к реальному миру API.
Архитектура системы строится на трех ключевых компонентах:
- Встроенный экземпляр PostgreSQL: при установке утилита создает легковесный изолированный процесс PostgreSQL в домашней директории пользователя (
~/.steampipe). Тебе не нужно поднимать отдельный сервер баз данных — всё работает локально и автономно. - Плагины Foreign Data Wrapper (FDW): Steampipe опирается на официальный механизм внешних таблиц PostgreSQL. Разработчики плагинов на языке Go описывают схемы таблиц (например,
aws_s3_bucket,aws_ec2_instance,kubernetes_pod). - Трансляция предикатов на лету (Predicate Pushdown): когда ты пишешь SQL-запрос с блоком
WHERE, планировщик запросов Steampipe не выкачивает терабайты данных целиком. Он транслирует условия фильтрации напрямую в аргументы вызовов удаленных API провайдеров. Например, если в запросе указаноWHERE region = 'eu-central-1', плагин отправит запрос только в конкретный регион Франкфурта.
Полученные из облака JSON-ответы на лету маппятся в строки и колонки реляционных таблиц. Для тебя как разработчика облако начинает выглядеть как гигантская, идеально структурированная база данных.
Магия межоблачных JOIN-ов
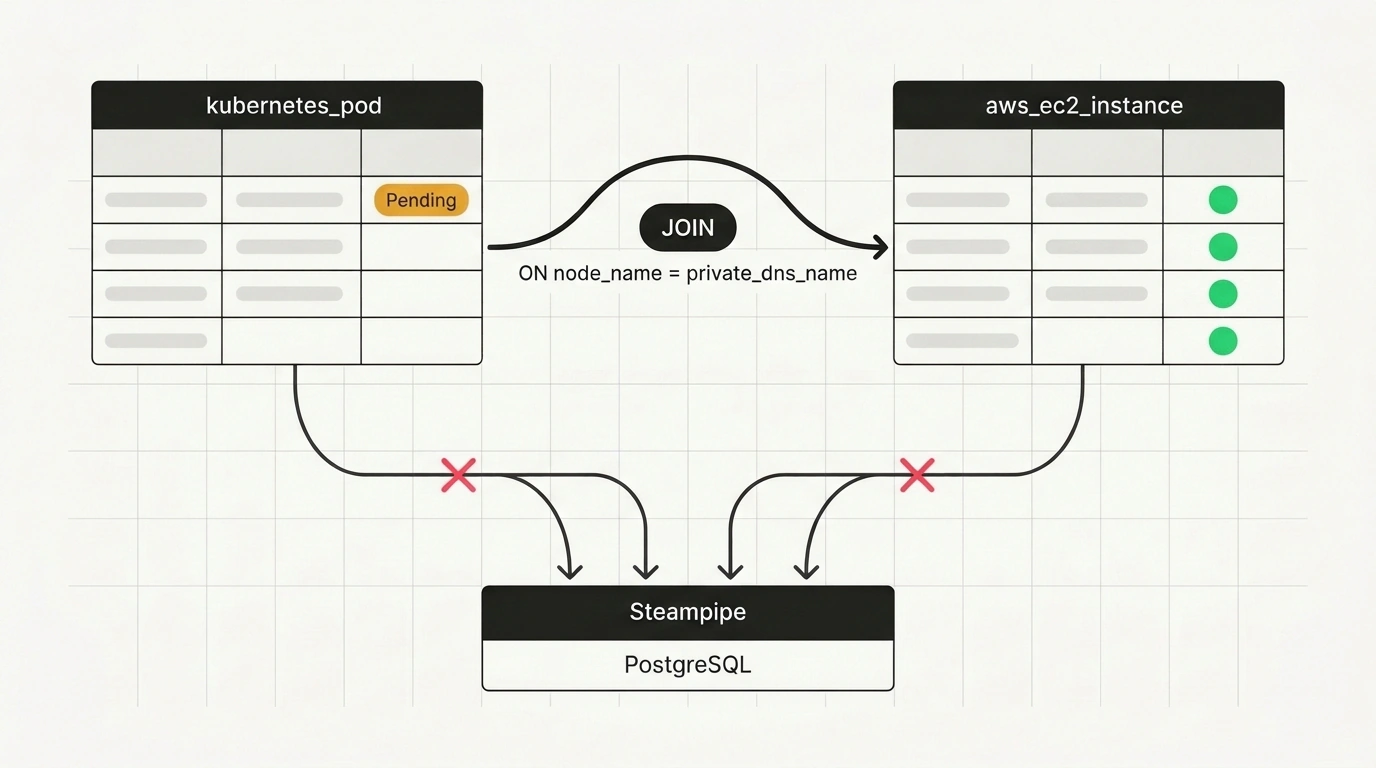
Главная суперсила реляционной модели — это операция объединения JOIN. В обычных скриптах связать сущности из разных платформ невероятно сложно. В Steampipe ты можешь объединить таблицу подов Kubernetes с таблицей инстансов AWS EC2 в одном запросе, чтобы мгновенно увидеть, на каких физических виртуальных машинах запущены поды с критическими ошибками:
SELECT
  k8s.name AS pod_name,
  k8s.namespace,
  k8s.node_name,
  ec2.instance_id,
  ec2.instance_type,
  ec2.public_ip_address
FROM
  kubernetes_pod AS k8s
JOIN
  aws_ec2_instance AS ec2 ON k8s.node_name = ec2.private_dns_name
WHERE
  k8s.status_phase = 'Pending';
Движок сам выполнит параллельные запросы к API Kubernetes и API AWS, сопоставит DNS-имена узлов и выдаст аккуратную сводную таблицу в терминале за пару секунд!
Установка и первые практические запросы
Развертывание Steampipe занимает меньше двух минут. Утилита ставится стандартным скриптом на Linux или через Homebrew на macOS:
# Установка для Linux окружений
sudo /bin/sh -c "$(curl -fsSL https://steampipe.io/install/steampipe.sh)"

# Установка через Homebrew для macOS
brew install turbot/tap/steampipe

# Проверяем успешную установку
steampipe -v
После установки подключаем необходимые плагины из официального каталога Steampipe Hub. Плагины автоматически используют твои стандартные локальные конфиги аутентификации (~/.aws/credentials, ~/.kube/config):
steampipe plugin install aws
steampipe plugin install kubernetes
Теперь запустим интерактивную SQL-консоль командой steampipe query и решим наши задачи безопасности.
1. Поиск публично доступных S3-бакетов
Проверим все бакеты в аккаунте на наличие отключенной публичной блокировки:
SELECT
  name,
  region,
  block_public_acls,
  block_public_policy,
  restrict_public_buckets
FROM
  aws_s3_bucket
WHERE
  block_public_policy = false
  OR block_public_acls = false;
Один короткий запрос мгновенно подсвечивает бакеты, через которые может произойти утечка конфиденциальных данных компании.
2. Аудит изоляции пространств имен Kubernetes
Найдем в кластере неймспейсы, в которых не создано ни одного правила сетевой фильтрации NetworkPolicy (а значит, трафик между подами открыт настежь):
SELECT
  n.name AS namespace_name
FROM
  kubernetes_namespace AS n
LEFT JOIN
  kubernetes_network_policy AS np ON n.name = np.namespace
WHERE
  np.name IS NULL
  AND n.name NOT IN ('kube-system', 'kube-public', 'kube-node-lease');
Классический LEFT JOIN с проверкой на NULL мгновенно выдает список неприкрытых рабочих сред разработчиков.
Подводные камни: Rate Limiting и троттлинг API
Работая со Steampipe, важно помнить об аппаратных ограничениях облачных провайдеров.
Если ты выполнишь наивный запрос вроде SELECT * FROM aws_ec2_instance в организации с сотнями подключенных AWS-аккаунтов, утилита начнет бомбардировать API провайдера сотнями параллельных вызовов. Рано или поздно сработает лимит облака, и ты получишь ошибку RateExceeded / RequestLimitExceeded.
Чтобы избежать троттлинга:
- Всегда ограничивай область поиска условиями
WHERE region = '...'илиWHERE account_id = '...'; - Используй встроенный в Steampipe кэш запросов (параметр
cache = onв конфигурационном файле плагина); - Для регулярных сканирований в CI/CD настраивай параметр задержки между вызовами API (
max_concurrency).
Steampipe доказывает, что хорошая архитектурная абстракция способна сэкономить сотни часов рутинного труда. Превращение инфраструктуры в таблицы возвращает инженерам радость простых и элегантных решений.