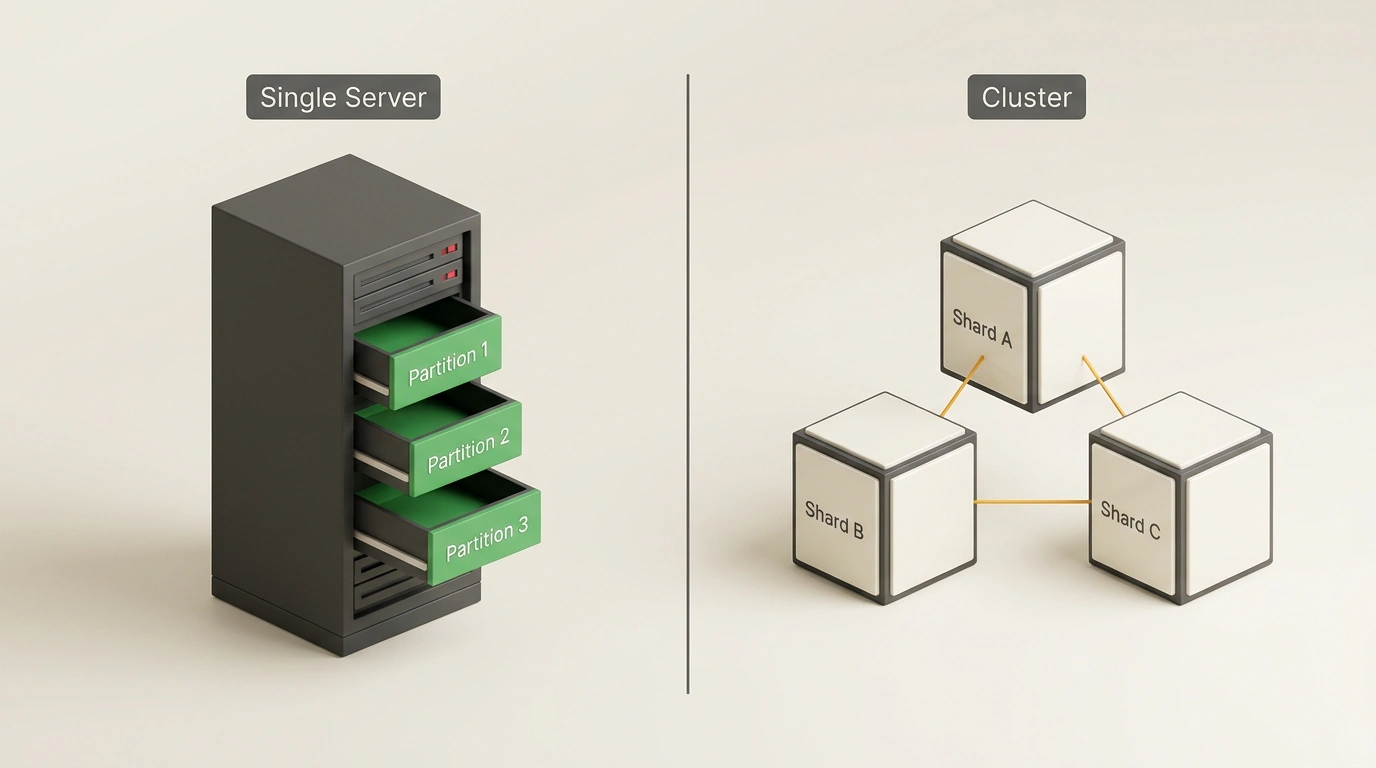

Рано или поздно каждый успешный проект сталкивается с кризисом роста данных. Твой стартап или сервис запускался на простом одиночном сервере PostgreSQL или MySQL, таблица заказов или логов аудита спокойно вмещала первые несколько сотен тысяч записей, а запросы отрабатывали за пару миллисекунд.
Но проходят месяцы активной работы: таблица разрастается до ста миллионов строк, размер файла на диске переваливает за сотни гигабайт, а пользователи начинают жаловаться на подвисания аналитических отчетов. На архитектурном комитете неизбежно звучат два популярных термина: «Давайте сделаем партиционирование!» или «Нам срочно нужен шардинг!».
В инженерных спорах эти понятия нередко смешивают в одну кучу, считая их чуть ли не синонимами. Но между ними пролегает фундаментальная граница — граница физического железа. Принятие неправильного решения на этом этапе способно либо похоронить производительность базы данных, либо обречь команду на месяцы сложнейшей и неоправданной переделки архитектуры.
Давай разберем эту развилку до основания и на пальцах определим, где проходит водораздел между партиционированием и шардингом.
Физическая граница: один сервер против кластера
Главное различие кроется не в SQL-синтаксисе, а в том, как распределяются физические аппаратные ресурсы — процессор (CPU), оперативная память (RAM) и дисковая подсистема:
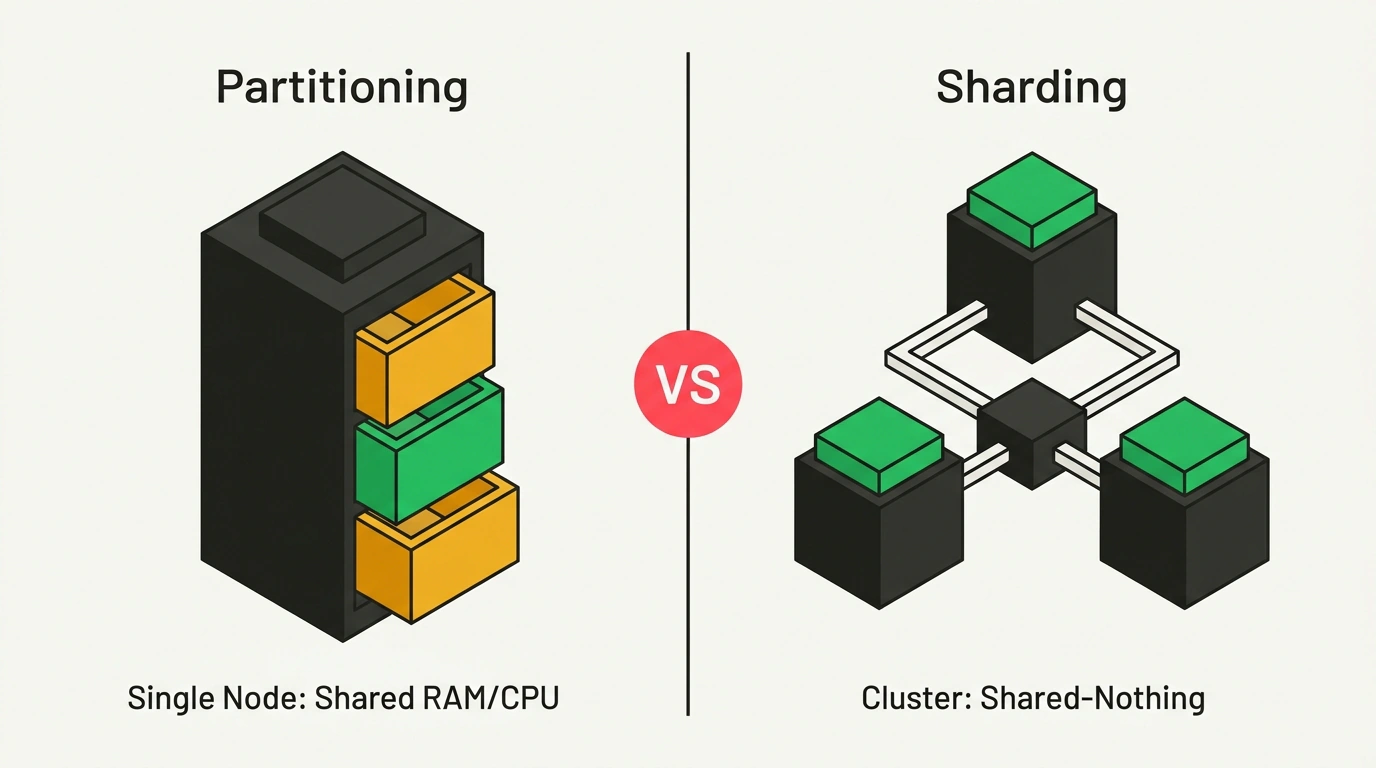
- Партиционирование (Partitioning, или секционирование) — это разделение одной логической таблицы на несколько физических подтаблиц (секций) внутри одного-единственного экземпляра СУБД на одном сервере. Все секции живут в одном пространстве памяти и конкурируют за одни и те же вычислительные ядра и дисковые накопители.
- Шардинг (Sharding) — это распределение набора данных между несколькими независимыми физическими серверами (узлами кластера). Каждый шард представляет собой самостоятельную базу данных со своей собственной памятью, дисками и операционной системой (архитектура Shared-Nothing).
Почувствуй разницу: партиционирование помогает операционной системе и планировщику СУБД эффективнее работать с локальными файлами на одном хосте, тогда как шардинг масштабирует систему за пределы физических ограничений одного сервера.
Секционирование: три главные проблемы, которые оно решает
Почему же партиционирование настолько популярно, если все данные всё равно остаются на одном сервере? Дело в том, что секционирование идеально устраняет три главные боли растущих монолитных баз данных:
1. Спасение оперативной памяти от раздувания индексов
Пока таблица помещается в RAM, поиск по B-Tree индексу занимает наносекунды. Но когда размер индекса переваливает за объем оперативной памяти сервера, начинается деградация: для поиска каждой записи СУБД вынуждена вытеснять горячие страницы кэша и обращаться к медленному диску. Если ты разбиваешь таблицу на месячные секции, активный рабочий набор (текущий месяц) уменьшается в разы. Индекс текущего месяца спокойно живет в оперативной памяти, а дисковый I/O падает почти до нуля.
2. Механизм Partition Pruning (отсечение секций)
Когда ты выполняешь запрос с условием фильтрации по ключу партиционирования (например, по диапазону дат), планировщик СУБД на этапе построения плана исключает из сканирования все нерелевантные секции. База физически даже не открывает файлы других месяцев!
3. Мгновенная очистка старых данных без VACUUM
Это главный секрет эксплуатации Highload-баз данных. Представь, что тебе нужно удалить из таблицы заказов данные двухлетней давности. Если ты выполнишь команду DELETE FROM orders WHERE order_date < '2024-01-01';, база данных зависнет на часы: она начнет построчно помечать миллионы записей как мертвые, сгенерирует гигабайты журналов WAL, заблокирует таблицы и вызовет чудовищное раздувание (bloat), после чего процесс VACUUM будет сутки пытаться вернуть место операционной системе.
При партиционировании удаление целого месяца выполняется одной мгновенной DDL-командой: DROP TABLE orders_2024_01;. База просто удаляет файл с диска на уровне файловой системы за пару миллисекунд без единой строчки WAL-журнала и без участия сборщика мусора!
Практика: настраиваем партиционирование в PostgreSQL
Посмотрим, как выглядит декларативное секционирование в современном PostgreSQL:
-- Создаем мастер-таблицу с декларативным секционированием по диапазону дат
CREATE TABLE orders (
    order_id bigint NOT NULL,
    customer_id bigint NOT NULL,
    order_date date NOT NULL,
    total_amount numeric(12, 2) NOT NULL,
    status text NOT NULL,
    -- Важное требование: колонка ключа секционирования обязана входить в первичный ключ
    PRIMARY KEY (order_id, order_date)
) PARTITION BY RANGE (order_date);

-- Создаем физические секции под конкретные месяцы
CREATE TABLE orders_2026_10 PARTITION OF orders
    FOR VALUES FROM ('2026-10-01') TO ('2026-11-01');

CREATE TABLE orders_2026_11 PARTITION OF orders
    FOR VALUES FROM ('2026-11-01') TO ('2026-12-01');

-- Локальные индексы создаются на каждой секции автоматически или индивидуально
CREATE INDEX idx_orders_2026_10_customer ON orders_2026_10 (customer_id);
Теперь проверим, как работает отсечение секций через EXPLAIN:
EXPLAIN SELECT * FROM orders
WHERE order_date >= '2026-10-15' AND order_date <= '2026-10-20';

-- Результат в выводе EXPLAIN:
-- Seq Scan on orders_2026_10 orders (cost=0.00..25.40 rows=12 width=48)
--   Filter: ((order_date >= '2026-10-15'::date) AND (order_date <= '2026-10-20'::date))
-- Заметь: планировщик даже не упомянул секцию orders_2026_11!
Когда партиционирования мало: приход шардинга
Партиционирование творит чудеса, но у него есть жесткий предел. Рано или поздно наступает момент, когда мощности одного сервера физически заканчиваются:
- Узкое горлышко записи (Write Bottleneck): репликация со слейвами (Read Replicas) легко масштабирует запросы на чтение, но все операции записи (
INSERT,UPDATE) обязаны проходить через единственный master-сервер. Если входящий поток транзакций исчерпал предельные IOPS дискового массива или пропускную способность шины процессора, одиночный сервер больше не справится. - Физический объем дисков: объем данных переваливает за десятки терабайт и больше не влезает в разумные дисковые полки одного сервера.
Вот здесь на сцену выходит шардинг. Ты нарезаешь данные по ключу (например, по хэшу user_id) и раскладываешь их по десяти разным независимым серверам. Каждый узел пишет только свою десятую часть данных.
Шардинг решает проблему масштабирования записи, но требует колоссальной платы за сложность:
- Потеря целостности: ты больше не можешь объявить нативный
FOREIGN KEYмежду таблицами, лежащими на разных шардах. - Распределенные транзакции: атомарный перевод денег между пользователями с разных шардов требует двухфазного коммита (2PC), который работает мучительно медленно и часто ломается при сбоях сети.
- Необходимость координатора: приложению требуется специальная прослойка (вроде Citus или Vitess), которая будет понимать, на какой именно сервер направить входящий запрос.
Золотое правило выбора: от простого к сложному
Прежде чем бросаться внедрять шардинг и тратить месяцы на переписывание бизнес-логики:
- Выжми максимум из индексов, оптимизации запросов и вертикального масштабирования (современные серверы с 128 ядрами и терабайтом RAM стоят в разы дешевле зарплаты команды, поддерживающей шардированный кластер).
- Настрой партиционирование для самых крупных таблиц по времени или статусам. Это решит 90% проблем с дисковым вводом-выводом и обслуживанием кэша.
- И только тогда, когда поток транзакций записи упрется в физический потолок одного мощного сервера, переходи к шардингу.
А в зрелых высоконагруженных системах оба подхода органично объединяются: таблицы на каждом отдельном шарде точно так же секционируются по месяцам.