
Жизнь современного инженера эксплуатации в мире Kubernetes состоит из постоянного поиска компромиссов. С одной стороны, разработчики и администраторы хотят удобных инструментов для быстрой инспекции ресурсов кластера без необходимости наизусть помнить десятки параметров и jsonpath-выражений утилиты kubectl. С другой стороны, бизнес и FinOps-команды требуют максимальной экономии облачных бюджетов — например, перевода сервисов на дешевые спотовые виртуальные машины (Spot Instances) и безжалостной консолидации свободных нод.
Сегодня мы разберем два свежих открытых проекта, которые элегантно закрывают обе эти потребности: легковесную десктопную панель управления и оператор защиты одиночных подов при ротации узлов.
PigeonEye
Если ты искал графический интерфейс для управления кластером Kubernetes, то наверняка сталкивался со стандартной дилеммой:
- с одной стороны есть отличная консольная утилита
k9s, но в терминале трудно воспринимать сложные многостраничные связи между ресурсами; - с другой стороны существуют десктопные гиганты вроде Lens, которые написаны на Electron, запускаются по полминуты и пожирают гигабайты оперативной памяти просто в режиме ожидания.
Проект PigeonEye от разработчика с ником tackish предлагает долгожданный третий путь. Это нативное десктопное приложение, построенное на связке Rust, Tauri и React. Оно весит считанные мегабайты, запускается за доли секунды и потребляет минимальный объем системных ресурсов.
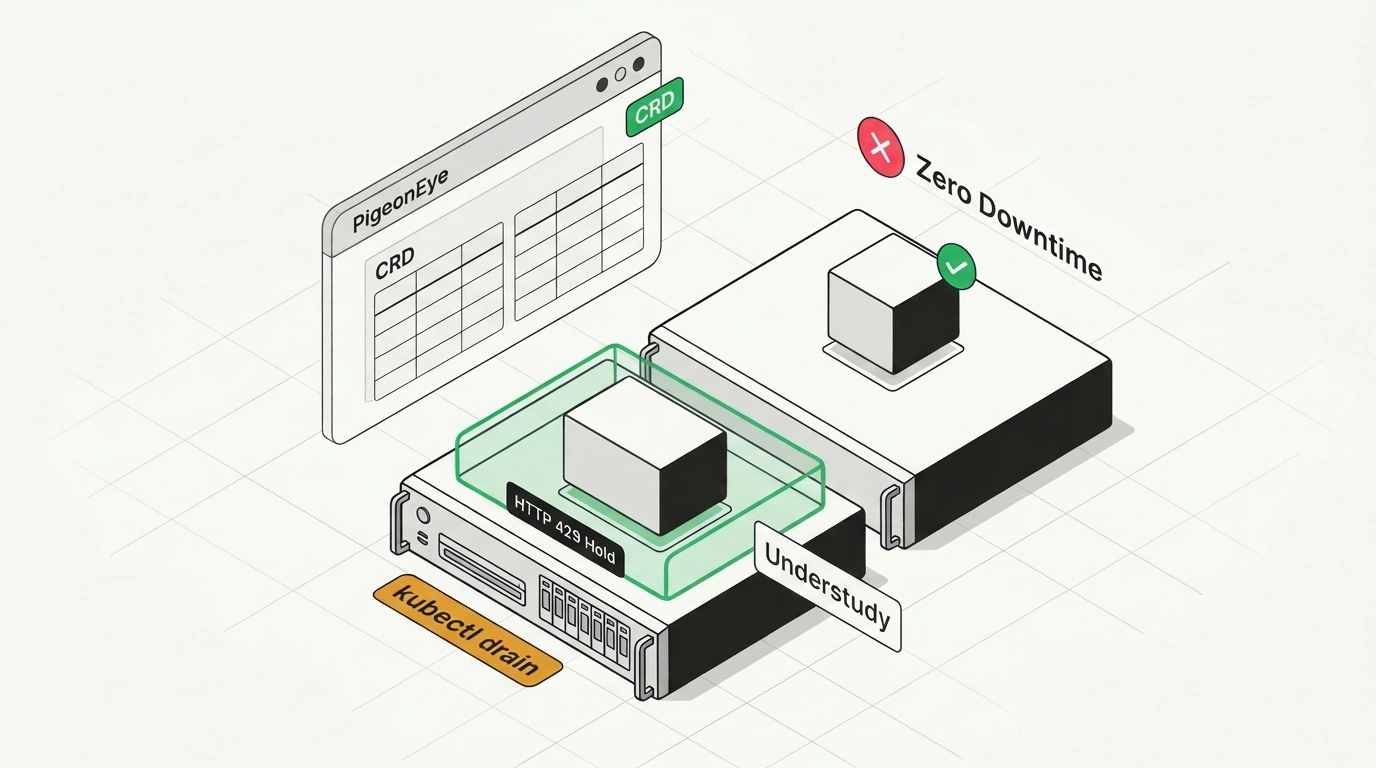
Главная киллер-фича PigeonEye — интеллектуальное автообнаружение любых пользовательских ресурсов (Custom Resource Definitions, CRD). Когда ты устанавливаешь в кластер операторы баз данных, сертификатов или сервисных сетей (Cert-Manager, Istio, Prometheus), PigeonEye динамически опрашивает API-сервер кластера и на лету генерирует интерфейсные таблицы. Причем колонки отображаются в точности так, как их задумали авторы оператора в манифестах additionalPrinterColumns — ровно то, что ты привык видеть в выводе команды kubectl get.
Understudy
Второй проект решает классическую головную боль сопровождения ворклоадов: проблему одиночных подов (single-replica workloads).
В любом кластере есть сервисы, которые принципиально не могут работать в двух экземплярах одновременно. Это могут быть фоновые воркеры с монопольной блокировкой очередей, специализированные контроллеры, коннекторы или тестовые среды.
Что происходит, когда облачный автоскейлер (например, Karpenter) решает оптимизировать расходы и выселить ноду (kubectl drain), либо AWS присылает уведомление об отзыве Spot-инстанса?
Кластер принудительно убивает твой единственный под. Пока создается и прогревается новая виртуальная машина, пока под скачивает образ и проходит проверки readiness probe, сервис лежит в даунтайме от 1 до 3 минут. Держать постоянную вторую реплику «на всякий случай» бизнес не хочет — это банально удваивает счет за серверы (FinOps-оверхед).
Оператор Understudy от команды mitis-cloud решает эту проблему по принципу театрального дублера (откуда и название):
- Когда на ноду поступает команда дренажа, оператор перехватывает событие выселения пода через Admission Webhook и отвечает кодом
HTTP 429 Too Many Requests, блокируя удаление ноды. - В этот же момент Understudy мгновенно поднимает временный дублирующий под на другой, стабильной ноде кластера.
- Оператор терпеливо дожидается, пока новый под полностью пройдет проверки
readiness probeи начнет принимать трафик. - Только после этого Understudy разрешает выселение и удаление оригинального пода.
Вторая реплика существует всего 60–120 секунд в момент ротации сервера! Ты получаешь нулевой даунтайм одиночного сервиса без переплаты за постоянный двойной запас ресурсов.
Настройка защиты для приложения описывается лаконичным манифестом CustomResource:
apiVersion: apps.understudy.sh/v1alpha1
kind: Understudy
metadata:
  name: billing-queue-worker-guard
  namespace: production
spec:
  targetRef:
    kind: Deployment
    name: billing-queue-worker
  # Режим always удерживает процесс дренажа до полной готовности дублера
  holdMode: always
  # Минимальное время на прогрев сервиса перед переключением (в секундах)
  minSurgeTimeSeconds: 60
  # Максимальный дедлайн ожидания готовности нового пода
  readinessDeadlineSeconds: 600
Установка оператора в кластер выполняется одной командой через Helm:
helm install understudy oci://ghcr.io/kylan11/charts/understudy \
  --namespace understudy-system \
  --create-namespace
Помни об архитектурных ограничениях: Understudy идеален для плановых событий (дренаж нод, консолидация спотовых инстансов, накатка обновлений ядра Linux на узлы). Но он не спасет тебя от внезапной физической смерти «железа» (unannounced hardware crash) — в таких авариях защитить сервис может только полноценная распределенная репликация.
Оба проекта показывают, что экосистема инструментов Kubernetes продолжает развиваться в сторону легковесности, здравого смысла и снижения эксплуатационных расходов.