
Анонс любой новой крупной языковой модели в индустрии ИИ мгновенно поляризует сообщество. Одни комментаторы сразу цитируют победные маркетинговые графики создателей, объявляя о победе над человеком, а другие выкапывают один неудачный промпт с олимпиадной логической загадкой и заявляют, что перед нами очередной мыльный пузырь.
Ровно это произошло с недавним релизом флагманской модели Kimi 3.1 (Kimi K3.1 Pro) от шанхайской лаборатории Moonshot AI. В социальных сетях разгорелась настоящая словесная баталия: часть инженеров раскритиковала модель за относительно дорогую стоимость токенов на инференсе и не самые выдающиеся результаты на задачах автоматического исправления багов (bug fixing), в то время как другие обозреватели восторгались качеством верстки интерфейсов и агентным поведением в терминале.
Технический лидер и автор канала System Design & Highload Алексей Рыбак предложил разобрать этот релиз трезво — без эмоций и рекламы. Давай вместе разберём, что на самом деле произошло под капотом Kimi 3.1, почему одномерные тесты больше не работают и какой тектонический сдвиг наметился в открытых нейросетевых моделях.
Ловушка одномерных тестов: три роли в реальной разработке
Главная методологическая ошибка большинства любительских тестов — попытка оценить сложнейшую модель через одну числовую шкалу вроде HumanEval или решения математических задач GSM8k.
В реальной инженерной практике, когда мы встраиваем автономных ИИ-агентов в процесс разработки (AI Software Development Life Cycle), нейросеть никогда не действует как сферический алгоритмист в вакууме. Она выполняет принципиально разные функциональные роли, и требования к каждой роли диаметрально противоположны:
- Роль продуктового инженера (Product Discovery): здесь от модели требуется аналитическое мышление, умение распутывать противоречивые требования в техническом задании, формулировать граничные случаи и разбивать эпики на проверяемые пользовательские истории.
- Роль дизайнера интерфейсов (UI/UX): здесь важна эстетика, понимание пространственной сетки, адаптивности, типографики и современных дизайн-систем.
- Роль системного инженера / пайплайн-разработчика: здесь требуются абсолютная точность синтаксиса, интеграция с REST/gRPC API, генерация миграций баз данных, управление окружением и написание сценариев для CI/CD.
И вот здесь Kimi 3.1 преподнесла главный сюрприз. В слепых пользовательских голосованиях на арене дизайна (LMSYS Design Arena) Kimi 3.1 стала первой открытой азиатской моделью, чьи сгенерированные интерфейсы пользователи стабильно выбирают наравне с закрытыми проприетарными версиями Claude от Anthropic. В отличие от стандартных бенчмарков, к которым модели можно целенаправленно «подогнать» (overfitting на датасет), слепую оценку живых дизайнеров и верстальщиков обмануть невозможно.
Что показали строгие независимые бенчмарки Artificial Analysis
Чтобы отсечь субъективизм, обратимся к замерам исследовательской платформы Artificial Analysis, протестировавшей Kimi K3.1 Pro по стандартизированным батареям тестов:
- Глобальный индекс интеллекта (Intelligence Index): модель набрала 55.1 балла, уверенно заняв 4-е место в мире среди более чем 200 коммерческих и открытых сеток, расположившись вплотную за Claude Opus и Claude Sonnet.
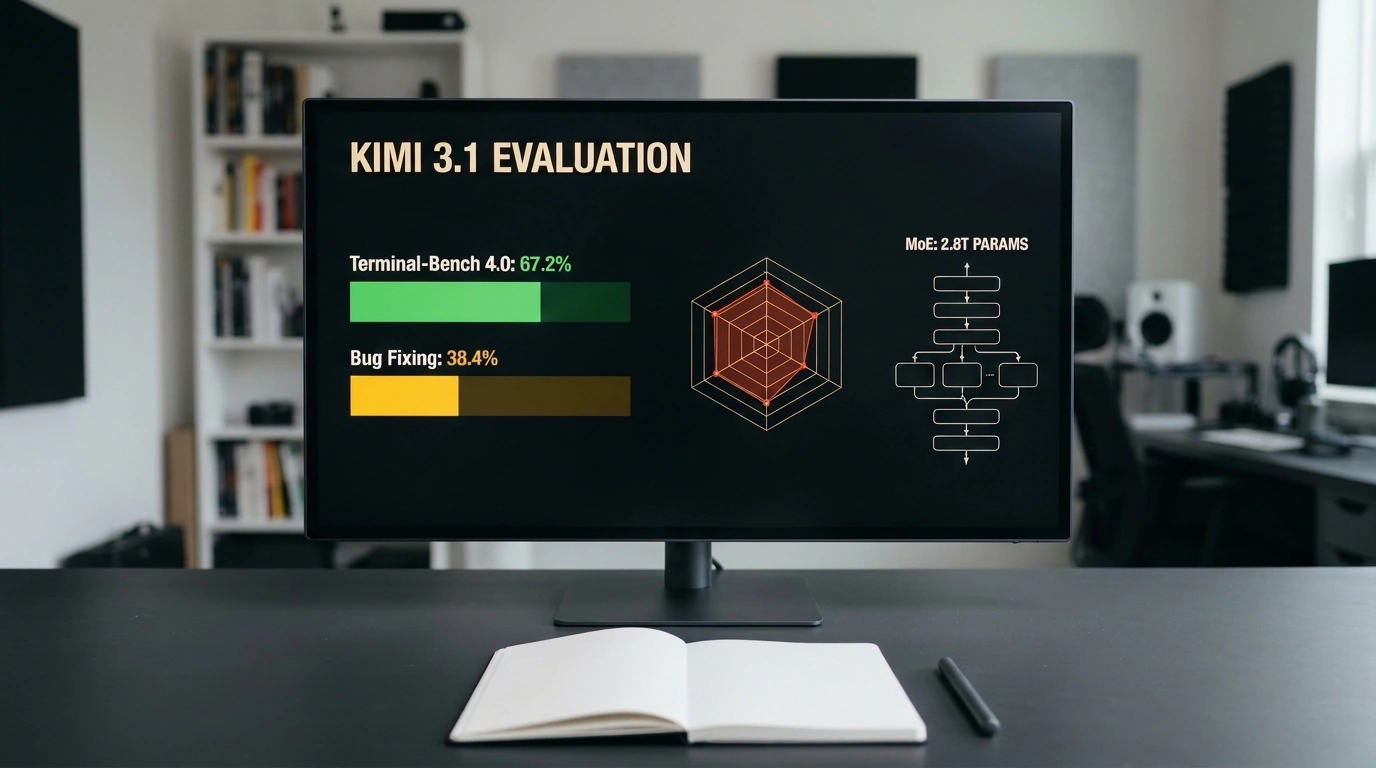
- Работа в терминале (Terminal-Bench 4.0): вот он, главный прорыв релиза. На задачах управления реальной операционной системой через консоль, выполнения цепочек Bash-команд, развёртывания пакетов и запуска тестов Kimi 3.1 показала рекордные 67.2% успешных выполнений. Для сравнения: предыдущее поколение Kimi K3 показывало на этом тесте всего 12.6%!
- Комплексные длинные сценарии (AutomationBench и GDPval-AA): в сложных агентных рабочих процессах модель заработала 1846 пунктов рейтинга Elo (чистый прирост +312 Elo к прошлой версии), продемонстрировав высокую устойчивость инструкций на длинной дистанции.
- Академические олимпиады: в тесте сверхсложных академических задач Humanity's Last Exam результат подрос скромнее: с 47% до 52%. Именно эта умеренная динамика породила разочарование тех исследователей, которые ждали чуда в олимпиадной математике.
Архитектура: 2.8 триллиона параметров и 1 миллион контекста
За этими цифрами стоит фундаментальная архитектурная работа. Kimi K3.1 Pro построена по схеме Mixture-of-Experts (MoE) с разреженной активацией:
- Общий объём весов: гигантские 2.8 триллиона параметров.
- Активные параметры на токен: 104 миллиарда параметров. Это даёт колоссальную эрудицию модели без запредельного замедления генерации каждого отдельного токена.
- Контекстное окно: 1 000 000 токенов с честной плотностью извлечения данных без «слепоты в середине» (эффект Needle in a Haystack).
Но главное событие — это политика распространения. Лаборатория Moonshot заявила о намерении открыть веса модели для сообщества. Это переводит Kimi 3.1 в статус самой мощной открытой модели на планете. Если тебя интересует развитие линейки этих нейросетей, посмотри наш предыдущий детальный разбор Kimi K3 с его архитектурными нюансами.
Главный тектонический сдвиг: схлопывание дистанции
Алексей Рыбак справедливо обращает внимание на глобальный рыночный тренд: дистанция между закрытыми американскими технологическими гигантами и догоняющими мировыми лабораториями стремительно схлопывается.
Мы наблюдаем классическую спираль развития опенсорса:
- Сначала появляется закрытый дорогой монополист с ежемесячной подпиской.
- Затем открытые модели выравниваются по базовому качеству, сокращая разрыв до статистической погрешности.
- На третьем шаге оптимизируются методы квантования, и компании получают возможность разворачивать веса сравнимого качества на собственных серверах и рабочих станциях (on-premise), полностью закрывая вопросы безопасности данных и санкционных рисков.
Kimi 3.1 — это наглядное подтверждение того, что эра монополии двух-трёх закрытых вендоров в корпоративной разработке окончательно подходит к концу.