
Среди начинающих разработчиков ходит стойкое заблуждение: если база данных тормозит, нужно просто создать индекс на каждое поле из условия WHERE, и всё волшебным образом залетает.
Я часто вижу в проектах таблицы, где на 15 колонок навешано 10–12 отдельных индексов. Внешне всё красиво: SELECT находит строку за доли миллисекунды. Но в продакшене система начинает задыхаться, дисковые накопители забиваются операциями ввода-вывода, транзакции ловят задержки, а репликация отстаёт на десятки секунд.
В чём подвох? Индексы не ускоряют базу в абсолютном смысле. Индекс — это вспомогательная структура, ускоряющая чтение ценой гарантированного налога на любую операцию записи (INSERT, UPDATE, DELETE).
Анатомия B-Tree: что прячется внутри 8-килобайтных страниц
В реляционных СУБД (PostgreSQL, MySQL/InnoDB) стандартом является сбалансированное дерево B-Tree в документации PostgreSQL, реализованное по алгоритму Lehman & Yao.
Дерево хранится на диске в виде фиксированных страниц памяти по 8 килобайт каждая. Структура состоит из трёх слоев:
- Корневой узел (Root page): точка входа для поиска.
- Промежуточные узлы (Internal pages): маршрутизаторы с ключами-разделителями и указателями на страницы следующего уровня.
- Листовые узлы (Leaf pages): нижний уровень, где хранятся отсортированные пары:
значение_ключаи идентификатор кортежаTID(Tuple ID — номер страницы таблицы и смещение строки). Все листовые страницы связаны двусвязным списком, что обеспечивает быстрый обход диапазонов (BETWEEN,>,<).
Поиск строки в B-Tree происходит со сложностью O(log n): вместо последовательного сканирования всей таблицы оптимизатор считывает всего 3–4 страницы дерева.
Что происходит под капотом при INSERT: сплиты страниц и лавина WAL
А теперь представь таблицу, на которой создано 8 индексов. Когда приложение выполняет обычный INSERT:
- СУБД записывает строку в таблицу.
- Затем база обязана спуститься от корня к листу во всех 8 индексах по очереди!
- На каждый индекс захватывается эксклюзивная блокировка (exclusive lock), и значение вставляется в отсортированном порядке.
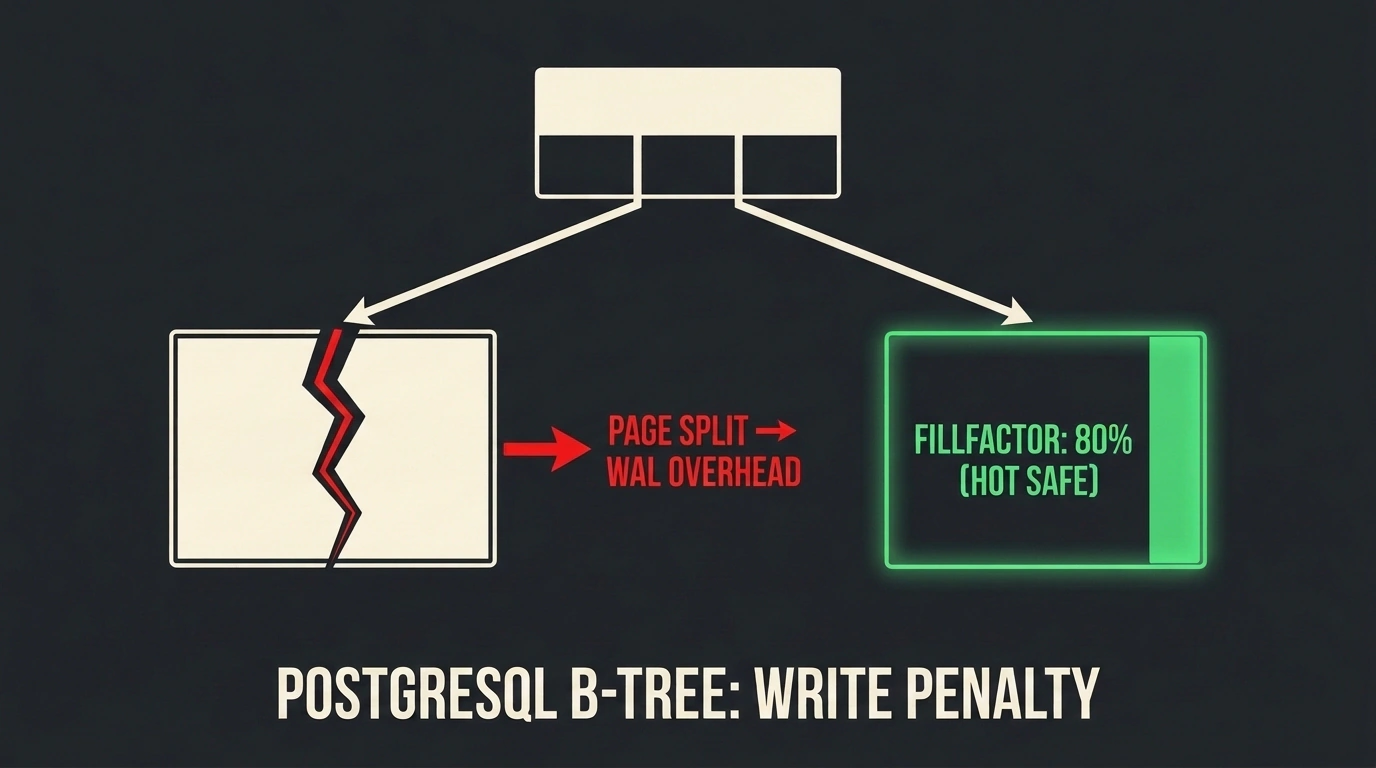
И вот тут случается самое неприятное — сплит страницы (Page Split). Листовой блок B-Tree имеет фиксированный размер 8 КБ. Если свободное место закончилось, СУБД вынуждена выделить новую страницу, перенести туда половину записей (примерно 50%), переписать указатели соседей и вставить новый ключ в родительский узел. Если родительская страница тоже заполнена, сплит рекурсивно каскадирует вверх вплоть до корня!
Каждый сплит страницы порождает лавинообразный поток записей в журнал упреждающей записи (Write-Ahead Log, WAL). Вместо одной маленькой строчки база сбрасывает на диск мегабайты служебных страниц. Дисковая подсистема перегружается, а реплики начинают отставать от мастера.
Как снизить цену записи: магия HOT и fillfactor
Чтобы не платить за индексы деградацией записи, используют проверенные архитектурные приёмы:
- Heap-Only Tuples (HOT-оптимизация в PostgreSQL): если
UPDATEменяет данные в колонках, которые не входят ни в один индекс, и на текущей странице таблицы есть свободное место, PostgreSQL вообще не трогает индексы! Новая версия строки сохраняется на той же странице таблицы и связывается внутренней цепочкой. Оверхед на обновление индексов становится равен нулю. - Тюнинг параметра
fillfactor: по умолчанию PostgreSQL заполняет страницы таблицы на 100%. Из-за этого при любомUPDATEновая версия строки не помещается на страницу, и HOT-цепочка ломается. Если на активно обновляемых таблицах снизить фактор заполнения со 100% до 80% (ALTER TABLE orders SET (fillfactor = 80)), СУБД оставит 20% свободного резерва на каждой странице, и доля быстрых HOT-обновлений вырастет до 95%+. - Частичные индексы (Partial Indexes): вместо индексации всей таблицы создавай индекс только по активным строкам (
WHERE status = pending). Это уменьшит размер дерева в разы и полностью избавит от налога на запись при работе с архивными данными.
Индексы — это финансовый кредит: ты выигрываешь микросекунды на чтении, но берёшь обязательство выплачивать проценты дисковым вводом-выводом на каждой записи. Если хочешь глубже прокачать культуру работы с запросами, взгляни на наш материал 10 правил быстрого SQL: индексы, селективность и чтение планов выполнения.