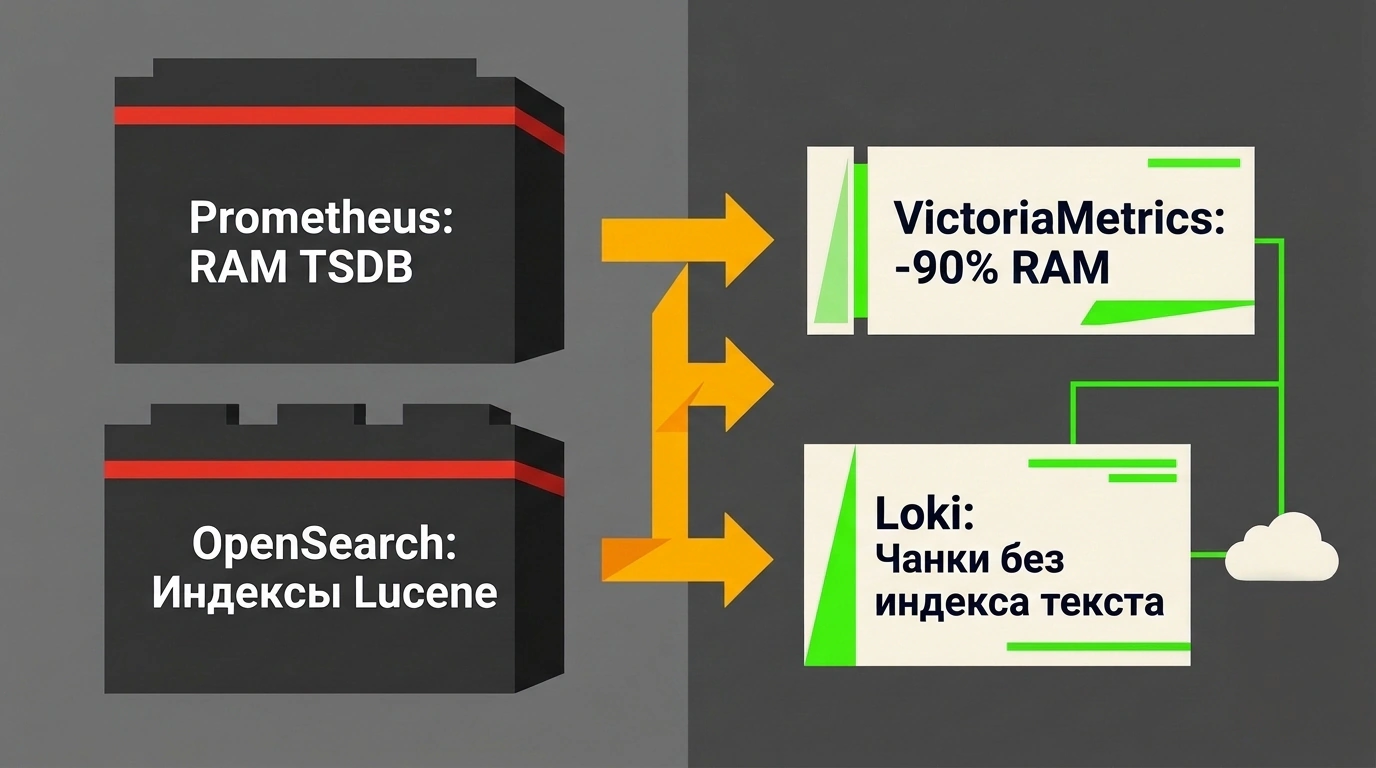

Когда микросервисная архитектура начинает разрастаться, перед инженером эксплуатации неизбежно встает вопрос масштабирования стека наблюдаемости (Observability). Традиционный золотой стандарт облачной инфраструктуры — связка базы временных рядов Prometheus для метрик и поискового кластера OpenSearch для логов — начинает давать трещины при столкновении с реалиями динамического Kubernetes.
Постоянный перезапуск подов, динамические IP-адреса и обилие пользовательских меток вызывают взрывной рост кардинальности (high cardinality). Prometheus начинает упираться в память одного узла, а OpenSearch раздувает дисковые массивы терабайтами инвертированных индексов.
В серии инженерных разборов DevOps by REBRAIN разобран прагматичный баттл между классикой и легковесными альтернативами: VictoriaMetrics и Grafana Loki. Давай разберем компромиссы этих решений.
Битва метрик: Prometheus против VictoriaMetrics
Главная ахиллесова пята классического Prometheus — его встроенная TSDB. Она проектировалась для хранения данных на локальном диске одного сервера:
- При росте числа активных серий до нескольких миллионов Prometheus требует сотен гигабайт оперативной памяти (RAM) для удержания индексов.
- Чтобы объединить метрики нескольких кластеров и настроить долгосрочное хранение на годы, приходится громоздить сложные надстройки (Thanos, Cortex или Mimir).
VictoriaMetrics решает эту задачу изящнее. Будучи на 100% совместимой с протоколом PromQL и форматом remote_write, она потребляет в 10–15 раз меньше оперативной памяти за счет компактных структур кэшей и сжимает данные на диске в 7–10 раз плотнее благодаря блочному поколоночному хранилищу (merge-tree).
Переключить поток метрик из существующего Prometheus в VictoriaMetrics можно парой строчек конфигурации prometheus.yml:
# Отправка собранных метрик в кластер VictoriaMetrics
remote_write:
  - url: "http://victoriametrics:8428/api/v1/write"
    queue_config:
      max_samples_per_send: 10000
      capacity: 50000
      max_shards: 30
В нашем детальном разборе того, как устроено внутреннее устройство VictoriaLogs от приема записей до колоночного сжатия, мы видели преимущества отказа от тяжелых индексов. VictoriaMetrics и родственные ей инструменты позволяют существенно отодвинуть потолок масштабирования без изменения привычных дашбордов в Grafana.
Битва логов: OpenSearch против Grafana Loki
Если в мире метрик победа легковесности часто очевидна, то в хранении логов архитектурная развилка выглядит намного острее:
- OpenSearch строит полноценные инвертированные индексы Apache Lucene по каждому слову в каждом JSON-документе. Ты получаешь моментальный поиск по сложным регулярным выражениям и неструктурированным трейсам. Но расплата за это колоссальна: дисковый оверхед превышает сырой объем логов в 3–5 раз, а кластер требует десятков гигабайт дорогой памяти JVM Heap на каждом узле.
- Grafana Loki применила радикальный трюк: Loki принципиально не индексирует текст логов! Индексируются исключительно метаданные (лейблы
app,namespace,pod), а сами строки упаковываются в сжатые чанки и отправляются в копеечное объектное хранилище (S3, MinIO или Ceph).
Поиск внутри Loki выполняется потоковым сканированием через язык LogQL:
# Пример запроса LogQL: фильтрация логов конкретного сервиса с поиском паник
{namespace="production", app="billing"} |= "panic:" | json | status >= 500
Счета за дисковое хранилище при переходе на Loki падают на 60–80%, а клик по спайку ошибок на графике метрик в Grafana моментально открывает логи того же пода благодаря общим лейблам.
Оптимальная стратегия для зрелых команд: оставьте локальный Prometheus как легковесный агент сбора метрик со сбросом в VictoriaMetrics через remote_write, а логи разделите — системные и прикладные события направляйте в экономичный Loki, сохраняя OpenSearch только для критичных задач аудита безопасности и SIEM.
Выбор сводится к простому правилу: если тебе нужен мгновенный поиск редких опечаток по миллиардам старых записей — плати за OpenSearch. Во всех остальных сценариях связка VictoriaMetrics и Loki дает колоссальный выигрыш в ресурсах.