
Если ты внимательно следишь за индустрией машинного обучения и развитием больших языковых моделей (LLM), то наверняка не раз ловил себя на скептическом отношении к стандартным лидербордам и синтетическим бенчмаркам вроде MMLU, GSM8K или HumanEval. Стоит новой модели появиться на горизонте, как маркетологи заваливают сообщество победными графиками с превосходством в десятые доли процента над вчерашними лидерами. Но как только ты берешь эту распиаренную новинку в реальный боевой бэкенд, парсишь сложные вложенные JSON-структуры или гоняешь автономных агентов по гигантской кодовой базе, карета мгновенно превращается в тыкву: модель галлюцинирует, срывает формат вызова функций и уходит в бесконечные циклы.
Фундаментальная проблема заключалась в том, что объективные данные о реальном использовании моделей оставались скрытыми за семью замками внутри датацентров OpenAI, Google, Microsoft и Anthropic. До сих пор все мы видели лишь отретушированный фасад корпоративного маркетинга.
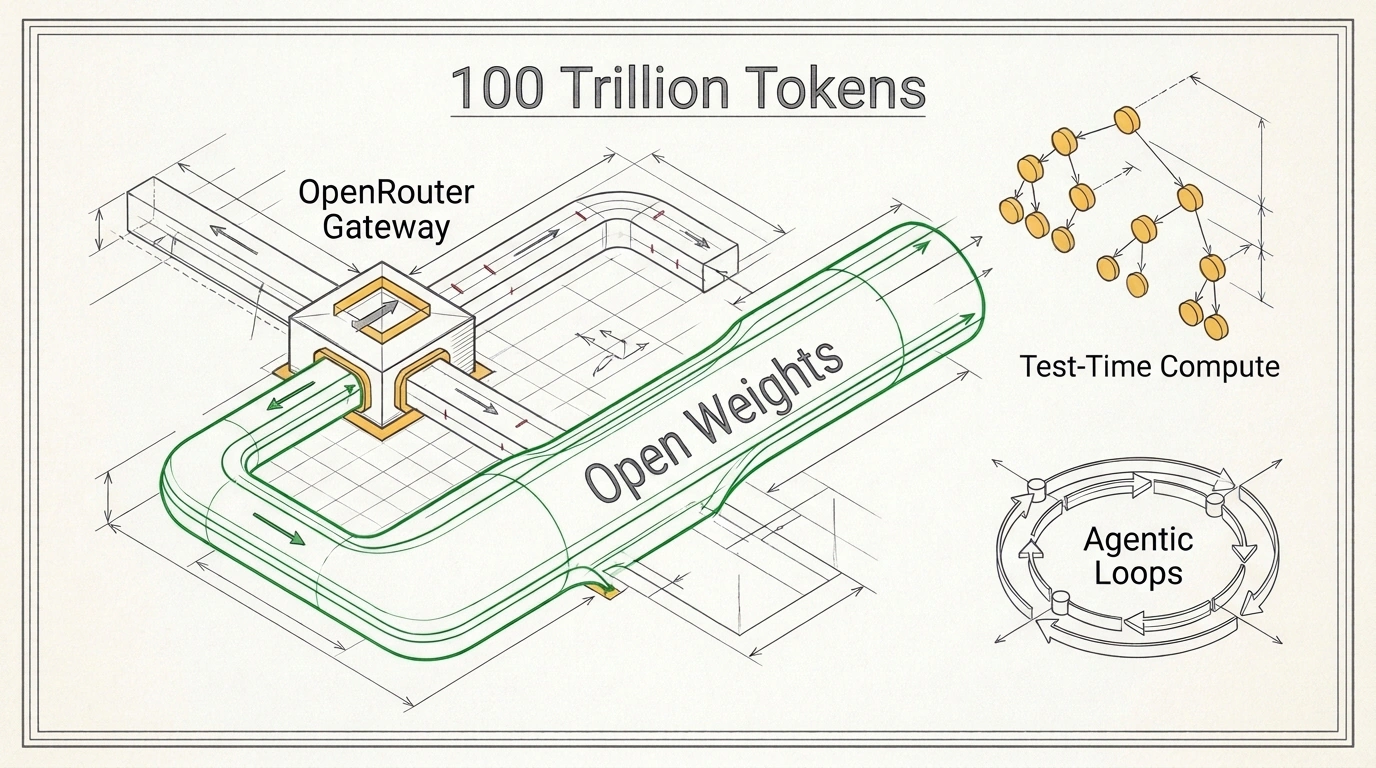
Но теперь в этой информационной блокаде пробита огромная брешь. Независимый платформенный шлюз OpenRouter, через который ежедневно проходят миллиарды запросов сотен тысяч инженеров со всего мира, совместно с венчурным фондом Andreessen Horowitz (a16z) опубликовал масштабное академическое исследование: «State of AI: An Empirical 100 Trillion Token Study with OpenRouter» (препринт доступен на arXiv).
В основу этого монументального труда лег деперсонализированный массив телеметрии невиданного масштаба — более 100 триллионов реальных токенов инференса. Давай снимем глянцевую обертку с индустрии ИИ и посмотрим на сухие инженерные факты: как на самом деле изменился баланс сил между открытыми и закрытыми весами, почему рухнул миф о непреодолимом рве гиперскейлеров и как рассуждающие модели перевернули архитектуру и экономику вычислений.
За пределами синтетических бенчмарков: объективная картина реального веба
Главная ценность исследования a16z и OpenRouter заключается в абсолютной чистоте и прикладном характере выборки. Синтетические тесты давно страдают от проблемы утечки тестовых данных в обучающие выборки (data contamination). Модели целенаправленно натаскивают на решение конкретных академических задачек, подгоняя веса под популярные тесты, словно нерадивые студенты перед сессией. В реальном продакшене задачи устроены принципиально иначе: здесь нет идеальных школьных условий, зато есть грязные пользовательские логи, неполный контекст и жесткие требования к времени ответа.
Платформа OpenRouter представляет собой нейтральный маркетплейс инференса: она не продает собственные веса, а предоставляет единый универсальный API-интерфейс к сотням моделей — от проприетарных гигантов (OpenAI GPT-4o, Anthropic Claude 3.5 Sonnet, Google Gemini) до открытых архитектур (DeepSeek, Meta Llama, Qwen, Mistral, Moonshot, MiniMax, Yi, GLM). Потребители этого трафика — не праздные пользователи чат-ботов, задающие вопросы о рецептах яблочных пирогов, а профессиональные разработчики, стартапы и продуктовые компании, встраивающие нейросети в свои сервисы, CLI-агенты, IDE и автоматизированные пайплайны.
Исследователи проанализировали динамику запросов за последние полтора года. На старте выборки недельный трафик платформы составлял скромные 1.8 триллиона токенов, а к осени 2026 года подскочил до ошеломляющих 36.8 триллионов токенов в неделю! Каждая транзакция анализировалась по десяткам телеметрических параметров: соотношение входных и выходных токенов, задержка первого токена (Time-To-First-Token), частота вызова внешних инструментов, ошибки валидации и стоимость обслуживания.
В нашем разборе того, как происходила трансформация инфраструктуры разработки и консолидация LLM-шлюзов OpenRouter, мы подробно отмечали нарастающую роль интеллектуальной маршрутизации. Теперь перед нами полноценные эмпирические подтверждения этой тектонической трансформации.
Великий географический перелом: взлет открытых моделей Китая
Самый оглушительный вывод исследования разрушает расхожее представление о том, что Кремниевая долина сохраняет абсолютное и непререкаемое лидерство в сфере искусственного интеллекта. Данные 100 триллионов токенов зафиксировали грандиозный географический перелом.
Весной 2025 года через закрытые американские API проходило более двух третей всего объема генерации на платформе. Доля открытых моделей казалась маргинальной, а китайские разработки воспринимались аналитиками скорее как догоняющие копии. Но за последующие двенадцать месяцев произошел колоссальный сдвиг: объем инференса открытых китайских моделей (во главе с семейством DeepSeek и линейкой Qwen от Alibaba) не просто догнал американские сервисы, а превысил их трафик почти в два раза! К осени 2026 года китайские модели стабильно генерировали свыше 19.5 триллионов токенов в неделю против примерно 14.0 триллионов у американских гигантов.
Особенно ярко авторы опровергли тезис о так называемом «закате DeepSeek», который активно тиражировали консалтинговые агентства в конце 2025 года. Выход архитектур DeepSeek-V3 и рассуждающей модели DeepSeek-R1 спровоцировал лавинообразный переход разработчиков. Когда качество генерации кода и математических расчетов достигает паритета с лучшими коммерческими моделями, а стоимость одного миллиона токенов составляет $0.14–$0.28 против $2.50–$15.00 у закрытых конкурентов, инженерная прагматика побеждает любые бренды.
В материале о том, как Qwen 3.8 Max обеспечил сдвиг в сторону открытых языковых моделей, мы подробно описывали архитектурные особенности внимания и структуры смеси экспертов (Mixture-of-Experts, MoE). Отчет a16z доказывает: бизнес выбирает открытость и экономическую эффективность.
От одного ответа к скрытым размышлениям: революция Test-Time Compute
Второй фундаментальный сдвиг, задокументированный в исследовании, касается внутренней физики инференса. Индустрия бесповоротно вступила в эпоху рассуждающих моделей (Reasoning Models) и парадигмы вычислений во время обслуживания запроса (Test-Time Compute).
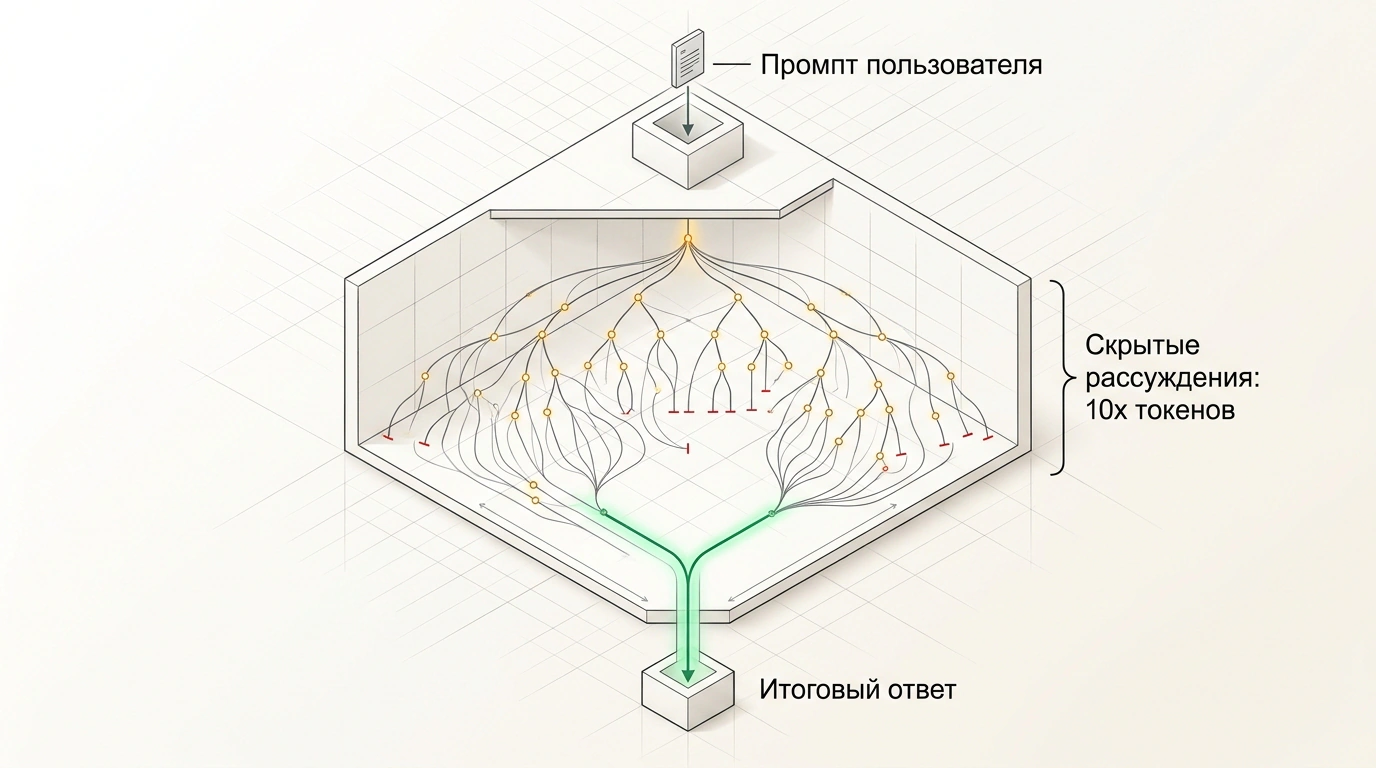
В классических авторегрессионных моделях (GPT-4, Llama 3) архитектура работала в режиме жесткой пропорции: пользователь отправлял контекст, и модель за один проход генерировала ответ токен за токеном. Соотношение между объемом промпта и завершением (prompt-to-completion ratio) стабильно держалось в коридоре от 3:1 до 5:1. На каждую сотню входящих токенов генерировалось всего 20–30 исходящих.
С появлением рассуждающих моделей архитектура вывернулась наизнанку:
- Модель больше не пытается угадать правильный ответ мгновенно с первого же токена;
- Она запускает фазу скрытых внутренних рассуждений (thinking tokens / chain-of-thought), генерируя дерево промежуточных гипотез, проверяя шаги доказательства и отбрасывая тупиковые ветви;
- Объем внутренних невидимых токенов стал превышать видимый финальный ответ пользователя в 5–15 раз!
Инференс перестал быть простой интерполяцией текста. Он превратился в полноценный алгоритмический поиск по графу решений (tree search / Monte Carlo Tree Search). Для инженеров инфраструктуры это означает колоссальное увеличение нагрузки на видеокарты (GPU) во время обслуживания одной пользовательской транзакции. Если раньше узким местом была передача весов из памяти (memory bandwidth bound), то теперь генерация сотен скрытых шагов рассуждений снова загружает тензорные ядра на полную мощность.
Агентные циклы и автономия: кто на самом деле сжигает вычислительные мощности
Кто же выступает главным потребителем этих триллионов токенов? Анализ метаданных запросов развенчал еще один популярный обывательский стереотип: будто нейросети используются в основном для составления электронных писем или школьных рефератов.
Реальная картина производственного применения выделила три доминирующих кластера:
- Генерация, аудит и рефакторинг кода (Coding Assistance). Это абсолютный локомотив потребления вычислительных мощностей. Современные среды разработки и агентные терминалы (Cursor, Windsurf, Claude Code, Aider) скармливают моделям гигантские контекстные окна (от 32k до 128k токенов). В промпт упаковываются целые файлы проекта, абстрактные синтаксические деревья, логи юнит-тестов и вывод компилятора.
- Агентные циклы обратной связи (Agentic Loops & Tool Calling). Разработчики всё реже вызывают LLM разово. Стандартной практикой стало построение автономных контуров: модель генерирует аргументы API-вызова, среда выполнения запускает команду в изолированной песочнице, результат исполнения возвращается модели, и та принимает решение о следующем шаге. За одну пользовательскую задачу модель может совершить от 10 до 50 итераций, сжигая десятки тысяч токенов за считанные секунды.
- Ролевые взаимодействия и творческие диалоги (Roleplay & Interactive Narrative). Неожиданное второе место по объему открытого трафика заняли не корпоративные чат-боты, а интерактивные развлекательные платформы. Открытые модели без ханжеских корпоративных фильтров и цензуры стали идеальной базой для сервисов виртуальных компаньонов и игровых персонажей.
Эффект Золушки и парадокс Джевонса: инерция продакшена против дешевизны инференса
Один из самых захватывающих разделов исследования посвящен когортному анализу поведения инженерных команд (Developer Cohort Retention). Исследователи выявили феномен, получивший название «эффект Золушки» (Cinderella Effect).
Суть феномена в следующем: когда на рынок выходит прорывная модель, вокруг нее формируется когорта разработчиков, которые с нуля отлаживают под нее свои промпты, схемы валидации JSON и системные инструкции. Проходят месяцы, конкуренты выпускают более быстрые, дешевые и умные альтернативы, но эта когорта упорно продолжает слать миллионы запросов в «свою» старую модель.
Причина этой инерции кроется в хрупкости промптов (prompt brittleness). Замена базовой модели в работающем бэкенде — это кошмар для инженера: меняется структура ответов, плывут граничные условия, ломается парсинг аргументов функций. Поэтому команды откладывают миграцию до последнего, пока на горизонте не появится решение, превосходящее текущее не на проценты, а в разы. Именно таким тектоническим событием стал релиз DeepSeek-V3, который сломал инерцию сотен тысяч проектов за считанные недели.
Падение стоимости инференса на порядок не сокращает совокупные затраты компаний на ИИ. Напротив, резкое удешевление вычислений вызвало лавинообразный стократный рост потребления: разработчики перестали экономить контекст, перешли к мультиагентным роям и запустили непрерывные фоновые аудиты.
В экономической теории это явление известно как парадокс Джевонса: повышение технологической эффективности использования ресурса ведет к росту его суммарного потребления, а не к экономии. Когда токен стоит доли цента, исчезает стимул агрессивно урезать системный промпт — инженеры предпочитают скармливать модели полную историю изменений git и всю документацию API.
Архитектура инженерного стека: маршрутизация, кэш префиксов и таймауты нового поколения
Опираясь на массив эмпирических данных, авторы отчета сформировали набор строгих архитектурных рекомендаций для инженеров, проектирующих надежные распределенные сервисы на базе LLM.
Если ты строишь современный бэкенд с интеграцией нейросетей, тебе необходимо пересмотреть базовые инфраструктурные паттерны:
- Динамическая мультипровайдерная маршрутизация. Завязываться на прямое API одного конкретного хостера — верный путь к регулярным простоям (downtime). Инференс открытых моделей обслуживается распределенной сетью датацентров. Грамотный шлюз должен автоматически балансировать нагрузку между несколькими независимыми провайдерами с учетом задержек и доступности видеокарт.
- Кэширование префиксов контекста (Prompt Caching). Поскольку агентные системы постоянно отправляют один и тот же системный промпт и неизменную базу кода, использование хостинга с поддержкой сохранения KV-кэша (например, vLLM с PagedAttention или SGLang) снижает стоимость и задержку входящих токенов на 50–80%.
- Кардинальный пересмотр HTTP-таймаутов. Классические микросервисные таймауты в 5–10 секунд гарантированно уронят соединение при работе с рассуждающими моделями. Фаза скрытых размышлений может занимать от 30 до 60 секунд до появления первого байта в потоке (Time-To-First-Token). Архитектура обязана поддерживать асинхронные очереди (Webhooks, Server-Sent Events, gRPC-стриминг) вместо блокирующих синхронных вызовов.
Выстраивайте структуру промптов так, чтобы статическая часть (системная инструкция, описание инструментов, постоянная схема БД) находилась строго в начале запроса, а динамические пользовательские данные — в самом конце. Это позволяет движкам инференса переиспользовать скомпилированный KV-кэш для всех параллельных сессий.
Смена парадигмы: почему открытые веса стали фундаментом цифровой инженерии
Исследование 100 триллионов токенов OpenRouter подводит черту под первым этапом революции генеративного ИИ. Эпоха наивного восторга перед закрытыми монополистами уступила место зрелой инженерной прагматике.
Корпоративный миф о «неприступном технологическом рве» проприетарных лабораторий окончательно развеян. Открытые веса, возможность самостоятельного развертывания (self-hosting) в собственном защищенном контуре и гибкая ценовая конкуренция десятков независимых хостинг-провайдеров превратили качественный инференс в биржевой товар (commodity).
Для разработчиков и архитекторов это открывает беспрецедентную свободу: мы больше не привязаны к капризам ценовой политики, смене условий лицензирования или внезапным блокировкам одного поставщика. Будущее цифровой инженерии принадлежит открытым стандартам, прозрачной архитектуре и прагматичному контролю над собственными вычислительными мощностями.