

В современной индустрии программной инженерии сейчас царит атмосфера всеобщей эйфории. Менеджеры радостно рапортуют о росте скорости закрытия продуктовых задач в три раза, разработчики хвастаются в социальных сетях, что за один вечер собрали рабочий прототип сервиса на Claude Code или Cursor, а аналитики всерьез предрекают скорую смерть классического программирования. Кажется: нажал клавишу Tab — и готовая функция уже лежит в репозитории вместе с типами, интерфейсами, юнит-тестами и пространным описанием в pull request.
Но если заглянуть под глянцевую обертку этой кажущейся продуктивности, перед глазами опытного разработчика открывается пугающая инженерная реальность. Долгоживущие кодовые базы стремительно деградируют, обрастая чудовищными слоями псевдо-абстракций, циклических зависимостей и мертвого кода, который никто в команде не понимает и не рискует удалять.
Эту острейшую проблему детально препарировал признанный эксперт по архитектуре и создатель образовательного проекта HowProgrammingWorks Тимур Шемсединов в своем фундаментальном видеодокладе Тимура Шемсединова. Запись вызвала колоссальный резонанс в профессиональном сообществе, потому что открыто затронула то, о чем многие ведущие инженеры пока боятся говорить вслух: генеративный ИИ без жесткого архитектурного надзора и фильтрации способен превратить развивающийся проект в радиоактивные руины всего за несколько месяцев интенсивной разработки.
Давай вместе разберем эту анатомию катастрофы шаг за шагом, препарируем скрытые механизмы оверинжиниринга, выясним, почему языковые модели так упорно плодят бойлерплейт, и разберемся, как защитить свой проект от архитектурного паралича.
Фабрика фабрик: почему языковые модели обожают оверинжиниринг
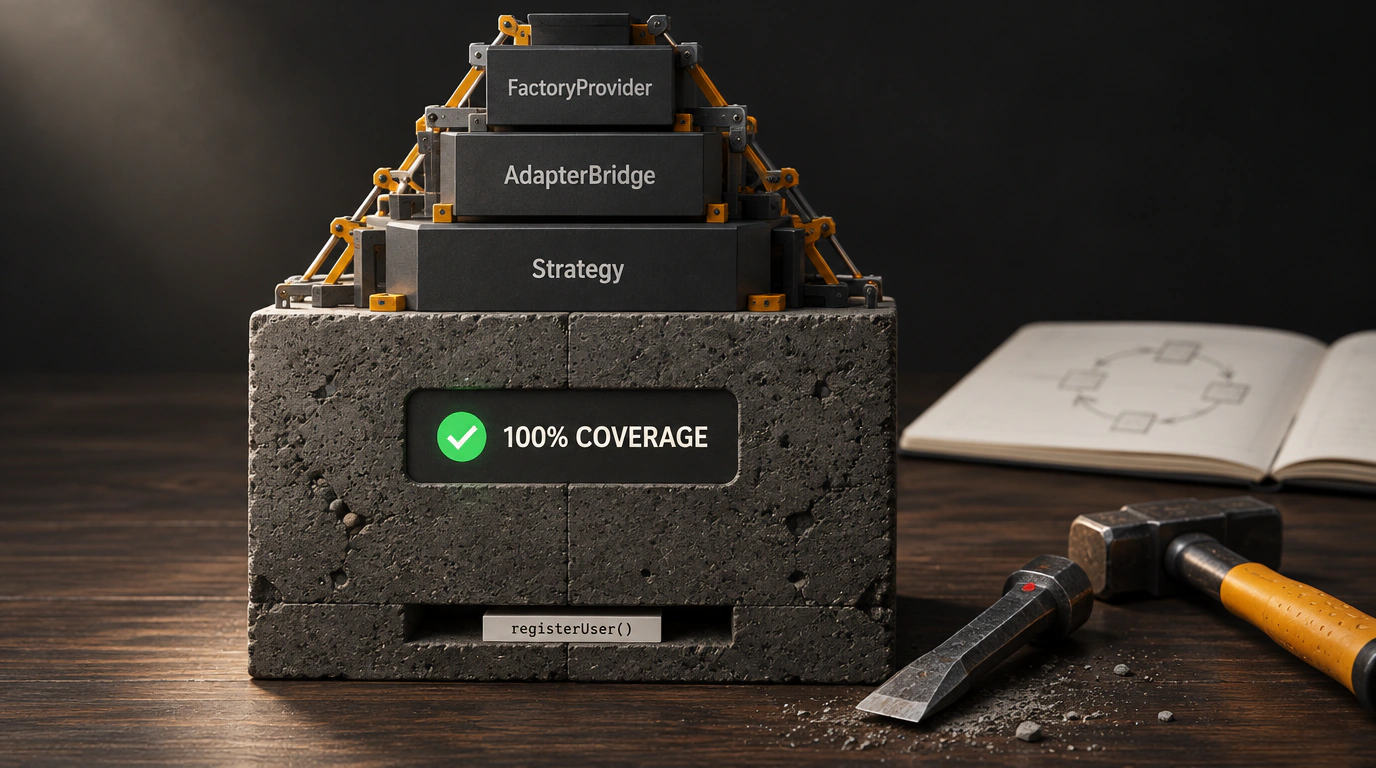
Чтобы понять глубинные корни этой проблемы, нужно вспомнить, на каких именно материалах обучались современные большие языковые модели (LLM). В их колоссальных обучающих корпусах лежат миллионы строк кода корпоративных enterprise-систем на Java и C# начала 2010-х годов, классические учебники по паттернам объектно-ориентированного проектирования Банды четырех (GoF) и бесконечные учебные репозитории, создатели которых пытались искусственно втиснуть Abstract Factory, Visitor, Bridge и Strategy в простейший консольный калькулятор.
Когда разработчик дает нейросети вполне жизненную задачу: «Напиши функцию валидации email-адреса и сохранения нового пользователя в базу данных», модель действует не как прагматичный инженер, а по принципу максимизации статистической правдоподобности тяжелого корпоративного кода. Вместо того чтобы написать три строчки чистой и понятной бизнес-логики на TypeScript, Go или Python, агент мгновенно генерирует целую иерархию файлов:
- Абстрактный интерфейс
IEmailValidatorStrategy; - Класс
RegexEmailValidatorServiceImpl; - Фабрику создания фабрик
EmailServiceFactoryProvider; - Адаптер интеграции
NotificationDispatchAdapterBridge; - DTO-обертку
UserEmailPayloadValueObject.
Смотри, что происходит на самом деле. Исходная прикладная задача легко решалась обычной чистой функцией из десяти строк. Но ИИ породил пять отдельных файлов, полдюжины типов и три уровня косвенности. Зачем? Потому что в обучающей выборке энтерпрайзный код с десятком интерфейсов выглядит «солидно», «масштабируемо» и «профессионально». Модель оптимизирует не простоту поддержки, а формальную сложность текста.
Давай посмотрим на наглядный пример такого ИИ-оверинжиниринга на TypeScript:
// То, что сгенерировал ИИ на простой запрос сохранения пользователя:
export interface IUserRepositoryPort {
  save(user: UserEntity): Promise<UserResultDto>;
}

export interface IUserDataMapper<TSource, TTarget> {
  mapToDomain(source: TSource): TTarget;
  mapToPersistence(target: TTarget): TSource;
}

export class PostgresUserDataMapperImpl implements IUserDataMapper<RawDbRecord, UserEntity> {
  mapToDomain(source: RawDbRecord): UserEntity {
    return new UserEntity(source.id, source.email_address, source.created_timestamp);
  }
  mapToPersistence(target: UserEntity): RawDbRecord {
    return { id: target.id, email_address: target.email, created_timestamp: target.createdAt };
  }
}

export class UserPersistenceOrchestratorService {
  constructor(
    private readonly repositoryPort: IUserRepositoryPort,
    private readonly mapperService: IUserDataMapper<RawDbRecord, UserEntity>
  ) {}

  async executeUserRegistrationFlow(payload: RegisterUserCommandDto): Promise<UserResponseEnvelopeDto> {
    // Вся реальная логика утонула под слоями вызовов мапперов
    const domainEntity = this.mapperService.mapToDomain(payload.rawRecord);
    const saveResult = await this.repositoryPort.save(domainEntity);
    return new UserResponseEnvelopeDto(saveResult);
  }
}
Вся эта монументальная пирамида классов не несет абсолютно никакой бизнес-ценности. Проект никогда в жизни не будет менять PostgreSQL на Oracle на лету посреди ночи, у сервиса существует ровно одна реализация репозитория, а маппер просто перекладывает поля из одного объекта в другой с переименованием ключей из snake_case в camelCase. Но в кодовой базе уже появилось 40 строк бойлерплейта, которые теперь нужно читать, компилировать, индексировать и мысленно удерживать в голове.
Ловушка синтетических тестов: как зацементировать мертвый код
Сам по себе раздутый код неприятен, но в нормальных условиях его еще можно было бы легко переписать за пару часов вдумчивого рефакторинга. И вот здесь захлопывается вторая, самая смертоносная ловушка современной ИИ-разработки: генерация синтетических юнит-тестов.
Разработчик видит, что агент нагенерировал сложную структуру классов, и дает следующую команду: «А теперь покрой все эти классы юнит-тестами со 100% покрытием кода». Агент с радостным энтузиазмом выполняет указание и генерирует двести строк тестов на базе Jest, Vitest или pytest.
Но как тестировать пустые интерфейсы и искусственные мапперы? Модель начинает мокать абсолютно всё подряд:
// Синтетический юнит-тест от ИИ, который тестирует сам себя:
describe('UserPersistenceOrchestratorService', () => {
  it('должен вызывать маппер и сохранять пользователя через порт', async () => {
    // Создаем бесконечные моки на каждый чих
    const mockMapper: jest.Mocked<IUserDataMapper<RawDbRecord, UserEntity>> = {
      mapToDomain: jest.fn(),
      mapToPersistence: jest.fn(),
    };
    const mockRepo: jest.Mocked<IUserRepositoryPort> = {
      save: jest.fn(),
    };

    const dummyUser = new UserEntity('u-1', 'test@example.com', new Date());
    mockMapper.mapToDomain.mockReturnValue(dummyUser);
    mockRepo.save.mockResolvedValue(new UserResultDto('u-1', 'SUCCESS'));

    const orchestrator = new UserPersistenceOrchestratorService(mockRepo, mockMapper);
    const result = await orchestrator.executeUserRegistrationFlow({ rawRecord: {} as any });

    // Проверяем, что мок вызвал мок с параметрами мока:
    expect(mockMapper.mapToDomain).toHaveBeenCalledTimes(1);
    expect(mockRepo.save).toHaveBeenCalledWith(dummyUser);
    expect(result.status).toBe('SUCCESS');
  });
});
Посмотри внимательно на этот тестовый сценарий. Что он реально проверяет? Поведение реальной системы? Корректность записи в базу данных? Работу бизнес-правил? Нет! Этот тест проверяет исключительно то, что метод A внутри вызвал мок B, который передал аргумент моку C. Если в реальной базе данных отвалится таблица, слетит схема или отключится сеть, этот юнит-тест продолжит бодро зеленеть в CI-пайплайне, создавая ложное чувство полной защищенности.
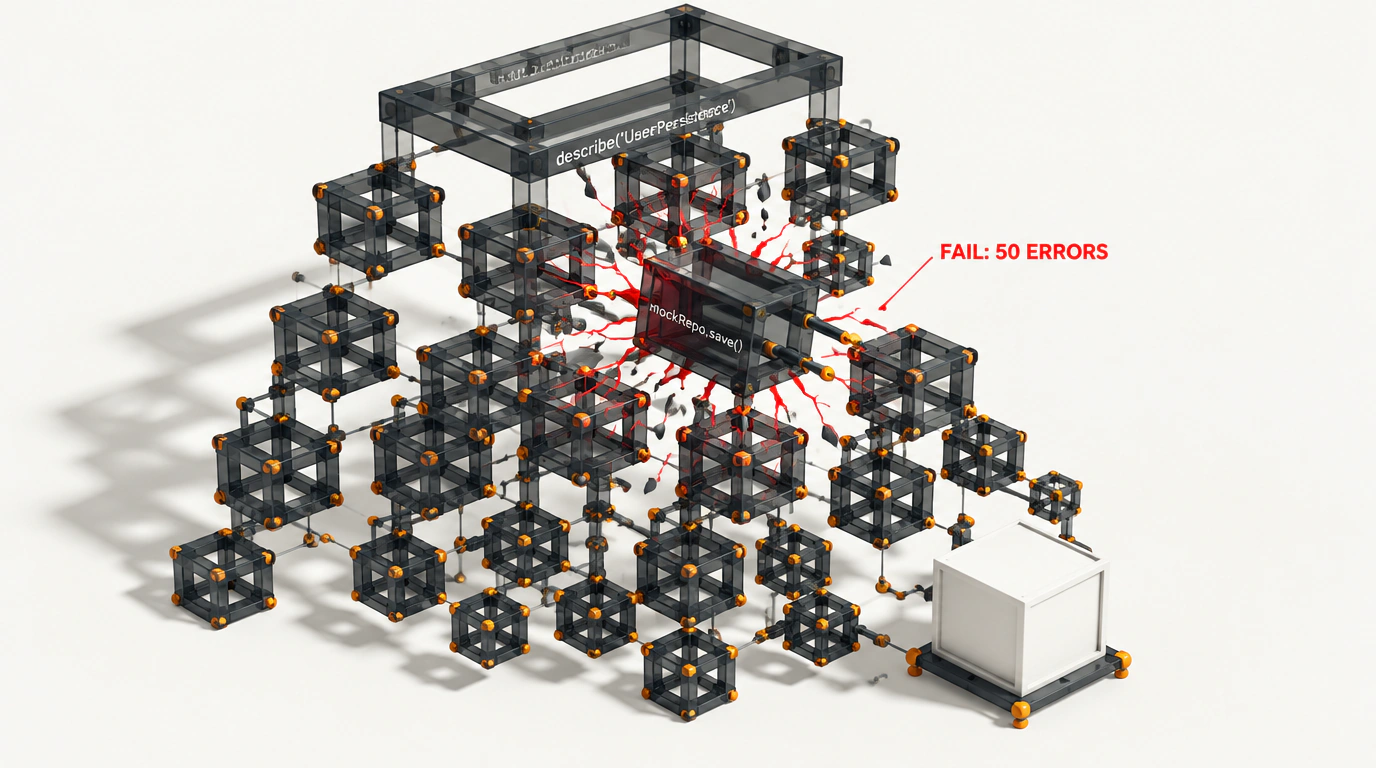
Но самое страшное происходит потом. Когда через три месяца живой инженер открывает этот файл и справедливо решает: «Какой кошмар, зачем здесь пять классов, я перепишу это в одну простую и понятную функцию!», он запускает тестовый набор — и получает пятьдесят красных ошибок!
Тесты намертво завязаны на внутреннюю реализацию фиктивных классов и сигнатуры моков. Любая попытка удалить бесполезный интерфейс ломает тестовый сьют. Инженер пугается: «Ого, тут столько проверок упало, видимо, это критически важная архитектура, лучше не трогать от греха подальше». И мертвый код остается в системе навсегда. ИИ буквально зацементировал собственные архитектурные галлюцинации синтетическими тестами.
Симбиоз мертвого кода и паразитные циклические связи
Тимур Шемсединов в своем докладе подробно разбирает следующий этап деградации: возникновение циклических связей между модулями мертвого кода.
Когда в проекте работают несколько ИИ-агентов или разные разработчики непрерывно промптят модели в параллельных ветках, агенты не исследуют кодовую базу целиком. Модель видит только локальный кусок контекста в несколько тысяч токенов. Если агенту требуется вспомогательная функция форматирования даты или валидации строки, он не ищет ее в существующих общих утилитах проекта. Ему в разы проще сгенерировать новый приватный хелпер прямо в текущем модуле или создать файл dateUtilsV2.ts.
Через несколько спринтов кодовая база наполняется паутиной дублирующих вызовов:
- Модуль A импортирует тип из модуля B;
- Модуль B импортирует вспомогательный интерфейс из модуля C;
- Модуль C для внутренних нужд импортирует хелпер обратно из модуля A.
Возникает циклический импорт (circular dependency). Для современных сборщиков вроде Vite, Rollup или Webpack это тяжелейшая нагрузка: граф модулей безнадежно запутывается, механизмы оптимизации размера бандла (tree-shaking) перестают работать, а размер клиентского кода раздувается в разы. Ни один автоматический статический анализатор не может безопасно удалить модуль B, потому что на него формально ссылаются типы из модуля C, хотя в реальности ни одна строчка бизнес-логики через этот путь никогда не выполняется!
Если ты помнишь наши материалы про гигиену контекста ИИ-агентов, то неконтролируемое скармливание нейросетям раздутых файлов замыкает порочный круг: чем грязнее кодовая база, тем более запутанный и избыточный код выдает модель в следующих итерациях.
Скрытая цена владения: почему страдает производительность команды
Менеджеры часто возражают: «Ну и пусть код раздут, какая разница, ведь диск дешевый, а нейросеть пишет быстро?»
Это опаснейшее заблуждение. Каждый лишний класс, каждый синтетический файл и фиктивный интерфейс создают постоянную и растущую стоимость владения (Total Cost of Ownership):
- Нагрузка на языковой сервер (LSP): Языковые серверы TypeScript, Go gopls или Rust Analyzer вынуждены непрерывно парсить, типизировать и удерживать в оперативной памяти тысячи фиктивных символов. Твоя IDE начинает ощутимо подтормаживать, подсказки автокомплита открываются с задержкой в секунду, а индексация проекта намертво подвешивает процессор ноутбука.
- Замедление CI/CD пайплайнов: Прогон сотен бесполезных тестов-самострелов увеличивает время сборки с 2 до 25 минут. Команда тратит часы драгоценного рабочего времени на ожидание зеленого пайплайна.
- Когнитивный паралич инженера: Человеческий мозг не может удерживать бесконечное количество сущностей. Когда новый разработчик приходит на проект и видит семь уровней абстракции вокруг одной таблицы, он тратит недели на то, чтобы просто понять, где в этой системе реально исполняются бизнес-правила.
Как должен выглядеть здоровый код: радикальный рефакторинг
Давай посмотрим, как тот же самый функционал сохранения пользователя выглядит в исполнении опытного инженера, исповедующего фундаментальные принципы YAGNI (You Aren't Gonna Need It) и KISS (Keep It Simple, Stupid):
// Здоровая, читаемая и надежная реализация без грамма лишнего жира:
import { sql } from '@/database/client';

export interface UserRegistrationInput {
  email: string;
  fullName: string;
}

export interface UserRecord {
  id: string;
  email: string;
  fullName: string;
  createdAt: Date;
}

// Простая, чистая асинхронная функция с прямой валидацией и запросом
export async function registerUser(input: UserRegistrationInput): Promise<UserRecord> {
  if (!input.email.includes('@')) {
    throw new Error('Некорректный формат адреса электронной почты');
  }

  const [createdUser] = await sql<UserRecord[]>`
    INSERT INTO users (email, full_name, created_at)
    VALUES (${input.email.toLowerCase()}, ${input.fullName.trim()}, NOW())
    RETURNING id, email, full_name as "fullName", created_at as "createdAt"
  `;

  return createdUser;
}
Почувствуй колоссальную разницу:
- Вместо пяти файлов и сложной паутины моков — один понятный модуль.
- Логика абсолютно прозрачна: входные данные, базовая проверка, параметризованный SQL-запрос, возврат типизированного результата.
- Такой код тестируется одним простым интеграционным тестом на реальной тестовой базе данных в Docker за 20 миллисекунд без единого мока! Если логика базы изменится, интеграционный тест честно упадет и покажет ошибку.
Инженерный регламент: как спасти проект от деградации
Чтобы не утонуть в болоте автогенерированного оверинжиниринга, команда Тимура Шемсединова сформулировала жесткие практические правила архитектурной гигиены для команд, использующих генеративный ИИ:
- Правило трех реализаций: Категорически запрещено создавать абстрактный интерфейс или фабрику, если в системе нет минимум трех принципиально разных реальных реализаций этого интерфейса. Если реализация одна — пишется конкретный класс или простая функция.
- Разделение контекстов при генерации: Никогда не проси одну и ту же модель генерировать и бизнес-логику, и тесты к ней в одном диалоге. Тесты должны писать другие люди или независимая модель, получающая на вход только спецификацию требований, а не внутренности сгенерированного кода.
- Лимит на размер пулл-реквеста: Если ИИ-ассистент сгенерировал PR на 1500 строк изменений, его запрещено принимать вслепую. Разработчик обязан разбить задачу на микро-шаги по 100–200 строк и лично проверить каждую строчку.
- Регулярные дни археологии (Dead Code Archaeology): Раз в месяц проект должен прогоняться через специализированные анализаторы мертвого кода (Knip, ts-prune, depcheck). Все неиспользуемые экспорты и промежуточные мапперы должны безжалостно вырезаться.
- Приоритет интеграционным тестам: Сокращайте долю мок-тестов в пользу сквозных и компонентных проверок на реальных изолированных базах (Testcontainers). Тест должен проверять результат работы системы, а не последовательность вызовов внутренних методов.
Главный вывод из этой истории прост и отрезвляющ: ценность инженера в эпоху ИИ заключается не в том, с какой скоростью он умеет нажимать кнопку генерации кода. Настоящее мастерство архитектора сегодня — это способность сказать коду твердое «нет» и защитить проект от лишних сущностей.