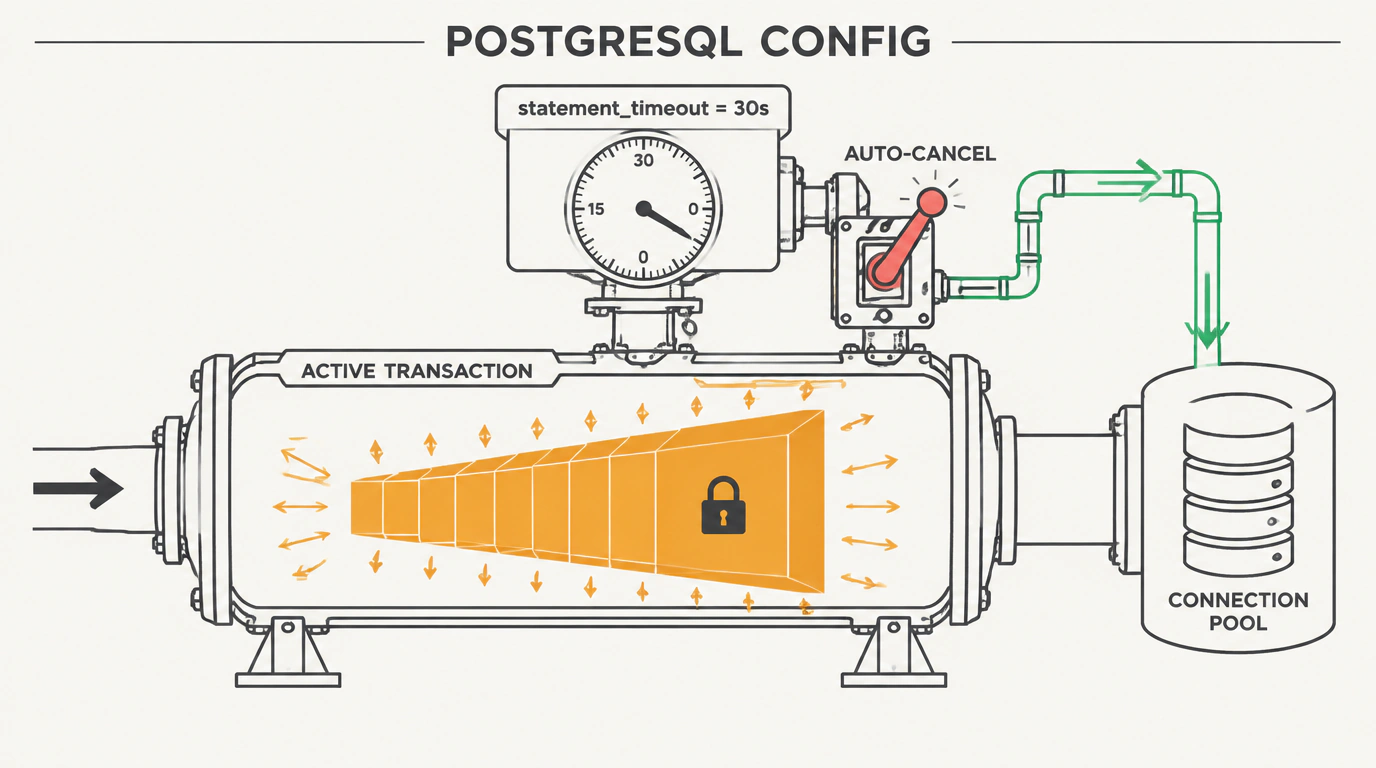

В практике администрирования реляционных баз данных есть классический кошмар, с которым рано или поздно сталкивается любая растущая команда. В середине рабочего дня бэкенд внезапно перестает отвечать на клиентские запросы. Графики задержек улетают в потолок, пул соединений пулера PgBouncer переполнен, а в логах сервисов сыплются ошибки ожидания свободного сокета.
Ты заходишь в системное представление pg_stat_activity и видишь виновника катастрофы: случайный разработчик или стажер запустил в продакшене аналитический запрос с неоптимальным объединением таблиц JOIN без индекса. Запрос крутится уже 40 минут, удерживает блокировку Shared Lock на критической таблице пользователей и намертво заблокировал сотни рядовых транзакций API.
А теперь самое поразительное: в стандартной конфигурации PostgreSQL значение параметра statement_timeout равно нулю! Это означает, что СУБД по умолчанию готова выполнять любой безумный SQL-запрос бесконечно долго, пока на сервере не закончится память или процессорное время.
Официальная документация в разделе документации PostgreSQL прямо рекомендует ограничивать время жизни операторов на уровне базы или роли пользователя.
Как настроить защитные лимиты правильно
Устанавливать лимит жестко в файле postgresql.conf для всего кластера — опасная ошибка, потому что это немедленно сломает фоновую утилиту снятия резервных копий pg_dump.
Правильный инженерный подход заключается в дифференцированной настройке на уровне конкретной базы данных и служебных ролей:
-- 1. Задаем глобальный защитный таймаут для всех новых сессий рабочей базы:
ALTER DATABASE my_production_db SET statement_timeout = '30s';

-- 2. Ужесточаем лимит для сервисного пользователя веб-приложения (API):
ALTER ROLE api_user SET statement_timeout = '10s';

-- 3. Разрешаем аналитикам выполнять более тяжелые выборки:
ALTER ROLE analytics_worker SET statement_timeout = '300s';

-- 4. Полностью снимаем ограничения для регламентного пользователя бэкапов:
ALTER ROLE backup_admin SET statement_timeout = '0';
Смотри, что происходит: если прикладной запрос от веб-сервиса выполняется дольше 10 секунд, PostgreSQL принудительно прерывает его выполнение с кодом ошибки 57014 (canceling statement due to statement timeout), моментально освобождает занятые блокировки и спасает кластер от затора.
Сопутствующие таймауты: лечим брошенные транзакции
Помимо самого statement_timeout, комплексная защита базы требует настройки еще двух критических параметров:
-- Прерывание транзакций, брошенных клиентом в открытом состоянии (idle in transaction):
ALTER DATABASE my_production_db SET idle_in_transaction_session_timeout = '60s';

-- Максимальное время ожидания захвата эксклюзивной блокировки таблицы или строки:
ALTER DATABASE my_production_db SET lock_timeout = '15s';
Если клиентское приложение открыло транзакцию BEGIN, выполнило UPDATE и «зависло» из-за сетевого сбоя, параметр idle_in_transaction_session_timeout закроет сессию через минуту, не позволяя заблокировать процесс очистки VACUUM.
А если тебе предстоит регламентная накатка миграции схемы (DDL), таймаут можно безопасно переопределить локально внутри конкретной сессии:
BEGIN;
SET LOCAL statement_timeout = '10min';
ALTER TABLE orders ADD COLUMN tracking_code text;
COMMIT;
Если ты хочешь глубже погрузиться в мониторинг СУБД, рекомендуем наш материал про диагностика узких мест в PostgreSQL. Настройка защитных таймаутов занимает ровно две минуты, но экономит недели нервов при пиковых нагрузках.