
Каждый бэкенд-разработчик на Go рано или поздно сталкивается с капризами распределенных сетей: кратковременный разрыв TCP-соединения, таймаут пограничного прокси или перезапуск пода в Kubernetes. В стандартном клиенте net/http повторить упавший запрос не так-то просто: поток данных req.Body закрывается и вычитывается до конца при первой же попытке, и повторный вызов падает с ошибкой http: Request.Body already consumed.
Чтобы не писать велосипеды с буферизацией байтов, сообщество обычно берет проверенную библиотеку go-retryablehttp от компании HashiCorp. Она бережно оборачивает стандартный транспорт, умеет перематывать io.ReadSeeker и автоматически повторяет отправку при кодах 500, 502, 503 и 504.
Однако здесь кроется опаснейшая иллюзия: транспортная повторяемость (transport retryability) не имеет ничего общего с прикладной идемпотентностью (application idempotence).
Ловушка параметра RetryMax и обрыва ответа
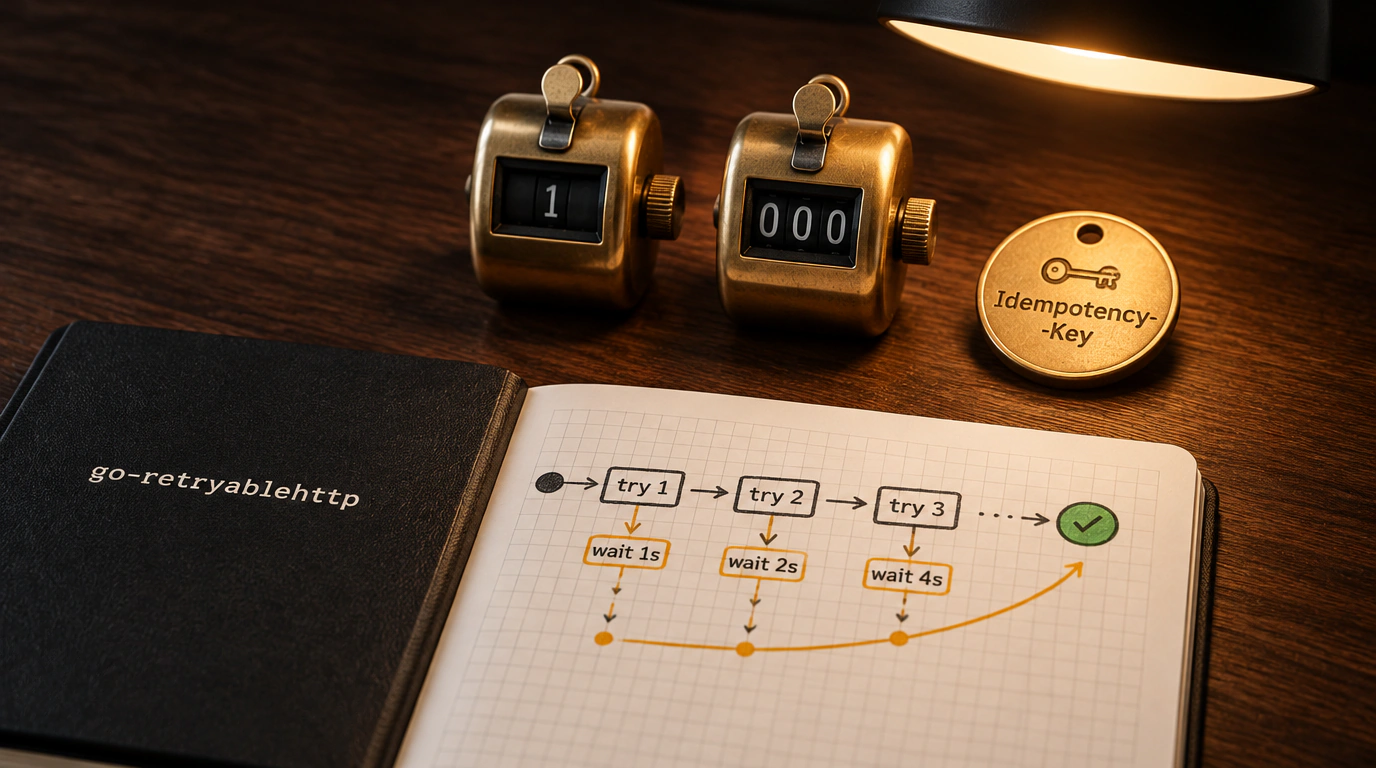
Первая неочевидная грабля библиотеки кроется в арифметике попыток. Когда ты задаешь в конфигурации параметр retryClient.RetryMax = 2, легко подумать, что сервис выполнит ровно два запроса. На самом деле параметр означает количество повторов после первой неудачной отправки. То есть клиент сделает до трех запросов: один исходный плюс два повтора. Если внешний API тарифицирует запросы или имеет жесткие лимиты частоты (rate limits), лишняя попытка может стать неприятным сюрпризом.
Вторая проблема куда серьезнее и касается мутирующих методов (POST, PATCH). Представь сценарий списания средств или создания заказа:
- Клиент отправляет POST-запрос с телом заказа на сервер платежного шлюза.
- Шлюз успешно валидирует запрос, списывает баланс и фиксирует транзакцию в базе данных.
- В момент формирования ответа 200 OK рвется связь или балансировщик сбрасывает соединение по таймауту.
- Клиент
go-retryablehttpвидит сетевую ошибкуconnection reset by peer, перематывает буфер тела запроса и честно отправляет его во второй раз.
Итог закономерен: если API на той стороне не обучено отслеживать повторы, у пользователя спишутся деньги дважды. Повторять «вслепую» на транспортном уровне безопасно только идемпотентные методы по стандарту HTTP (GET, HEAD, PUT, DELETE). Для мутирующих операций обязателен прикладной заголовок Idempotency-Key с уникальным UUID операции:
// Генерация заголовка идемпотентности перед отправкой
req, err := retryablehttp.NewRequestWithContext(ctx, "POST", apiURL, bytes.NewReader(payload))
if err != nil {
    return err
}

// Уникальный идентификатор гарантирует, что шлюз вернет кэшированный ответ вместо дублирования
req.Header.Set("Idempotency-Key", orderUUID.String())
req.Header.Set("Content-Type", "application/json")
Кастомная политика CheckRetry и случайный джиттер
Еще один нюанс, о котором часто забывают — поведение бэкоффа. Стандартная функция задержки DefaultBackoff в go-retryablehttp честно увеличивает паузу экспоненциально, но не добавляет к ней случайный джиттер (jitter). Если внешний микросервис кратковременно моргнул, сотни параллельных инстансов твоего приложения пойдут на повтор синхронно, создавая классическую проблему «громоподобного стада» (thundering herd) и окончательно добивая лежащий бэкенд.
Правильная инициализация клиента требует переопределения функции бэкоффа со случайной добавкой и контроля отмены контекста:
package main

import (
    "context"
    "math/rand"
    "net/http"
    "time"

    "github.com/hashicorp/go-retryablehttp"
)

func createSafeClient() *http.Client {
    retryClient := retryablehttp.NewClient()
    retryClient.RetryMax = 2 // 1 исходный + 2 повтора
    retryClient.RetryWaitMin = 100 * time.Millisecond
    retryClient.RetryWaitMax = 2 * time.Second

    // Добавляем случайный джиттер до 25% от интервала
    retryClient.Backoff = func(min, max time.Duration, attemptNum int, resp *http.Response) time.Duration {
        mult := time.Duration(1 << uint(attemptNum))
        sleep := min * mult
        if sleep > max {
            sleep = max
        }
        jitter := time.Duration(rand.Int63n(int64(sleep / 4)))
        return sleep + jitter
    }

    // Отмена контекста немедленно останавливает цикл повторов
    retryClient.CheckRetry = func(ctx context.Context, resp *http.Response, err error) (bool, error) {
        if ctx.Err() != nil {
            return false, ctx.Err()
        }
        return retryablehttp.DefaultRetryPolicy(ctx, resp, err)
    }

    return retryClient.StandardClient()
}
Помни, что для неперематываемых интерфейсов io.Reader библиотека вычитывает все тело запроса в срез байтов в оперативной памяти. Если через go-retryablehttp отправляются файлы размером в сотни мегабайт, это вызовет резкий скачок потребления RAM и нагрузку на GC.
В сухом остатке: библиотека go-retryablehttp великолепно снимает транспортную рутину, но архитектурная ответственность за идемпотентность данных всегда остается на разработчике.