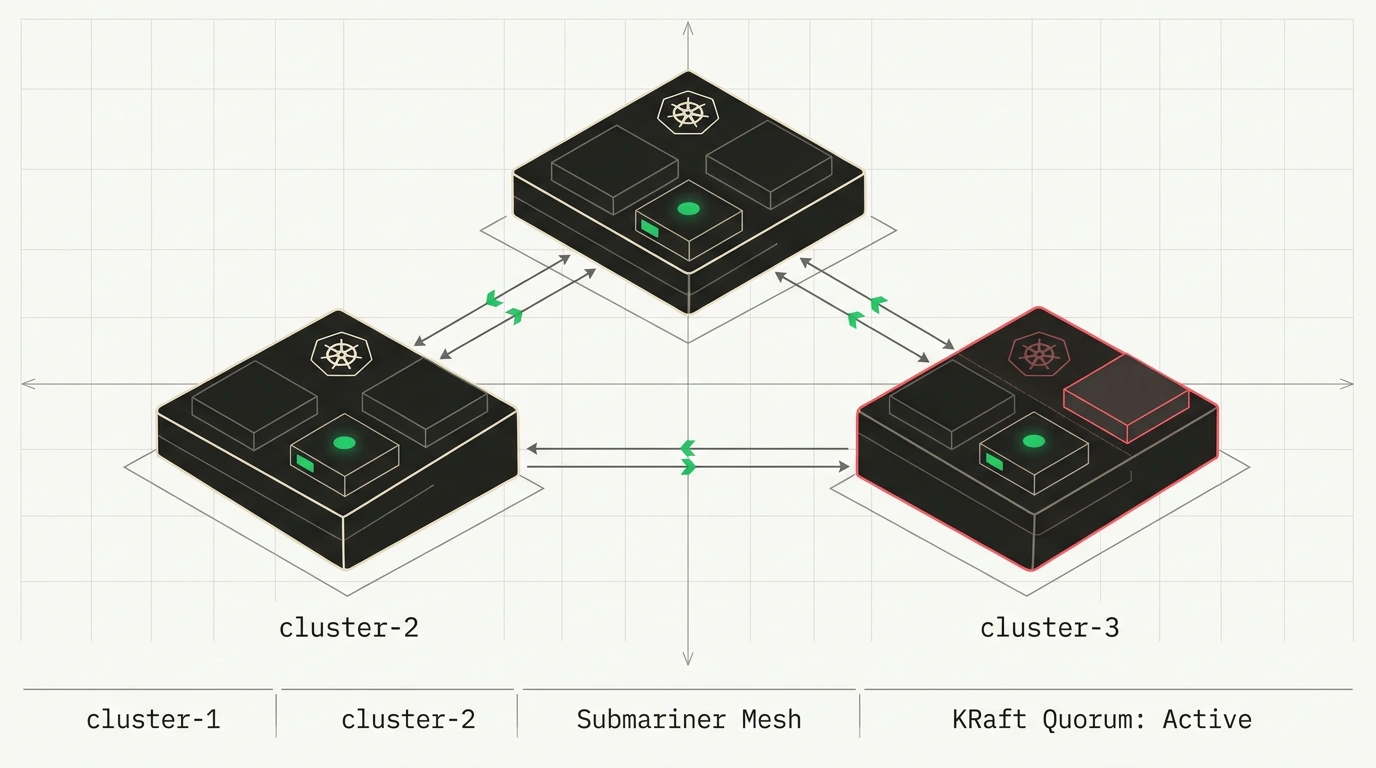


Если ты настраивал аварийное восстановление для распределённых очередей, то знаешь главную проблему: пока инфраструктура живёт внутри одного кластера Kubernetes, любая авария control plane мгновенно укладывает брокеры. Приложения теряют буфер событий, а бизнес терпит убытки. Мы подробно разбирали эту проблему в материале об архитектуре надежных распределенных очередей на базе Apache Kafka.
Обычно для защиты поднимают резервный кластер и натравливают утилиту MirrorMaker 2 для фоновой синхронизации топиков. Но асинхронная репликация — это всегда компромисс: при внезапной аварии последняя порция данных теряется (RPO > 0), а консьюмеров приходится переключать вручную, выравнивая смещения партиций.
Инженер Асвин (Staff Software Engineer в IBM) проверил на практике альтернативу: растянутый кластер (stretched cluster), где единый ансамбль Apache Kafka распределён сразу по трём независимым K8s-кластерам. Клиенты работают с единой точкой входа, а потеря датацентра обрабатывается кворумом за секунды.
Архитектура без шлюзов: Strimzi, Submariner и Cilium
Брокерам Kafka требуется прямое соединение pod-to-pod по внутренним IP-адресам без двойных NAT и ingress-прокси. Связка трёх open-source инструментов решает задачу чисто:
- Submariner: поднимает IPsec/WireGuard туннели между overlay-сетями кластеров. Поды в
cluster-1связываются с подами вcluster-2иcluster-3напрямую по их IP. - Cilium ClusterMesh: eBPF-ядро транслирует DNS-имена брокеров через Multi-Cluster Services без накладных расходов на переключение контекста.
- Strimzi: в центральном кластере работает Cluster Operator, а на удалённых площадках — локальные агенты, управляющие ресурсами
StrimziPodSets, исключая конфликт операторов.
Объединение сетей через CLI subctl выполняется в три шага:
# Развёртываем брокер конфигурации в первом кластере
subctl deploy-broker --kubeconfig kubeconfig-cluster1

# Подключаем площадки к общей overlay-сети
subctl join --kubeconfig kubeconfig-cluster1 broker-info.subm --clusterid cluster-1
subctl join --kubeconfig kubeconfig-cluster2 broker-info.subm --clusterid cluster-2
subctl join --kubeconfig kubeconfig-cluster3 broker-info.subm --clusterid cluster-3

# Проверяем связность pod-to-pod
subctl verify --kubeconfig kubeconfig-cluster1 --tocontext cluster-2
Кворум KRaft и сетевые грабли CNI
Второй кит надёжности — режим KRaft. Три контроллера кворума распределяются по одному на каждый K8s-кластер. При отказе одного датацентра в строю остаются два голосующих узла из трёх, сохраняя рабочий кворум.
Пулы брокеров описываются манифестом KafkaNodePool с привязкой к зонам:
apiVersion: kafka.strimzi.io/v1beta2
kind: KafkaNodePool
metadata:
  name: pool-cluster1
  namespace: kafka
spec:
  replicas: 1
  roles:
    - controller
    - broker
  template:
    pod:
      affinity:
        nodeAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
            nodeSelectorTerms:
              - matchExpressions:
                  - key: topology.kubernetes.io/zone
                    operator: In
                    values:
                      - zone-a
Топики с replication.factor: 3 и min.insync.replicas: 2 продолжают подтверждать запись с acks=all без потери данных.
Два критических нюанса:
- Задержка сети (RTT): схема рассчитана на Multi-AZ с пингом до 10–15 мс; межконтинентальное распределение обрушит скорость записи.
- Удаление подов в Cilium: по умолчанию интерфейс пода удаляется немедленно, и брокер не успевает передать лидерство партиций. Обязательно включайте фоновое освобождение ресурсов (background deletion).