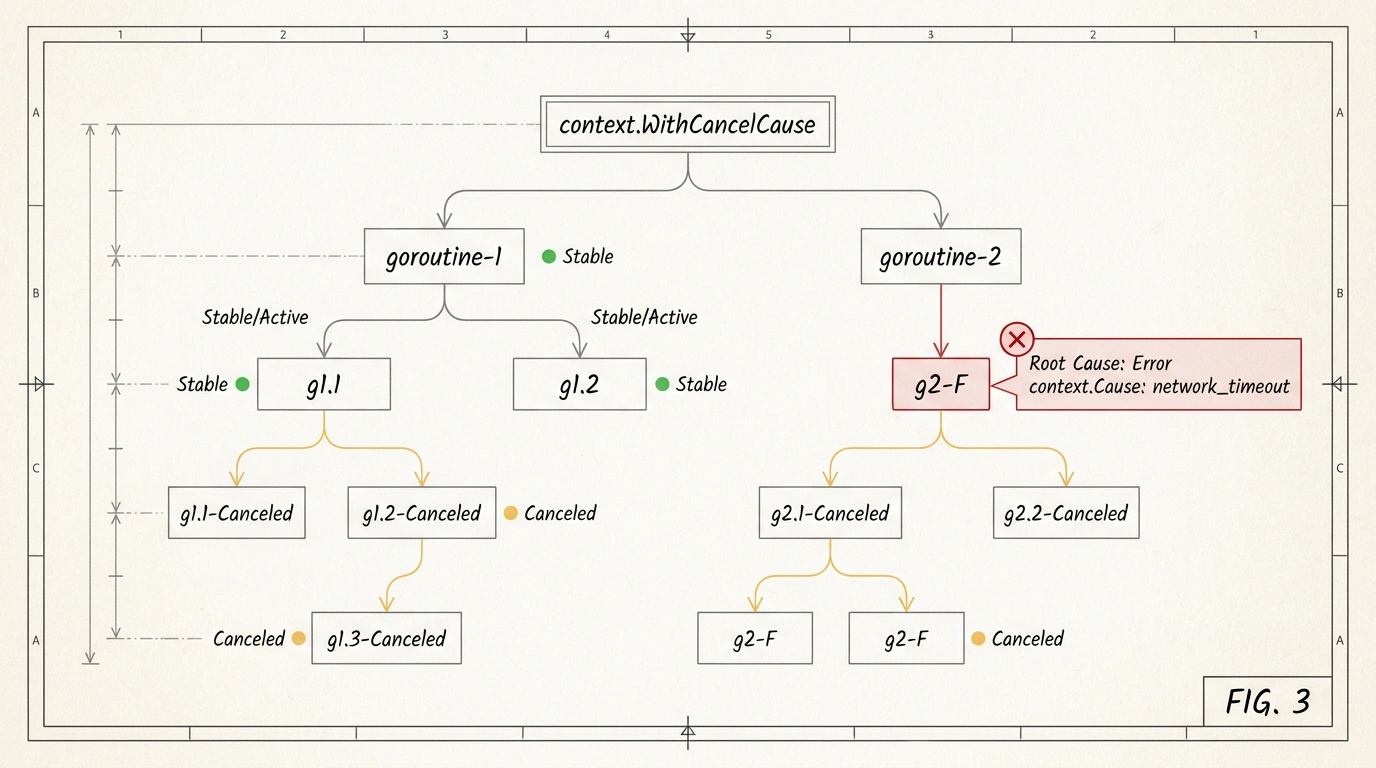

Представь классическую ситуацию в продакшене: распределенный бэкенд на Go обрабатывает пачку параллельных задач в пуле горутин. Вдруг сервис начинает сбоить, срабатывает аварийный останов, и система тушит все связанные операции. Ты открываешь логи мониторинга или трассировки в Sentry и видишь стену из сотен одинаковых сообщений: context canceled.
Что послужило первопричиной? Упало соединение с базой данных PostgreSQL? Внешний платежный шлюз не ответил за отведенный интервал? Или операционная система прислала сигнал SIGTERM в рамках плановой раскатки пода в Kubernetes?
Стандартный интерфейс отмены контекстов в Go годами скрывал реальную картину сбоев. Давай разберемся, как функция context.WithCancelCause и метод context.Cause возвращают диагностике прозрачность и почему это меняет культуру обработки ошибок в многопоточных бэкендах.
Ловушка обезличенной ошибки: почему context.Canceled скрывает первопричину
Пакет context — краеугольный камень конкурентного программирования в Go. Начиная с версии Go 1.7, канонический паттерн отмены выглядел предельно просто: вызываем ctx, cancel := context.WithCancel(parent) и передаем функцию cancel() в горутины или отложенный блок defer.
Когда одна из горутин вызывает cancel(), в структуре контекста закрывается канал Done(), и метод ctx.Err() начинает возвращать стандартную константу context.Canceled.
Для простых консольных утилит этого было вполне достаточно. Но в микросервисах с десятками параллельных пайплайнов возникает фатальная потеря контекста:
- Если одна горутина в группе падает из-за сетевого сбоя и инициирует закрытие общего контекста, остальные горутины завершаются с обезличенной формулировкой
context canceled. - Код верхнего уровня не может программно отличить штатный graceful shutdown от аварии критического воркера, чтобы выполнить выборочный перезапуск или отправить точный алерт дежурному инженеру.
- В системах распределенной трассировки OpenTelemetry сотни зависимых спанов помечаются как отмененные без привязки к корневому спану-виновнику (root cause).
Разработчикам приходилось изобретать собственные структуры-обертки с sync.Mutex или передавать ошибки через отдельные буферизованные каналы, что утяжеляло код и шло вразрез со стандартными интерфейсами языка.
Механика WithCancelCause: первый зарегистрированный сбой всегда побеждает
В версии Go 1.20 команда ядра языка представила долгожданное решение: функцию context.WithCancelCause и парный метод извлечения ошибки context.Cause.
Главное новшество кроется в сигнатуре возвращаемой функции отмены:
type CancelCauseFunc func(cause error)
Вместо вызова cancel() без аргументов теперь передается конкретная ошибка: cancel(ErrDatabaseConnectionLost).
Внутри рантайма Go создается специализированный узел контекстного дерева cancelCtx, хранящий внутреннее поле cause error. Механизм работает по следующим строгим правилам:
- Иммутабельность первой причины (First Cause Wins): Если первая горутина вызвала отмену с ошибкой
ErrWorkerFailed, а через пару миллисекунд фоновый процесс прислалErrShutdownInProgress, сохраненная причина не перезаписывается. Функцияcontext.Cause(ctx)гарантированно вернет именно ту ошибку, которая первой спровоцировала каскадное закрытие контекста. - Обратная совместимость: Вызов метода
ctx.Err()по-прежнему возвращает привычныйcontext.Canceled. Существующий код, проверяющийerrors.Is(ctx.Err(), context.Canceled), продолжает работать без малейших изменений. - Поиск по иерархии предков: Если дочерний контекст был создан через обычный
context.WithCancelот родителя сWithCancelCause, вызовcontext.Cause(childCtx)поднимется по дереву вверх и найдет исходную причину отмены предка. - Безопасность при nil: Если отмена была вызвана без параметров или через обычный
cancel(), функцияcontext.Cause(ctx)вернет стандартныйcontext.Canceled. Если контекст все еще активен и не был отменен, метод возвращаетnil.
Расширение для дедлайнов: WithTimeoutCause и точная диагностика сетевых шлюзов
В релизе Go 1.21 функциональность расширили на контексты с временными лимитами. Раньше при срабатывании тайм-аута метод ctx.Err() всегда возвращал стандартную ошибку context.DeadlineExceeded.
Функция context.WithTimeoutCause позволяет связать истечение таймера со смысловой бизнес-ошибкой:
var ErrBillingTimeout = errors.New("платежный шлюз не ответил за 3000 мс")

ctx, cancel := context.WithTimeoutCause(parentCtx, 3*time.Second, ErrBillingTimeout)
defer cancel()
Если тайм-аут истек, ctx.Err() вернет context.DeadlineExceeded, но вызов context.Cause(ctx) отдаст ErrBillingTimeout. В обработчике ошибок ты можешь сразу определить, какой именно интеграционный шлюз подвел систему, не заглядывая в стек вызовов.
Практический паттерн: надежный Graceful Shutdown пула воркеров без потери контекста
Давай соберем полноценный рабочий пример сервиса. Мы создадим пул фоновых воркеров, где падение одного критического воркера останавливает всю группу с сохранением первопричины, а сигнал операционной системы корректно обрабатывается верхнеуровневым супервизором.
Если тебя интересует глубинная работа очередей выполнения под капотом, вспомни, как анатомия планировщика Go распределяет горутины по системным потокам:
package main

import (
    "context"
    "errors"
    "fmt"
    "os"
    "os/signal"
    "syscall"
    "time"
)

var (
    ErrSignalShutdown = errors.New("штатная остановка по сигналу ОС")
    ErrWorkerPanic    = errors.New("критический сбой фонового воркера")
)

type WorkerPool struct {
    ctx    context.Context
    cancel context.CancelCauseFunc
}

func NewWorkerPool(parent context.Context) *WorkerPool {
    ctx, cancel := context.WithCancelCause(parent)
    return &WorkerPool{ctx: ctx, cancel: cancel}
}

func (wp *WorkerPool) RunWorker(id int) {
    for {
        select {
        case <-wp.ctx.Done():
            cause := context.Cause(wp.ctx)
            fmt.Printf("[Воркер %d] Остановка. Исходная причина: %v (стандартный Err: %v)\n",
                id, cause, wp.ctx.Err())
            return
        default:
            time.Sleep(100 * time.Millisecond)
            if id == 2 {
                // Имитируем критический сбой воркера номер 2
                wp.cancel(fmt.Errorf("%w: обрыв соединения с брокером сообщений", ErrWorkerPanic))
                return
            }
        }
    }
}

func main() {
    // Перехватываем сигналы прерывания от ОС
    rootCtx, stop := signal.NotifyContext(context.Background(), os.Interrupt, syscall.SIGTERM)
    defer stop()

    pool := NewWorkerPool(rootCtx)

    for i := 1; i <= 3; i++ {
        go pool.RunWorker(i)
    }

    <-pool.ctx.Done()

    // Анализируем причину завершения на уровне супервизора
    cause := context.Cause(pool.ctx)
    if errors.Is(cause, ErrWorkerPanic) {
        fmt.Printf("Аварийное завершение сервиса: %v\n", cause)
    } else if errors.Is(cause, context.Canceled) && rootCtx.Err() != nil {
        fmt.Println("Штатная остановка по системному сигналу пользователя")
    } else {
        fmt.Printf("Сервис остановлен с причиной: %v\n", cause)
    }
}
Обрати внимание на проверку через errors.Is. Поскольку ошибка воркера обернута через директиву %w, вызывающий код без труда распаковывает цепочку причин и принимает архитектурное решение: перезапустить упавший воркер или погасить весь контейнер с кодом ошибки.
Такой подход полностью исключает «слепые пятна» в продакшене: каждая отмененная операция в логах теперь имеет четкое имя, причину и виновника.