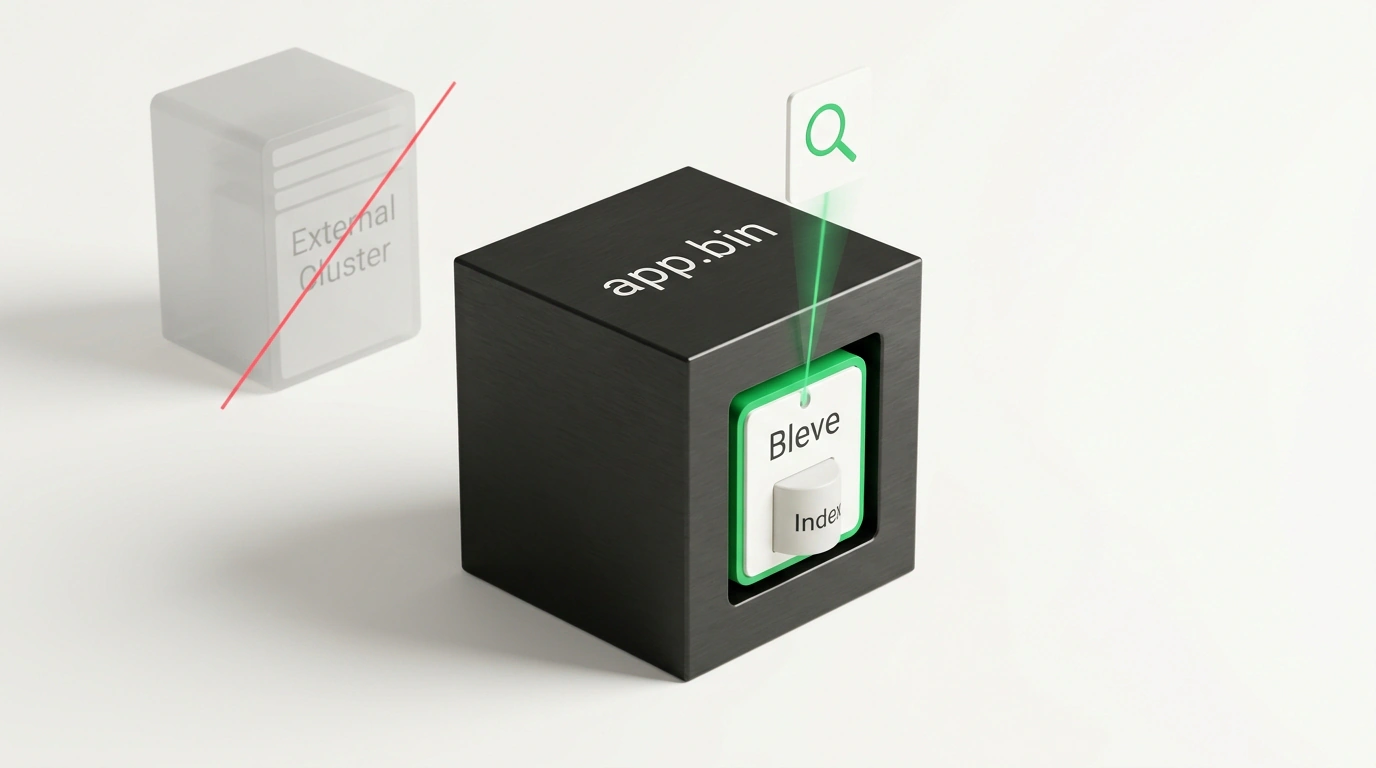

Представь типичную задачу: ты пишешь микросервис или CLI-утилиту на Go для каталога товаров, корпоративной базы знаний или локальной документации. В проекте пара десятков тысяч документов, и пользователям нужен быстрый, качественный поиск с поддержкой русской морфологии, опечаток и фасетов.
Как решает эту задачу среднестатистическая команда? Затаскивает в архитектуру отдельный кластер Elasticsearch, OpenSearch или поднимает рядом контейнер с Meilisearch. И вместе с решением получает классический набор инфраструктурных радостей: прожорливый JVM-рантайм, утилизацию пары гигабайтов оперативной памяти на холостом ходу, сетевые раундтрипы на каждый поисковый запрос и необходимость настраивать мониторинг еще одной распределенной системы.
Но что, если полноценный поисковый движок промышленного уровня можно скомпилировать прямо в твой единственный бинарный файл без CGo-зависимостей и внешних демонов?
Именно эту задачу решает библиотека Bleve, активно развивающаяся под эгидой Couchbase. Подробная документация проекта доступна на официальном сайте blevesearch.com. В актуальной стабильной ветке v2.5.7 библиотека предоставляет современный движок сегментного хранения Scorch и богатые анализаторы текста.
Как завести поиск в памяти или на диске за 30 строк
Главное преимущество Bleve — чистая идиоматическая архитектура на Go. Ты можешь скармливать индексатору любые произвольные структуры данных (struct) или сырые срезы JSON.
# Добавляем современную версию Bleve v2 в проект
go get github.com/blevesearch/bleve/v2
Смотри, как выглядит инициализация индекса с подключением встроенного стеммера русского языка:
package main

import (
    "fmt"
    "log"

    "github.com/blevesearch/bleve/v2"
    "github.com/blevesearch/bleve/v2/analysis/lang/ru"
    "github.com/blevesearch/bleve/v2/mapping"
)

type KnowledgeArticle struct {
    ID      string `json:"id"`
    Title   string `json:"title"`
    Content string `json:"content"`
}

func buildCustomMapping() mapping.IndexMapping {
    indexMapping := bleve.NewIndexMapping()

    // Настраиваем маппинг документа с поддержкой русской морфологии
    docMapping := bleve.NewDocumentMapping()
    contentField := bleve.NewTextFieldMapping()
    contentField.Analyzer = ru.PluginName // Стеммер Snowball для русского языка
    docMapping.AddFieldMappingsAt("content", contentField)

    indexMapping.AddDocumentMapping("article", docMapping)
    return indexMapping
}

func main() {
    // Индекс можно держать в памяти (NewMemOnly) или на диске через BoltDB/Badger
    index, err := bleve.NewMemOnly(buildCustomMapping())
    if err != nil {
        log.Fatalf("Ошибка создания индекса: %v", err)
    }
    defer index.Close()

    // Индексируем документ
    doc := KnowledgeArticle{
        ID:      "kb-101",
        Title:   "Параллелизм в Go",
        Content: "Конкурентные горутины обмениваются сообщениями через типизированные каналы.",
    }
    if err := index.Index(doc.ID, doc); err != nil {
        log.Fatalf("Ошибка индексации: %v", err)
    }

    // Ищем по начальной форме слова: стеммер свяжет «горутинами» и «горутина»
    query := bleve.NewMatchQuery("горутина")
    searchRequest := bleve.NewSearchRequest(query)
    searchResult, err := index.Search(searchRequest)
    if err != nil {
        log.Fatalf("Ошибка поиска: %v", err)
    }

    fmt.Printf("Найдено совпадений: %d\n", searchResult.Total)
    for _, hit := range searchResult.Hits {
        fmt.Printf("Документ: %s, Релевантность: %.4f\n", hit.ID, hit.Score)
    }
}
Векторный поиск и эксплуатационные компромиссы
Современный Bleve — это не просто поиск по ключевым словам. В ветке v2.5 появилась нативная поддержка k-NN векторного поиска (Vector Search), что позволяет строить гибридные поисковые пайплайны: традиционный стемминг слов плюс эмбеддинги от нейросетевых моделей для поиска по смыслу.
Но при выборе Bleve важно трезво оценивать архитектурные границы:
- Одноузловой движок (Single Node): Bleve спроектирован для встраивания в один процесс. Если твоей системе требуется шардирование индекса на десятки серверов с терабайтами данных, классический кластерный поиск останется неизбежным выбором.
- Блокировки при конкурентной записи: хотя движок Scorch оптимизирован под быстрое сегментное слияние (segment merging), при параллельной записи из сотен горутин в дисковый бэкенд на базе BoltDB неизбежны блокировки файлового дескриптора. Для высоконагруженных очередей обновлений рекомендуется собирать документы в пачки через
bleve.NewBatch().
Для автономных десктопных утилит, компактных сервисов и локальных инструментов Bleve снимает огромный пласт инфраструктурных проблем, возвращая разработке простоту одного самодостаточного бинарника.