
Если ты хотя бы пару лет администрировал серверы Linux или развертывал бэкенд-приложения, то синтаксис crontab наверняка отпечатался у тебя на подкорке. Знаменитые пять звездочек — * * * * *, за которыми следует shell-команда или путь к скрипту, стали универсальным языком планирования фоновых заданий еще в конце семидесятых годов прошлого века, когда Кен Томпсон создал первую реализацию cron для Unix Version 7.
Четыре десятилетия подряд этот механизм честно выполнял свою работу: запускал ротацию логов, генерировал ночные дампы баз данных, отправлял дайджесты на электронную почту и очищал временные каталоги. Но давай на секунду снимем ностальгические очки и трезво посмотрим на то, как устроен классический cron в современной облачной инфраструктуре с десятками микросервисов, распределенными хранилищами и контейнерами.
Картина оказывается, мягко говоря, удручающей. В дистрибутивах Linux на базе системы инициализации systemd (Ubuntu, Debian, RHEL, CentOS, Rocky Linux, Fedora, Arch Linux, openSUSE) уже более десяти лет присутствует полноценная нативная альтернатива — таймеры systemd. Но по старой памяти сотни команд продолжают наступать на грабли crontab.
Подробный образовательный разбор механизма подготовил автор в канале «Linux | Network | DevOps», опираясь на официальное руководство по юнитам systemd.timer и спецификацию временных форматов systemd.time. Пришло время разобрать эту подсистему до основания и понять, почему современный production заслуживает чего-то большего, чем архаичные строчки в /etc/crontab.
Почему четыре десятилетия cron зашли в архитектурный тупик
Давай препарируем реальный инцидент, с которым сталкивался каждый дежурный инженер. Представь: на сервере настроен ночной дамп базы данных PostgreSQL в 03:00. В три часа ночи демон cron запускает команду. Но именно в эту минуту сетевое хранилище NFS временно перемонтировалось, или служба базы данных перезагружалась после планового обновления пакетов.
Что происходит в мире классического cron?
- Тихий провал и потерянные логи: скрипт падает с ошибкой в stderr. Куда уходит этот вывод? По умолчанию cron пытается отправить локальное письмо через утилиту
sendmailилиmailxпользователю root. Но на современных серверах локальный почтовый сервер (MTA) либо вообще не установлен, либо письма годами копятся в каталоге/var/mail/root, который никто никогда не открывает. В результате бэкап не создался, а команда узнает об этом спустя две недели, когда база упала, а восстанавливать нечего. - Слепота к перезагрузкам и техническим окнам: если физический сервер или виртуальная машина находились в перезагрузке ровно в 03:00, cron просто проигнорирует факт наступления события. Наступило 03:05? Время ушло, поезд уехал, до следующей ночи бэкапа не будет.
- Отсутствие управления ресурсами: задача, запущенная из cron, порождается как рядовой дочерний процесс в общем пространстве пользователей. Если в скрипте случилась утечка памяти или бесконечный цикл, процесс сожрет 100% процессора и убьет боевое приложение соседней службой Out-Of-Memory Killer.
- Невозможность объявить зависимости: в crontab нельзя декларативно сказать: «Не запускай скрипт, пока сеть не поднимется, диск не смонтируется, а база не ответит на пинг». Инженерам приходится громоздить в bash костыли с бесконечными циклами
sleepи проверками сетевых портов.
В парадигме systemd все эти проблемы решены на фундаментальном архитектурном уровне.
Архитектура парных юнитов: жесткое разделение расписания и процесса
Главное концептуальное отличие systemd от cron — это строгое разделение ответственности.
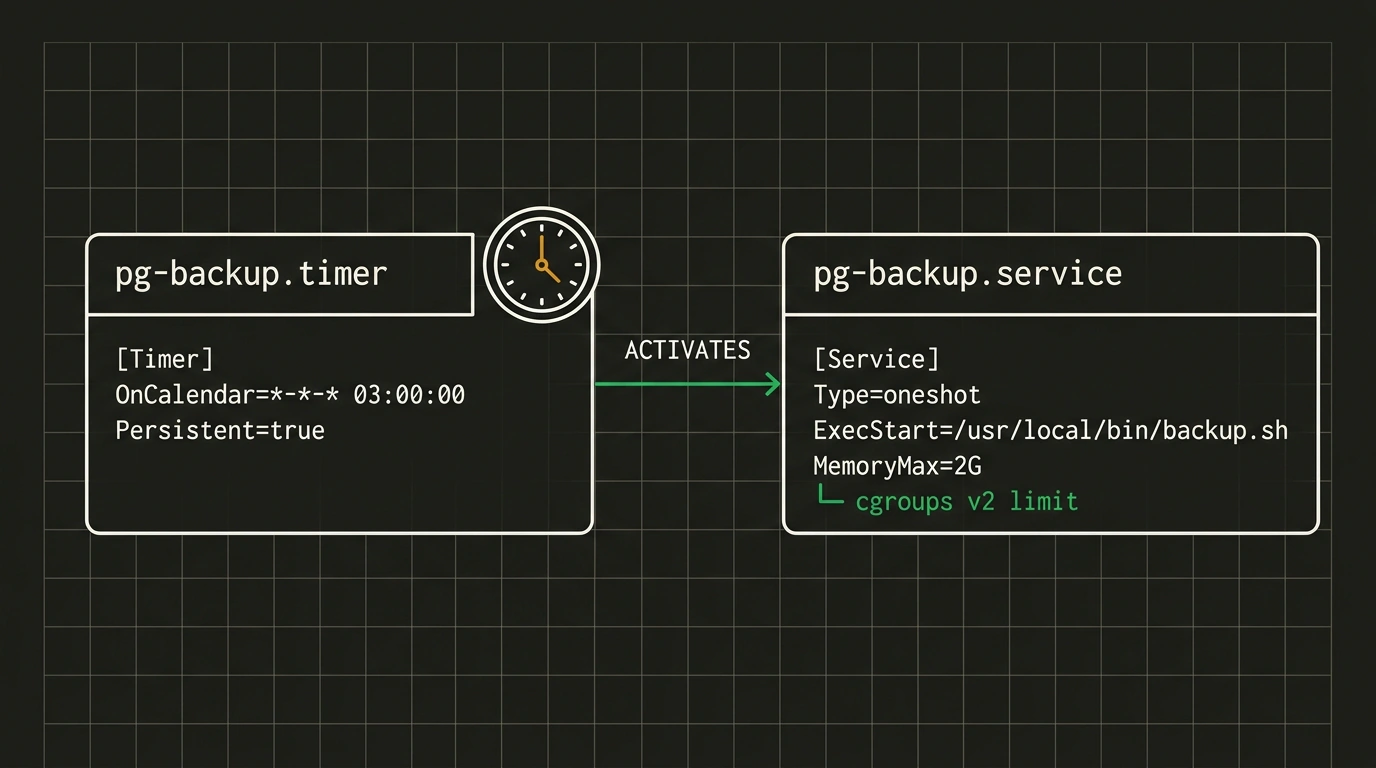
В cron расписание запуска и само тело исполняемой команды спрессованы в одну нечитаемую строку. В systemd периодическая задача всегда делится на два независимых файла-юнита:
- Сервисный юнит (
.service): отвечает на вопрос ЧТО ДЕЛАТЬ. Здесь описывается сам рабочий процесс: исполняемый бинарник, скрипт, рабочий каталог, системный пользователь, переменные окружения, лимиты памяти, права доступа к файловой системе и правила поведения при сбоях; - Таймер-юнит (
.timer): отвечает на вопрос КОГДА И ПРИ КАКИХ УСЛОВИЯХ ЗАПУСКАТЬ. Здесь задаются временные интервалы, привязка к часам или событиям загрузки операционной системы, а также правила компенсации пропущенных запусков.
По умолчанию таймер ищет одноименный сервис: если юнит называется pg-backup.timer, systemd автоматически активирует сервис pg-backup.service в том же каталоге.
Давай посмотрим, как выглядит надежный сервисный юнит для разовой задачи. Обрати внимание на тип Type=oneshot:
# /etc/systemd/system/pg-backup.service
[Unit]
Description=Резервное копирование PostgreSQL в локальный архив
# Декларативные зависимости: ждем доступности сети и локальной службы СУБД
After=network-online.target postgresql.service
Wants=network-online.target postgresql.service

[Service]
Type=oneshot
User=postgres
Group=postgres
WorkingDirectory=/var/lib/postgresql
ExecStart=/usr/local/bin/backup-database.sh

# Логирование: весь стандартный вывод и ошибки автоматически направляются в journald
StandardOutput=journal
StandardError=journal

# Жесткие ограничения cgroups v2: защищаем соседние сервисы
MemoryMax=2G
CPUQuota=50%
А теперь создаем парный таймер, который будет управлять расписанием этого сервиса:
# /etc/systemd/system/pg-backup.timer
[Unit]
Description=Таймер ночного резервного копирования базы данных

[Timer]
# Календарное расписание: каждую ночь ровно в 03:00
OnCalendar=*-*-* 03:00:00

# Главная магия: наверстать запуск, если сервер был выключен в 03:00
Persistent=true

# Случайный джиттер: размываем пиковую нагрузку на диск в пределах 15 минут
RandomizedDelaySec=15m

[Install]
# Таймер активируется при старте базовой системной цели для таймеров
WantedBy=timers.target
Чтобы расписание ожило, достаточно выполнить стандартную команду инициализации:
# Перечитываем конфигурацию systemd и активируем таймер
systemctl daemon-reload
systemctl enable --now pg-backup.timer
Монотонные против календарных: как таймеры дружат с ядром и часами
В классическом cron любое расписание жестко привязано к системным астрономическим часам. Если на сервере рассинхронизировалось время, или системный администратор вручную перевел стрелки часов на час назад, cron может либо сработать дважды, либо пропустить запуск.
В systemd существует четкое разделение таймеров на два принципиально разных класса:
1. Монотонные таймеры (Monotonic Timers)
Они привязаны не к настенному времени, а к монотонным аппаратным часам ядра Linux (CLOCK_MONOTONIC). Эти часы тикают строго вперед с момента старта процессора, их невозможно перевести назад или сбить некорректным NTP-пакетом.
Директивы монотонных таймеров идеально подходят для периодических интервальных задач:
OnBootSec=15min: запустить службу ровно через 15 минут после загрузки ядра операционной системы;OnUnitActiveSec=1h: повторять запуск через каждый час относительно момента предыдущей успешной активации сервиса;OnUnitInactiveSec=30min: выдерживать 30-минутную паузу после завершения работы предыдущего процесса.
Почувствуй колоссальную разницу: если твоя тяжелая задача очистки кэша выполнялась 40 минут, директива OnUnitInactiveSec=30min гарантирует, что следующий запуск произойдет ровно через 30 минут после окончания работы предыдущего, исключая опасное наложение процессов друг на друга без всяких внешних lock-файлов!
2. Календарные таймеры (Realtime / Calendar Timers)
Они работают по настенному времени (CLOCK_REALTIME) и настраиваются через директиву OnCalendar.
Синтаксис спецификации systemd.time на порядок выразительнее и человечнее, чем пять колонок crontab:
OnCalendar=hourly— каждый час в нулевую минуту;OnCalendar=daily— каждую полночь в 00:00:00;OnCalendar=Mon..Fri *-*-* 04:30:00— только по будням с понедельника по пятницу в четыре тридцать утра;OnCalendar=*-*-01 02:00:00— первого числа каждого месяца в два часа ночи;OnCalendar=*-*-* *:00/15:00— каждые пятнадцать минут любого часа.
Заметь: звездочки разделены дефисами и двоеточиями. Ошибиться в таком синтаксисе в десять раз сложнее, чем в череде пробелов между цифрами cron.
Анатомия Persistent=true: как наверстывать ночные бэкапы после сбоев
Одной из самых разрушительных проблем cron всегда была его полная амнезия при перезагрузках. Если виртуальная машина с dev- или stage-окружением тушится на ночь ради экономии ресурсов, утренние задачи бэкапа просто никогда не выполняются.
В systemd эту проблему элегантно решает одна-единственная директива:
Persistent=true
Давай заглянем, что происходит под капотом при включении этого флага:
- При каждом успешном запуске целевого сервиса менеджер systemd берет текущую временную метку и атомарно записывает её в специальный штамп-файл на диске по пути
/var/lib/systemd/timers/stamp-<имя-юнита>.timer. - Если в 03:00 ночи сервер был отключен, находился в аварийной перезагрузке или гипервизор проводил миграцию хоста, файл штампа сохраняет время вчерашнего старта.
- Как только сервер загружается (например, в 08:30 утра), systemd при инициализации цели
timers.targetсчитывает все штампы с диска и сравнивает их с календарем. - Видя, что расписание 03:00 было пропущено, systemd немедленно активирует просроченный сервис
pg-backup.service, не дожидаясь следующей ночи.
Этот механизм гарантирует, что критические регламентные процедуры будут выполнены хотя бы раз в запланированный период, даже если сервер регулярно отправляется в перезагрузку.
Прозрачная инспекция: systemd-analyze и диагностика без сторонних калькуляторов
Сколько раз перед сохранением файла crontab ты лез в онлайн-сервисы вроде crontab.guru, чтобы перепроверить, правильно ли расставлены звездочки и не запустится ли скрипт каждые две секунды вместо двух часов ночи?
В systemd встроен профессиональный диагностический инструментарий. Любое календарное выражение можно проверить прямо в терминале с помощью утилиты systemd-analyze calendar:
# Проверяем сложное календарное выражение перед добавлением в конфиг
systemd-analyze calendar "Mon..Fri *-*-* 03:00:00"
Команда возвращает исчерпывающий отчет:
Normalized form: Mon..Fri *-*-* 03:00:00
   Next elapse: Fri 2026-11-06 03:00:00 MSK
      (in UTC): Fri 2026-11-06 00:00:00 UTC
      From now: 13h left
Утилита показывает каноническую нормализованную форму, пересчитывает время в UTC и сообщает, сколько часов и минут осталось до следующего срабатывания.
А чтобы увидеть полную картину всех запланированных задач на всем сервере, достаточно выполнить:
systemctl list-timers --all
Команда выводит кристально ясную таблицу со столбцами:
- NEXT: точная дата и время следующего срабатывания;
- LEFT: оставшееся время до старта (например,
2h 45min left); - LAST: когда задача отрабатывала в последний раз;
- PASSED: сколько времени прошло с предыдущего выполнения;
- UNIT: имя активного таймер-юнита;
- ACTIVATES: имя сервиса, который будет вызван.
Никакой магии, никаких скрытых пользовательских crontab-файлов в /var/spool/cron/crontabs — вся инфраструктура расписаний видна как на ладони в едином интерфейсе.
Изоляция ресурсов cgroups v2 и одноразовые задачи через systemd-run
Еще один колоссальный козырь systemd — жесткий контроль аппаратных ресурсов через вторую версию контрольных групп ядра (cgroups v2).
В классическом cron запущенный скрипт работает без каких-либо лимитов. Если джуниор написал скрипт выгрузки отчета, забыв ограничить выборку в SQL-запросе, процесс выделит 30 ГБ оперативной памяти и обрушит стоящий рядом продакшен-кластер.
В сервисный юнит systemd мы можем добавить жесткие директивы изоляции:
[Service]
# Ограничиваем потребление памяти: жесткий потолок 2 ГБ
MemoryMax=2G
# Замедляем выделение памяти при превышении порога 1.5 ГБ
MemoryHigh=1.5G
# Ограничиваем процессорное время: не более одного ядра (100%)
CPUQuota=100%
# Приоритет ввода-вывода: задача бэкапа не должна подвешивать диск
IOWeight=100
Если процесс попытается превысить лимит MemoryMax, ядро аккуратно прибьет только дочерний процесс скрипта, сохранив жизнь основной системе. А весь ход исполнения и ошибки будут аккуратно сложены в системный журнал:
# Читаем детальный лог выполнения конкретной задачи за последние сутки
journalctl -u pg-backup.service --since "yesterday"
А что делать, если тебе нужно запустить временную одноразовую задачу без ручного создания файлов на диске? Для этого существует потрясающая команда systemd-run:
# Запустить тяжелый скрипт через 20 минут в изолированном контексте с лимитом памяти
systemd-run --on-active=20m --property=MemoryMax=1G /usr/local/bin/heavy-maintenance.sh
Утилита сама сгенерирует временный транзиентный юнит в оперативной памяти, выполнит команду и удалит описание после завершения.
Практический чек-лист миграции и производственные компромиссы
Переход с crontab на systemd timers — это не просто смена инструмента, а качественный скачок в зрелости серверной инфраструктуры. Давай зафиксируем основные шаги перехода:
- Инвентаризация старых задач: просмотри содержимое
/etc/crontab, каталогов/etc/cron.d/, а также пользовательских расписанийcrontab -l. - Формирование шаблонов: создай базовые сервисные юниты в
/etc/systemd/system/, явно указав рабочие директории, системных пользователей и декларативные зависимости (After=network-online.target). - Настройка календаря и джиттера: для задач, работающих на нескольких серверах параллельно, обязательно используй директиву
RandomizedDelaySec=10m. Это предотвратит одновременную бомбардировку внешних API или дисковых массивов (так называемый thundering herd problem). - Валидация через systemd-analyze: перед активацией прогони каждое расписание через анализатор календаря.
Разумеется, у systemd timers есть и своя цена: вместо редактирования одного текстового файла в nano тебе приходится создавать два отдельных файла юнитов. Но для промышленного продакшена эта небольшая многословность с лихвой окупается прозрачностью, надежностью логирования и гарантией того, что твои ночные задачи действительно отработают штатно.