
В мире реляционных баз данных существует священный грааль высокой производительности: читатели никогда не должны блокировать писателей, а писатели ни при каких обстоятельствах не должны заставлять ждать читателей.
Если бы каждый запрос SELECT вешал разделяемую блокировку на всю таблицу или строку, а каждый UPDATE замораживал чтение, ни один современный интернет-магазин или социальная сеть не выдержали бы и секунды реальной нагрузки. Для решения этого конфликта была придумана концепция многоверсионного управления конкурентным доступом — MVCC (Multi-Version Concurrency Control).
Идея проста: когда транзакция начинает чтение данных, она фиксирует моментальный снимок базы (Snapshot или Read View) и видит состояние строк строго на этот момент, игнорируя параллельные изменения других пользователей.
Но вот что поражает воображение: две главные реляционные СУБД современного веба — MySQL (с движком InnoDB) и PostgreSQL — реализовали этот принцип на диаметрально противоположных законах физики хранения данных.
Фундаментальный анализ этой разницы задокументировал бывший ведущий архитектор баз данных Twitter и Yahoo! Джереми Коул в своем исследовании, а детали параллелизма раскрывает официальная документация MVCC в PostgreSQL. Давай разберем оба подхода под капотом.
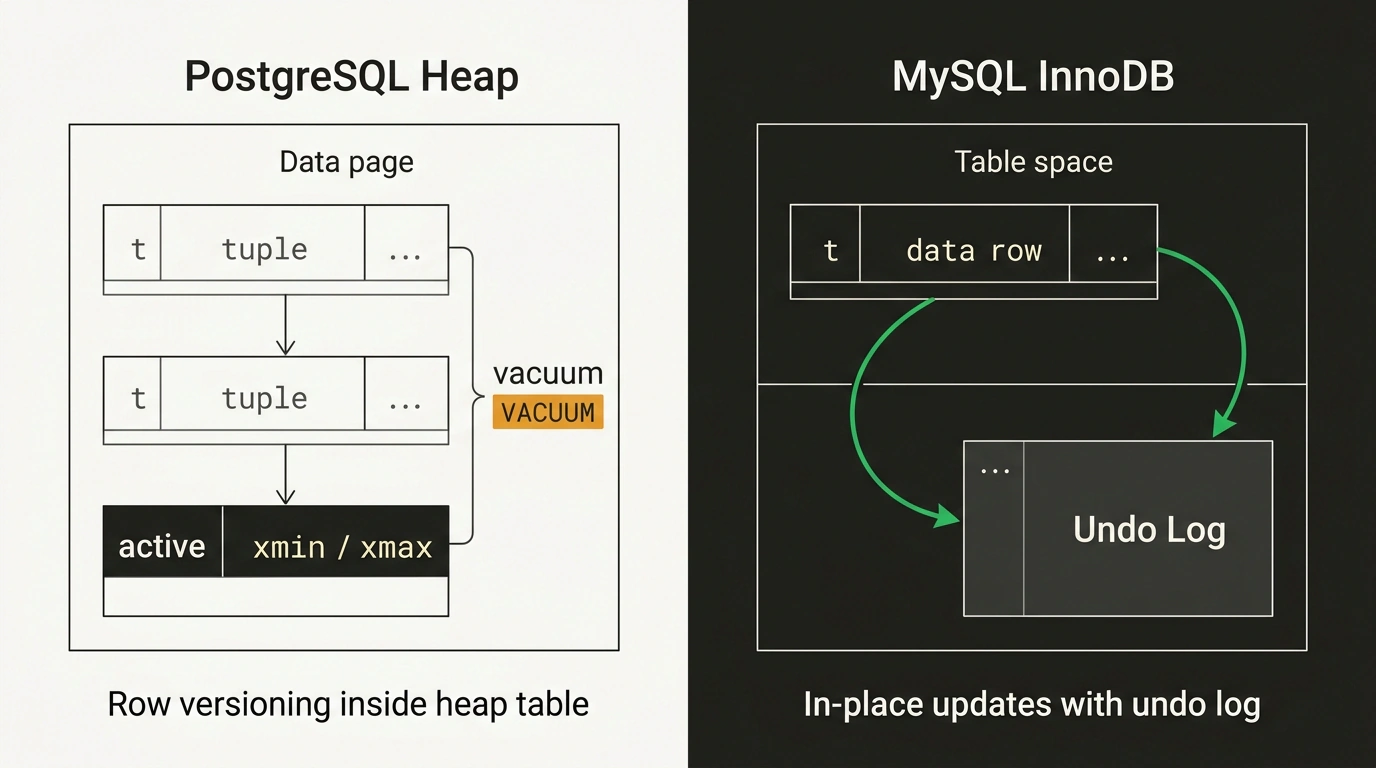
Модель InnoDB в MySQL: единственная живая строка и цепочка отката
Архитектура InnoDB исповедует принцип in-place update (обновление на месте):
- В первичном кластеризованном B-Tree индексе физически всегда хранится только одна актуальная версия строки;
- В заголовке каждой записи спрятаны два обязательных системных поля:
DB_TRX_ID(6 байт — идентификатор транзакции, создавшей или изменившей запись) иDB_ROLL_PTR(7 байт — указатель отката Rollback Pointer); - Когда транзакция выполняет операцию
UPDATE, старое значение строки копируется в специальное дисковое пространство отката — Undo Log, а запись в таблице перезаписывается новым значением прямо на месте. ПолеDB_ROLL_PTRпри этом начинает указывать на старую копию в Undo Log.
Если строка обновлялась пять раз подряд, в Undo Log выстраивается связный список (цепочка отката), ведущий от текущего состояния строки назад во времени.
Как работает чтение? Если читающая транзакция с более старым Read View обращается к строке и видит, что её DB_TRX_ID новее момента снимка, движок InnoDB на лету разматывает цепочку Undo Log в оперативной памяти, применяя обратные дельты и собирая для читателя снимок строки из прошлого.
А когда старые транзакции завершаются, фоновый системный процесс Purge сканирует список истории (History List Length, HLL) и освобождает ненужные сегменты Undo Log.
Модель PostgreSQL: множество версий кортежей прямо в табличной куче
Инженеры PostgreSQL пошли совершенно другим путем, выбрав модель append-only (только дозапись):
- В PostgreSQL нет отдельного пространства Undo Log для хранения исторических значений;
- При выполнении
UPDATEстарая строка вообще не перезаписывается. Вместо этого в физическую страницу таблицы (табличную кучу, heap page) записывается совершенно новый кортеж (новая версия строки); - Заголовок каждого кортежа содержит системные метаданные:
xmin(ID создавшей транзакции) иxmax(ID удалившей или обновившей транзакцию, для живой строки равен 0).
Старая версия строки остается лежать на своем месте в файле таблицы, но её поле xmax помечается идентификатором обновляющей транзакции.
Читающая транзакция просто сканирует страницу таблицы и на основе сравнения xmin и xmax со своим списком активных транзакций определяет, какие именно версии кортежей ей видны, а какие следует проигнорировать.
Но у этой простоты есть обратная сторона — раздувание таблиц (Table Bloat). По мере работы в таблицах накапливаются миллионы «мертвых кортежей» (dead tuples). Чтобы освободить место, PostgreSQL жизненно необходим фоновый демон autovacuum, который непрерывно обходит страницы, вычищает мертвые записи и обновляет карты свободного пространства.
Эксплуатационные последствия: за что ты платишь в продакшене
Разница в фундаментальном устройстве приводит к совершенно разному поведению баз под реальной нагрузкой:
1. Стоимость частых апдейтов (Write Amplification)
В MySQL обновление неиндексированных колонок обходится невероятно дешево: запись модифицируется на месте в оперативной памяти буферного пула, пишется короткая дельта в Undo Log, а вторичные индексы таблицы вообще не затрагиваются. В PostgreSQL любой апдейт создает новый кортеж. Это значит, что все вторичные индексы таблицы должны получить новые указатели на новую строку, если только не сработал специальный механизм оптимизации HOT (Heap-Only Tuples), требующий запаса свободного места на той же странице таблицы.
2. Ловушка длинных транзакций (Long-running Transactions)
Это главный кошмар любого DBA:
- В MySQL: если аналитик запустил тяжелый отчет или завис процесс резервного копирования в режиме
REPEATABLE READ, он удерживает старый Read View. Это полностью блокирует процесс Purge для всей базы данных! Метрика History List Length начинает расти до миллионов, системное пространствоibdata1или undo-табличные пространства раздуваются, а обычные запросыSELECTначинают тормозить в сотни раз, будучи вынужденными разматывать километровые цепочки отката. - В PostgreSQL: длинная открытая транзакция фиксирует системный порог
OldestXmin. Процесс VACUUM теряет право удалять любые мертвые кортежи, появившиеся после этого момента. В результате размер таблиц на диске растет в разы, буферный кэш забивается мусором, а база рискует упереться в исчерпание дискового пространства.
Трезвые выводы архитектора
Не существует «абсолютно лучшей» СУБД: каждый движок пожертвовал разным ради своих преимуществ.
InnoDB в MySQL идеально подходит для сценариев с безумной частотой точечных апдейтов по первичному ключу (счетчики, балансы, финансовые транзакции), но требует жесточайшего контроля над зависшими транзакциями и мониторинга History List Length.
PostgreSQL предоставляет невероятную гибкость расширений, сложных типов данных и индексации, но требует грамотной калибровки порогов autovacuum и понимания того, что каждая обновленная строка физически занимает место нового кортежа на диске. Понимание этой внутренней механики позволяет проектировать устойчивые схемы данных и не удивляться поведению баз в моменты пиковых нагрузок.