Edición 11 de noviembreDigest del día · 8 materiales
Qué hay en esta ediciónRevisamos 36 fuentes, reunimos 8 materiales
Escritorio con la carpeta minimalista de la habilidad billing-bugfix abierta sobre un fondo de pila de documentos innecesarios apartados
ArtículoIAAutomatizaciónPrácticaEficiencia

Combate a la saturación de habilidades en agentes de IA: por qué 100 habilidades externas rompen el contexto y cómo dejar solo 4–5 funcionales

Cuando metes en la carpeta .agents/skills/ ciento cincuenta instrucciones ajenas, parece que el agente se volverá más inteligente, hasta que una simple depuración de webhook quema 40,000 tokens antes incluso de leer el log de error. La culpa es de disparadores difusos en el campo description: el modelo toma frases genéricas sobre «código de calidad» como una orden y llena la memoria con decenas de páginas de reglas sobrantes.

Esto se cura con una revisión estricta del catálogo y reduciendo el conjunto global a 4–5 habilidades específicas. Pero la amenaza principal de las skills descargadas al azar ni siquiera se esconde en el consumo vacío de los límites de suscripción.
👍 26
David OndrejAgent Skills Open Specification — agentskills.ioDavid Ondrej GitHub Skills RepositoryCloudroom ADE
11 de noviembre
Corte arquitectónico de un lienzo digital con la interfaz monolítica del editor Photon, shaders y paleta de capas
ArtículoIAInteligencia artificialBenchmarksAnalítica

Lanzamiento de Claude Fable 5.2 de Anthropic: 1 millón de contexto, 128 mil tokens de salida y pruebas de estrés con artefactos interactivos

Parece que la tarifa doble de Claude Fable 5.2 ($10 de entrada y $50 de salida por millón de tokens) hace al buque insignia demasiado caro frente a la habitual Opus 5.5. Pero cuando construyes una aplicación compleja entera, ese recargo de repente ahorra presupuesto: el techo de 128,000 tokens de salida permite entregar todo el código en una sola pasada en lugar de diez empalmes manuales.

El modelo empaqueta por sí solo CPython en 13.9 MB para el navegador y logra 69.9 puntos en la prueba Frontier SWE 2.0. Solo que un filtro de seguridad demasiado celoso puede cortar a mitad de camino tu compilación de varias horas.

👍 27
Simon WillisonMatthew BermanNick SaraevAnthropic Claude API Reference and Specifications
11 de noviembre
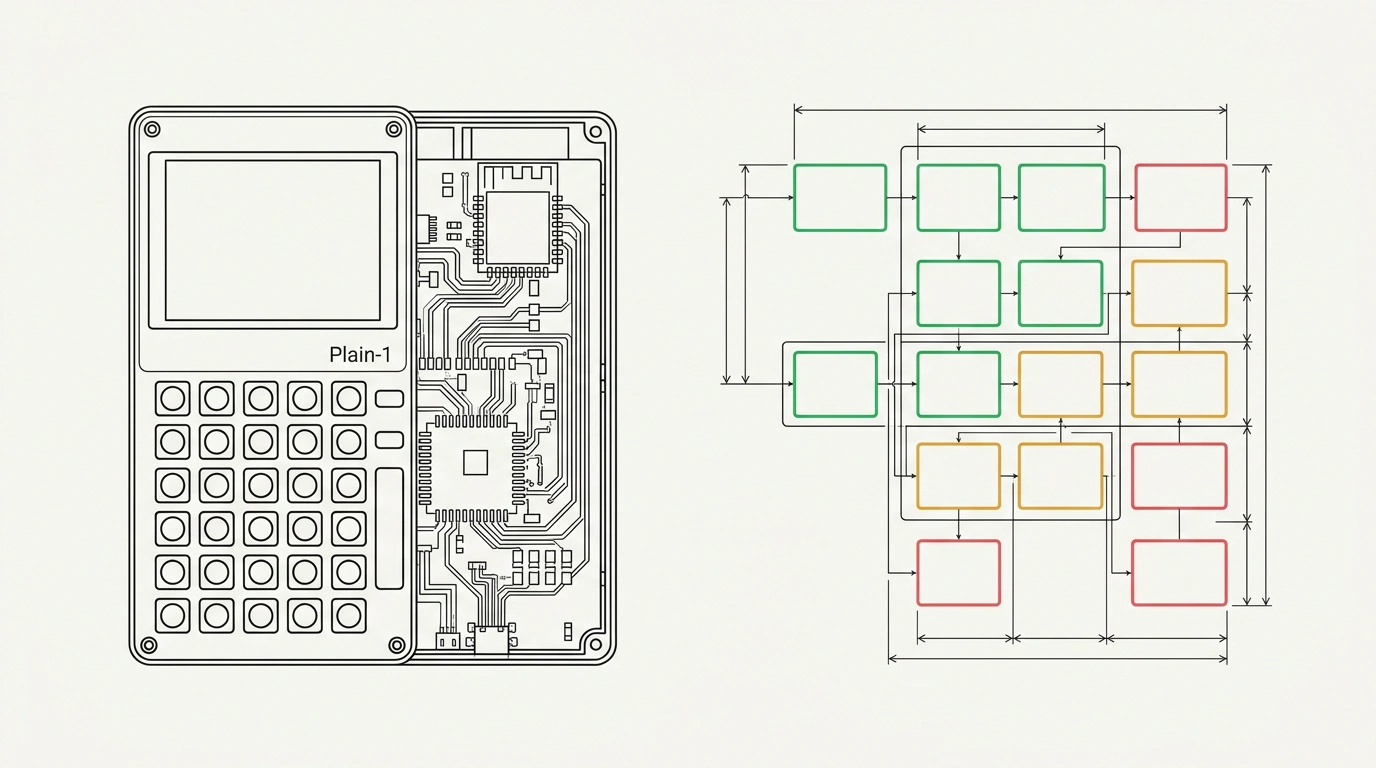
Plano de patente y esquema del teléfono minimalista de botones Plain-1 junto a una matriz de analítica en abanico
NotaIANegociosAutomatizaciónEstrategia

12 escenarios aplicados para Claude Fable 5.2: auditoría autónoma de negocios, barrido de 100 nichos y prototipado de dispositivos

En Claude Fable 5.2, la capacidad de reconocer la falta de hechos y mantener el objetivo 10–12 horas elevó la tasa de cierre de pedidos del 21% al 41%, abriendo nuevas clases de tareas de negocio para tus agentes:

  • Auditoría de P&L y operaciones etiquetando cifras con los estados verified, unverified y suspicious sin conjeturas.
  • Barrido en abanico de 100 nichos mediante subagentes en paralelo consolidando quejas y tickets en una matriz común.
  • Diseño de dispositivos desde un solo prompt, hasta el esquema de placa y firmware del teléfono 4G Plain-1.

Pero sin puntos de guardado ni freno de emergencia antes de pagar, esa autonomía falla rápido.

👍 8
Greg IsenbergLate Checkout Agency — AI Product Incubator
11 de noviembre
Póster minimalista con el gráfico de la frontera de Pareto y prismas geométricos en equilibrio
NotaIAInteligencia artificialEficienciaAlgoritmos

Muse Ember de Meta: modelo compacto de razonamiento en la frontera de Pareto por precio y velocidad

Al armar un pipeline de agentes eliges entre dos estrategias: pasar todas las tareas por un modelo pesado o delegar el flujo de documentos y llamadas API a un ejecutor ligero. De salida, los compactos Muse Ember 1.0, Claude Haiku 5.5 y GPT-6 Luna cuestan los mismos $0.10 por millón de tokens de entrada.

El modelo de Meta obtiene 36 puntos en el índice de inteligencia con un precio de caché de $0.004 por millón de tokens, superando a sus rivales en procesos de negocio aunque quedando por detrás de Haiku en código complejo. Sin embargo, la ventaja decisiva en costos surge solo cuando un prompt largo choca con umbrales tarifarios ocultos.

👍 10
Simon WillisonJulian Goldie SEOArtificial Analysis: Meta Muse Ember Benchmark Analysis
11 de noviembre
Macrofotografía de un microchip de silicio con clústeres activos de expertos iluminados sobre la placa base
NotaIAAutomatizaciónPrácticaBenchmarks

SWE-2 Flash de Cognition: modelo 3 veces más rápido para agentes de código basado en 12 mil millones de parámetros activos

¿Es real triplicar la velocidad de un agente de código para que no se quede colgado en la rutina ni rompa el proyecto? En Cognition respondieron a ese escepticismo lanzando SWE-2 Flash para Devin Desktop y CLI: activando solo 12 mil millones de parámetros de 276 mil millones tras un ajuste fino en tres etapas, el modelo entrega 200 tokens por segundo y logra 89.9% en SWE-bench Pro v2 Hard.

Hasta el 30 de noviembre se puede usar la novedad gratis, aunque en reestructuraciones de arquitectura a gran escala ya cede ante los pesos pesados. Eso sí, por los logros repentinos de la red neuronal buscando vulnerabilidades, sus autores tuvieron que guardar sus pesos bajo llave.

👍 12
Julian Goldie SEOCognition: Devin & SWE-2 Flash Architecture
11 de noviembre
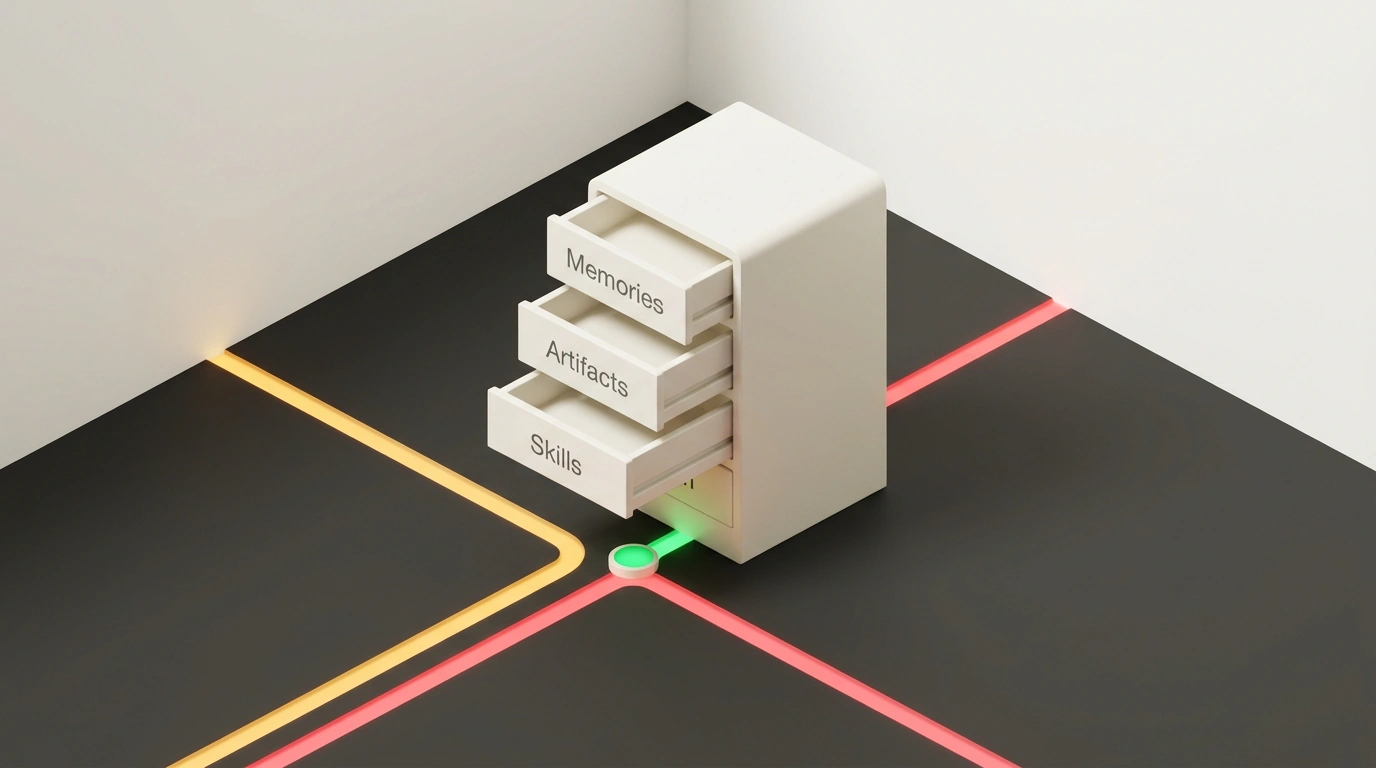
Diorama isométrico de una sala común de ficheros con tres estantes de memoria Memories, Artifacts y Skills
NotaIAAutomatizaciónDatosEficiencia

Memoria compartida para agentes de IA mediante Notion: unificación del contexto de ChatGPT y Claude por el protocolo MCP

Hoy cada red neuronal sabe recordar tus hábitos, pero precisamente eso te encierra dentro de un solo servicio: la analítica de ChatGPT permanece invisible para Claude. El 4 de noviembre de 2026 Notion resolvió este problema convirtiendo el espacio de trabajo en un servidor único de memoria basado en el protocolo abierto Model Context Protocol.

Ahora asistentes de distintos proveedores leen y actualizan bases compartidas de hechos, documentos y habilidades de trabajo sin copiar prompts a mano. Pero ni siquiera un token de integración funcional servirá en chats nuevos si olvidas una línea en la configuración del cliente.

👍 9
Julian Goldie SEONotion: Model Context Protocol & Shared Agent Memory
11 de noviembre
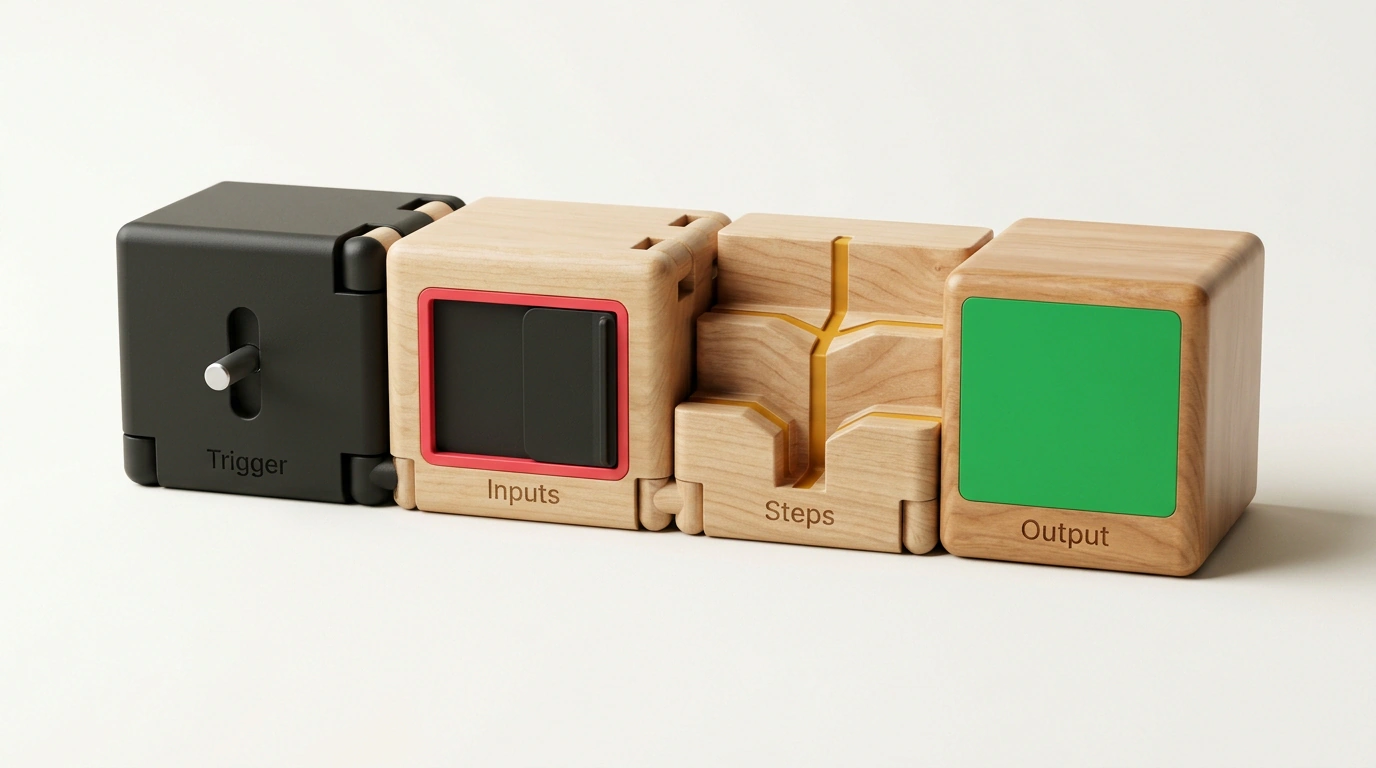
Estructura modular de madera formada por cuatro bloques conectados de un playbook operativo
ArtículoIANegociosGestiónAutomatización

Playbooks operativos en lugar de prompts: metodología para lanzar agentes de IA autónomos en negocios reales

Repartir accesos corporativos a ChatGPT o Claude rara vez acelera el negocio: los empleados pasan horas corrigiendo prompts y cazando a mano invenciones del modelo. La directora de AMP, Rachel Woods, llama a esta trampa «hacer de niñera de la IA»; es inevitable mientras las tareas se planteen en un chat vacío sin reglas de validación.

La salida es pasar los agentes a playbooks operativos de cuatro bloques y al filtro de decisiones «1-3-1», que triplicaron la velocidad de un equipo de 8 personas. Pero sin un freno de emergencia estricto en la entrada, hasta un procedimiento detallado se desmoronará ante la primera celda vacía del informe.

👍 29
Kieran FlanaganAMP: AI Operations Framework & Systems
11 de noviembre
Terminal de consola con una línea concisa de pipeline sobre un fondo de escena tridimensional interactiva flotante
NotaIAAutomatizaciónPrácticaLLM

Lanzamiento de llm-gemini 0.36: soporte del modelo insignia Gemini 4 Carbon en scripts de terminal y CLI

Puedes conectar el modelo insignia Gemini 4 Carbon a tareas de trabajo por dos vías: escribir tu propio envoltorio en Python y copiar respuestas a mano desde el navegador, o integrar la red neuronal directo en un pipeline de consola Unix con el plugin llm-gemini 0.36 de Simon Willison.

En la segunda opción, un comando de terminal con selección de profundidad de razonamiento (low, medium, high) convierte una especificación en texto en un archivo listo con código a la tarifa inicial de $2 y $10 por millón de tokens. Pero desde el 1 de diciembre de 2026 los precios se duplicarán, y para un tipo de proyectos una llamada lineal desde consola ya no basta.

👍 12
Simon WillisonPyPI: llm-gemini plugin package
11 de noviembre