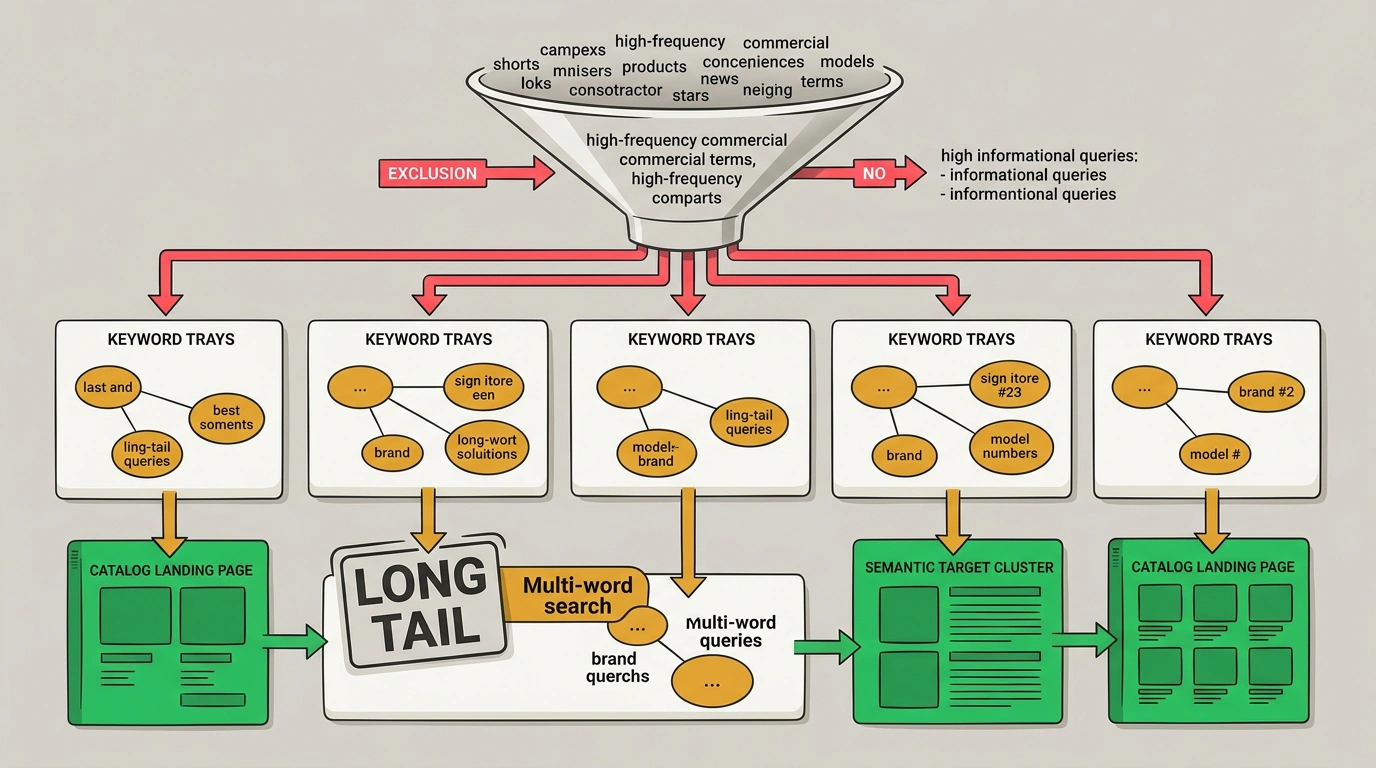
Семантическое ядро e-commerce витрины кардинально отличается от семантики контентных блогов или сайтов услуг. Здесь покупательский спрос дробится на сотни тысяч вариаций: от широких общих фраз до микрозапросов с указанием конкретных артикулов, вольтажа, объема бака, цвета или габаритов.
Фундаментальный принцип успеха партнерского агрегатора заключается в том, чтобы точно классифицировать весь спектр поисковых интентов и сопоставить каждую группу запросов с соответствующим типом посадочной страницы в каталоге.
Классификация поисковых запросов в товарной электронной коммерции
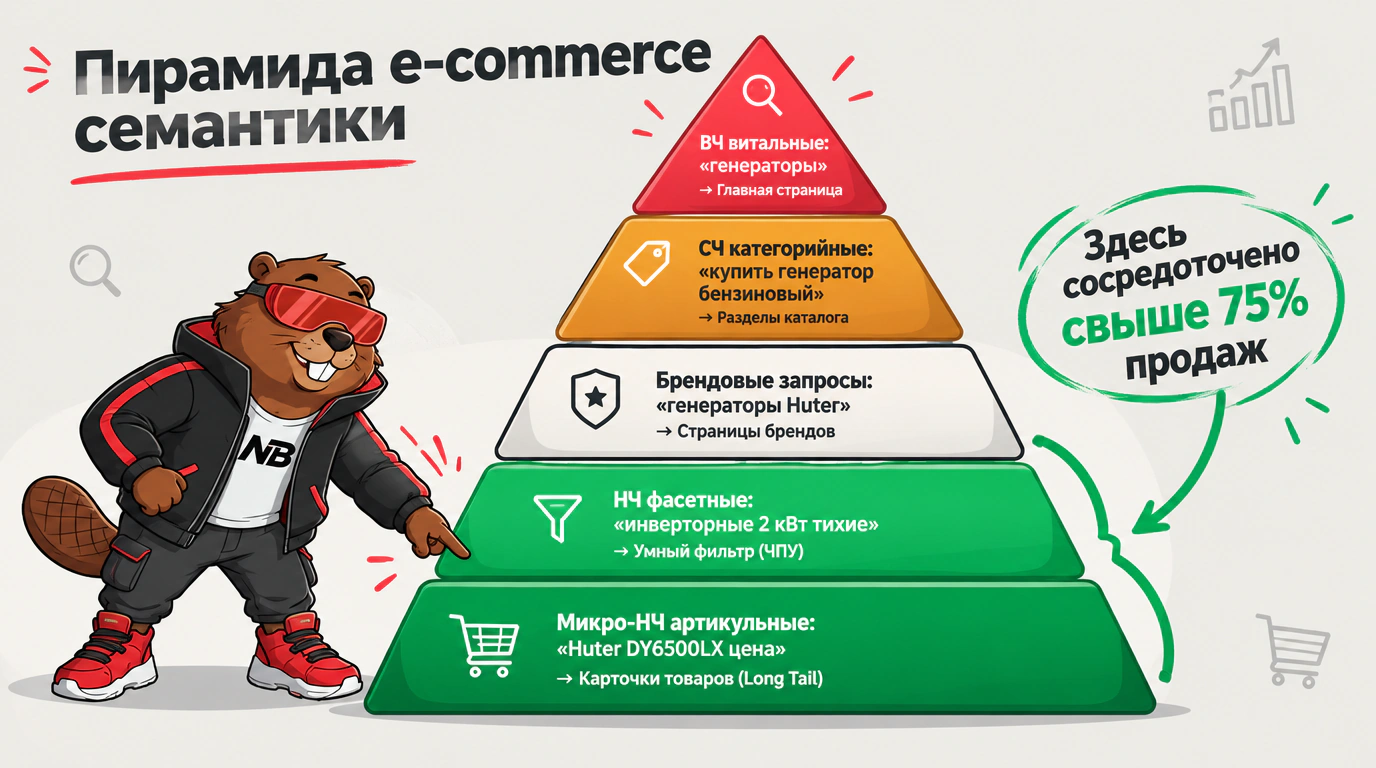
Поисковый спрос в товарной нише делится на пять основных уровней:
| Тип запроса | Примеры запросов | Частотность | Целевая страница на витрине |
|---|---|---|---|
| Высокочастотные витальные (ВЧ) | «генераторы», «инструменты», «мебель» | Высокая | Главная страница сайта |
| Среднечастотные категорийные (СЧ) | «купить бензиновый генератор», «диваны книжка» | Средняя | Листинг раздела / категории |
| Брендовые (Brand intent) | «генераторы Huter», «перфораторы Makita» | Средняя | Страница производителя (бренда) |
| Низкочастотные фасетные (НЧ) | «купить инверторный генератор 2 квт для дачи тихий» | Низкая | Страница умного фильтра / выборка |
| Артикульные и модельные (Микро-НЧ) | «Huter DY6500LX цена характеристики» | Единичная | Детальная карточка товара |
| Информационные (Info intent) | «как рассчитать мощность генератора», «ремонт своими руками» | Разная | Статья в блоге / обзор |
Никогда не объединяйте на одной странице коммерческий (транзакционный) интент («купить инверторный генератор») и информационный интент («как устроен инверторный генератор»). Для коммерческих запросов создаются листинги каталога с ценами и кнопками «В магазин», а для информационных — аналитические статьи блога с обучающим контентом.
Технология сбора и расширения e-commerce семантики
Для построения полного семантического ядра используется комбинация трех источников:
- Базовый парсинг Яндекс Wordstat: сбор частотности основных категорийных маркеров («купить + категория», «категория + каталог / цены»).
- Поисковые подсказки (Search Suggest) Яндекса, Google и Ozon: именно подсказки в поисковой строке маркетплейсов и поисковиков раскрывают живой покупательский язык — устойчивые сленговые термины, популярные сочетания характеристик и ходовые связки свойств.
- Анализ структуры каталогов конкурентов: изучение дерева разделов ведущих агрегаторов и маркетплейсов (ВсеИнструменты, Озон, Яндекс Маркет), позволяющее выявить неочевидные подразделы и группы фильтрации.
Алгоритм кластеризации запросов
Собранный массив фраз проходит кластеризацию по методу поисковой совместимости (Hard/Soft clustering):
- Фразы, по которым в топ-10 выдачи Яндекса ранжируются листинги интернет-магазинов, направляются в коммерческий кластер.
- Внутри коммерческого кластера запросы группируются по признаку привязки: запросы с упоминанием одного свойства идут в фильтр «Свойство» (например, «инверторные»), запросы с маркой — в фильтр «Бренд», а запросы с двумя свойствами — в сложносоставную фасетную выборку («инверторные 2 кВт»).
- Запросы со словами «отзывы», «рейтинг», «как выбрать», «инструкция» отправляются в контент-план информационного блога для последующей нативной перелинковки.
Если две разные категории или страницы фильтра оптимизированы под одинаковые ключевые слова, они начинают конкурировать друг с другом в поисковой выдаче. Это приводит к постоянным колебаниям позиций («миганию») и снижению трафика. Каждая посадочная страница должна иметь строго уникальный поисковый кластер.
Более 75% суммарного объема продаж в CPA-сетях обеспечивают именно низкочастотные фасетные запросы. Чем точнее свойства в фильтре соответствуют поисковым подсказкам из Wordstat, тем быстрее витрина собирает первый конверсионный трафик.