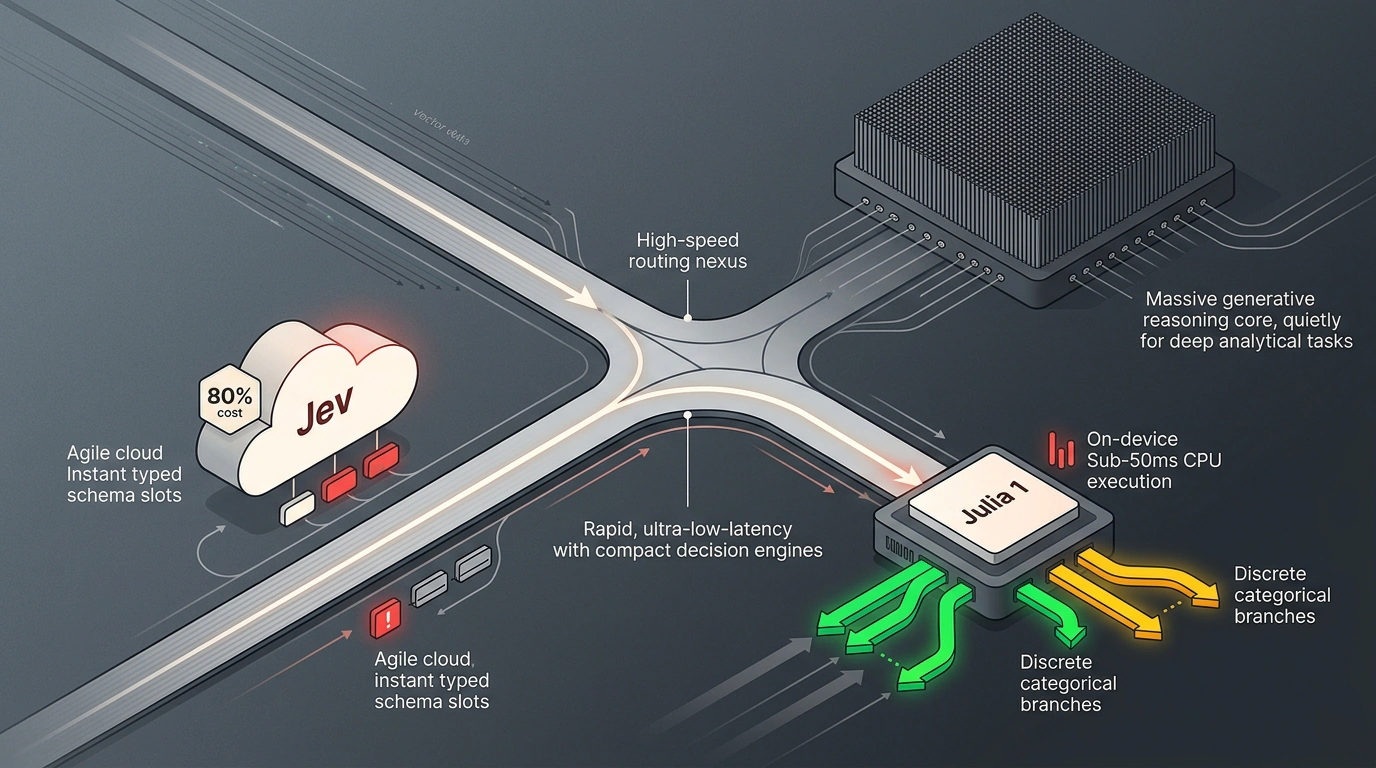
В проектировании автономных агентов долгое время господствовал монолитный подход: для любой операции, будь то сложный рефакторинг кода или проверка категории тикета, вызывалась одна и та же тяжелая модель. В итоге агентные циклы тратили секунды на тривиальные развилки, а разработчики регулярно сталкивались с битыми JSON-ответами.
В сентябре 2026 года в агентной архитектуре оформился новый стандарт — разделение на медленное мышление (System 2) и мгновенные решения (System 1). Специализированные модели не генерируют текст, а выбирают действие из заданного набора за миллисекунды. Два заметных релиза — облачный сервис Jev и открытая модель Julia 1 — наглядно показывают, как быстрый путь решений снижает затраты на API до 80% и ускоряет конвейеры в десятки раз.
Jev
15 сентября 2026 года стартап TypeSafe AI, созданный бывшим исследователем OpenAI Диого Алмейдой, представил модель Jev.
Главная особенность Jev — полный отказ от генерации строк. Модель работает по принципу неавторегрессионного параллельного сэмплирования: входной запрос сопоставляется с заранее заданной строгой схемой типов. На выходе возвращается булево значение, категория или числовая оценка с задержкой 70–500 мс.
Поскольку модель не выводит свободный текст, синтаксические ошибки JSON исключены. Стоимость Jev составляет около $0.04 за миллион входных токенов при бесплатном выводе, что позволяет экономить до 80% бюджета перед вызовом Claude Opus 5.5.
Пример вызова API Jev для классификации входящего инцидента:
import os
import requests

JEV_API_KEY = os.environ["TYPESAFE_JEV_API_KEY"]
headers = {
    "Authorization": f"Bearer {JEV_API_KEY}",
    "Content-Type": "application/json"
}

payload = {
    "context": "Клиент пишет: 'Срочно отмените заказ #98124, деньги списали дважды!'",
    "question": "Определи приоритет и категорию входящего обращения",
    "schema": {
        "priority": ["low", "medium", "high", "critical"],
        "category": ["billing", "cancellation", "technical_bug", "general_inquiry"],
        "requires_human_escalation": "boolean"
    }
}

response = requests.post("https://api.typesafe.ai/v1/decisions", json=payload, headers=headers)
decision = response.json()

print(f"Приоритет: {decision['priority']['value']}")
print(f"Категория: {decision['category']['value']}")
print(f"Уверенность: {decision['priority']['confidence']:.4f}")
print(f"Эскалация человеку: {decision['requires_human_escalation']['value']}")
Julia 1
Если Jev работает в облаке, то релиз Supersonic Labs от 24 сентября 2026 года переносит выбор решений прямо на устройство. Открытая модель Julia 1 на Hugging Face насчитывает 144,3 млн параметров и занимает 550 МБ.
Основанная на компактном энкодере mmBERT-small, Julia 1 оптимизирована под обычные CPU через ONNX Runtime. На чипе Apple M4 модель показывает задержку 33 мс и выполняет до 28 решений в секунду при потреблении менее 400 МБ памяти.
Модель принимает контекст, вопрос и от 2 до 20 вариантов действий, возвращая калиброванные вероятности на 52 языках, что обеспечивает полную приватность локальных данных.
Пример локального запуска Julia 1 через ONNX Runtime:
import numpy as np
import onnxruntime as ort
from transformers import AutoTokenizer

model_id = "supersonic-labs/julia-1"
tokenizer = AutoTokenizer.from_pretrained(model_id)

session_opts = ort.SessionOptions()
session_opts.intra_op_num_threads = 4
session = ort.InferenceSession("julia-1-quantized.onnx", session_opts, providers=["CPUExecutionProvider"])

context = "Пользователь запрашивает экспорт финансового отчета за 3 квартал в CSV."
question = "Какой внутренний инструмент должен вызвать автономный агент?"
candidates = ["export_csv_report", "database_query", "send_email", "trigger_restart"]

inputs = tokenizer(
    [context] * len(candidates),
    [f"{question} [CHOICE] {c}" for c in candidates],
    padding=True,
    truncation=True,
    max_length=256,
    return_tensors="np"
)

onnx_inputs = {"input_ids": inputs["input_ids"], "attention_mask": inputs["attention_mask"]}
logits = session.run(None, onnx_inputs)[0]
probabilities = np.exp(logits) / np.sum(np.exp(logits), axis=-1, keepdims=True)

selected_idx = np.argmax(probabilities[:, 1])
print(f"Выбранный инструмент: {candidates[selected_idx]} (вероятность: {probabilities[selected_idx, 1]:.4f})")
Развитие Jev и Julia 1 завершает эпоху универсальных LLM на все задачи. В современной архитектуре агентов рутинную фильтрацию и маршрутизацию берут на себя модели быстрых решений (System 1), а тяжелые генеративные модели привлекаются только для глубокого анализа и синтеза (System 2). Это устраняет задержки и делает разработку надежных агентов экономически оправданной.